一个指令误导智能模型!北航等首创3D语义攻击框架,成功率暴涨119%
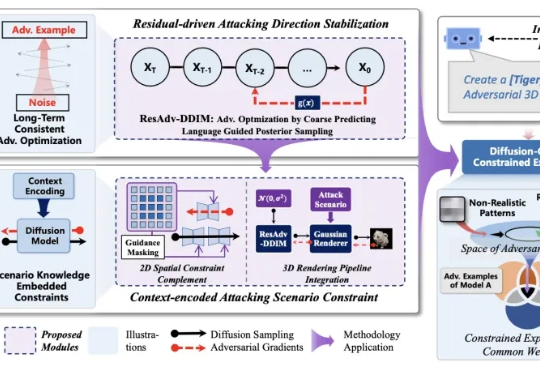
一个指令误导智能模型!北航等首创3D语义攻击框架,成功率暴涨119%人工智能模型的安全对齐问题,一直像悬在头顶的达摩克利斯之剑。 自对抗样本被发现以来,这一安全对齐缺陷,广泛、长期地存在与不同的深度学习模型中。
来自主题:
AI资讯
8502 点击 2025-10-23 16:00

 搜索
人工智能模型的安全对齐问题,一直像悬在头顶的达摩克利斯之剑。 自对抗样本被发现以来,这一安全对齐缺陷,广泛、长期地存在与不同的深度学习模型中。
AI 检测准确率高达 98.9%,也防不住有人给真视频 P 上 Sora 水印。前段时间刷到一个视频,标题就是「中俄混血女明星回应地下室打婆婆传闻」,试问谁看了这个标题能不燃起熊熊的八卦之心?
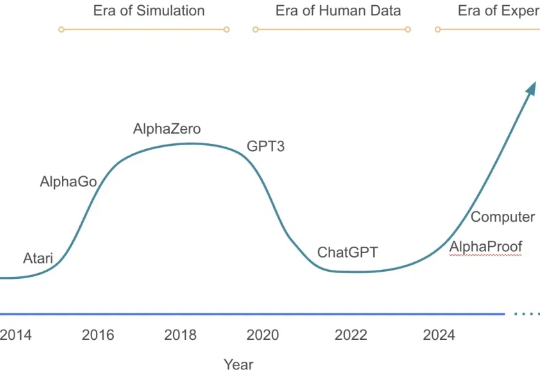
大模型在强化学习过程中,终于知道什么经验更宝贵了! 来自上海人工智能实验室、澳门大学、南京大学和香港中文大学的研究团队,最近提出了一套经验管理和学习框架ExGRPO—— 通过科学地识别、存储、筛选和学习有价值的经验,让大模型在优化推理能力的道路上,走得更稳、更快、更远。
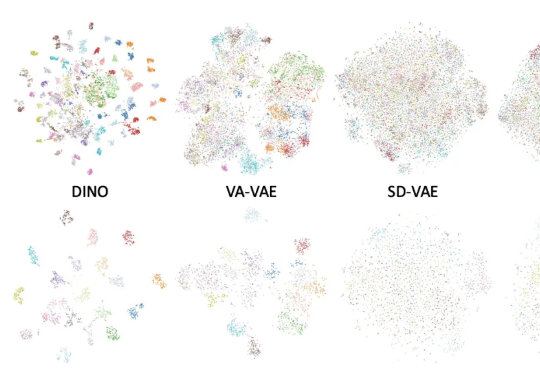
长期以来,扩散模型的训练通常依赖由变分自编码器(VAE)构建的低维潜空间表示。然而,VAE 的潜空间表征能力有限,难以有效支撑感知理解等核心视觉任务,同时「VAE + Diffusion」的范式在训练
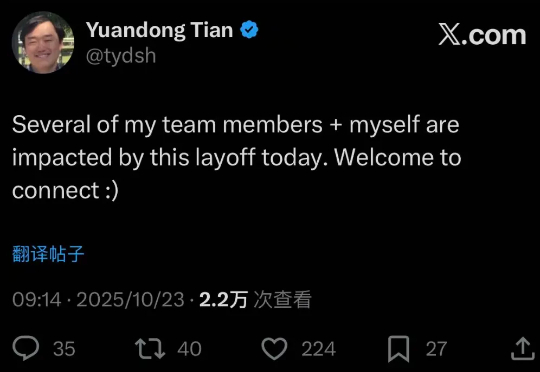
很疯狂,Meta AI裁员能裁到田渊栋头上,而且是整组整组的裁。田渊栋在Meta工作已超过十年,现任FAIR研究科学家总监(Research Scientist Director),他领导开发了早于AlphaGo的围棋AI“Dark Forest”
时隔两月,Baichuan-M2 Plus重磅出世!成为业内首个循证增强的医疗大模型,幻觉要比DeepSeek-R1低3倍,可信度比肩资深临床专家。新模型将「循证医学」理念深度融入训练和推理,通过首创「六源循证范式」,模拟人类医生思维,有效辨别不同层级医学证据、评估其可靠性,并在回答中优先引用高等级证据。
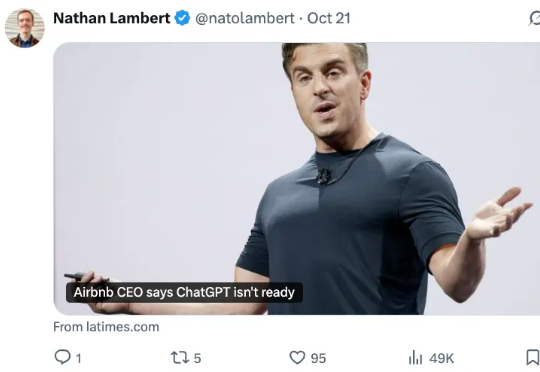
当OpenAI为ChatGPT各种造势时,中国模型也在凭实力圈粉老外。最近,爱彼迎(Airbnb)联合创始人兼CEO Brian Chesky的一番公开表态掀起波澜:要知道Brian Chesky和奥特曼还是挚友,但当涉及自家应用产品整合时,他却没给老朋友留面子,直言OpenAI提供的连接工具还“没有完全准备好”。
AI科学家时代正在到来,哈佛MIT最新推出的ToolUniverse,通过一个统一平台,让AI用自然语言操作600+科学工具,推动科研自动化的全面升级,迎接科学发现新范式。
随着多模态大模型的不断演进,指令引导的图像编辑(Instruction-guided Image Editing)技术取得了显著进展。然而,现有模型在遵循复杂、精细的文本指令方面仍面临巨大挑战,往往需要用户进行多次尝试和手动筛选,难以实现稳定、高质量的「一步到位」式编辑。
香港科技大学KnowComp实验室提出基于《欧盟人工智能法案》和《GDPR》的LLM安全新范式,构建合规测试基准并训练出性能优异的推理模型,为大语言模型安全管理提供了新方向。
年初的 DeepSeek-R1,带来了大模型强化学习(RL)的火爆。无论是数学推理、工具调用,还是多智能体协作,GRPO(Group Relative Policy Optimization)都成了最常见的 RL 算法。
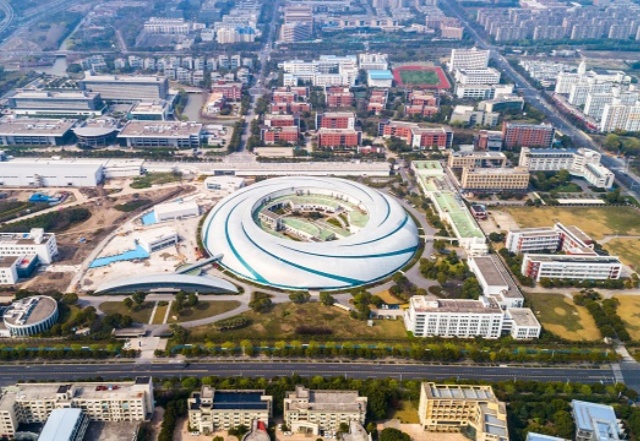
上海前三季度GDP增5.5%,AI制造业增12.8%,成增长引擎。
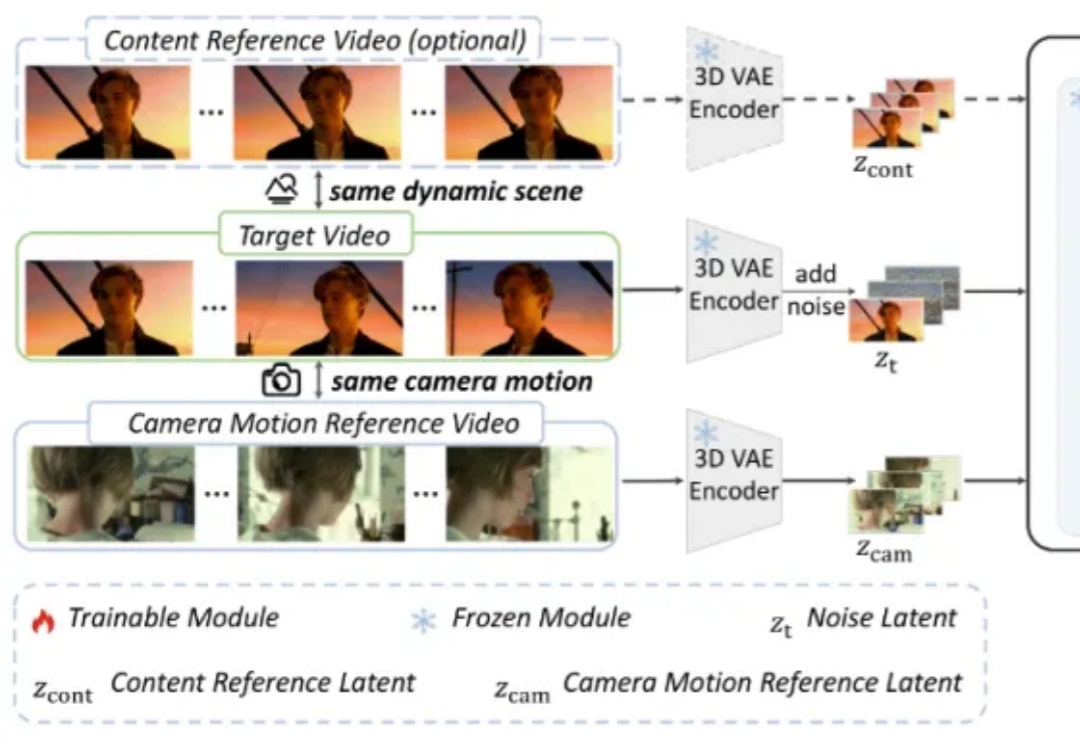
作为视频创作者,你是否曾梦想复刻《盗梦空间》里颠覆物理的旋转镜头,或是重现《泰坦尼克号》船头经典的追踪运镜?

10月23日,AI应用公司LiblibAI宣布完成1.3亿美元B轮融资,由红杉中国、CMC资本及一战略投资方联合领投,多家老股东超额增持。高榕创投曾于2023年联合领投LiblibAI天使轮。 在AI
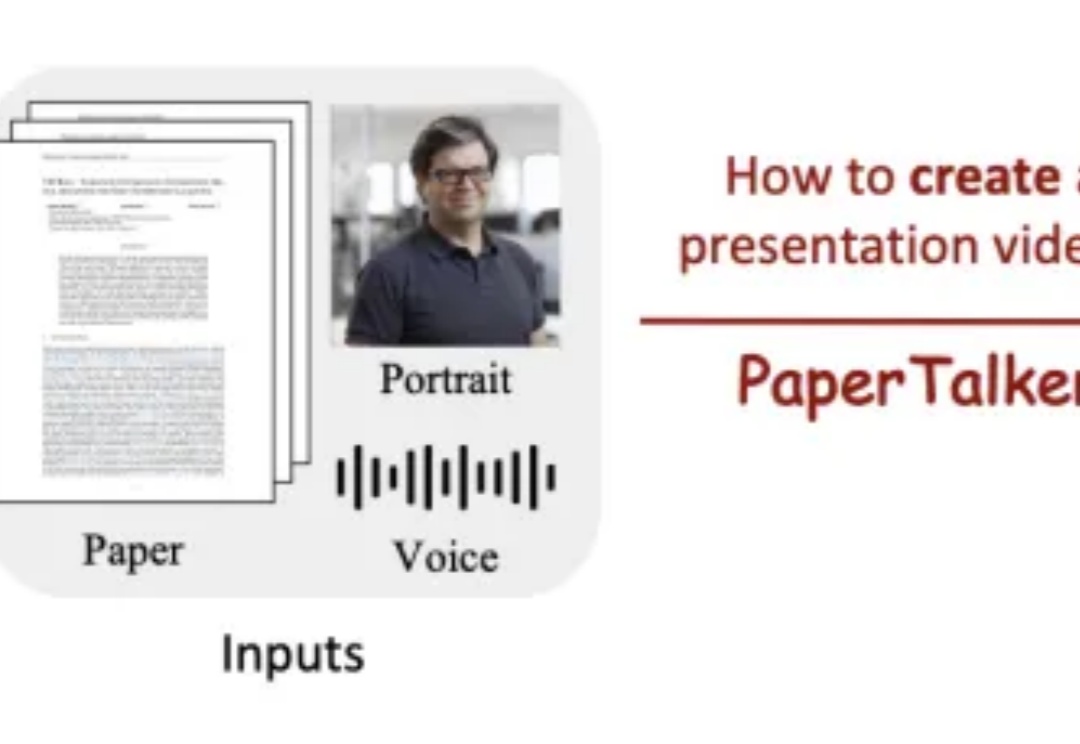
学术展示视频作为科研交流的重要媒介,制作过程仍高度依赖人工,需要反复进行幻灯片设计、逐页录制和后期剪辑,往往需要数小时才能产出几分钟的视频,效率低下且成本高昂,这凸显了推动学术展示视频自动化生成的必要性。
近日,范鹤鹤(浙江大学)、杨易(浙江大学)、Mohan Kankanhalli(新加坡国立大学)和吴飞(浙江大学)四位老师提出了一种具有划时代意义的神经网络基础操作——Translution。 该研究认为,神经网络对某种类型数据建模的本质是:
整个Hugging Face的趋势版里,前4有3个OCR,甚至Qwen3-VL-8B也能干OCR的活,说一句全员OCR真的不过分。然后在我上一篇讲DeepSeek-OCR文章的评论区里,有很多朋友都在把DeepSeek-OCR跟PaddleOCR-VL做对比,也有很多人都在问,能不能再解读一下百度那个OCR模型(也就是PaddleOCR-VL)。

当谷歌用量子计算机窥探到经典世界无法触及的物理秘密时,我们离那个能设计新药、创造新材料的「量子霸权」又近了一大步,下一个诺贝尔奖的种子或许已在此刻种下。
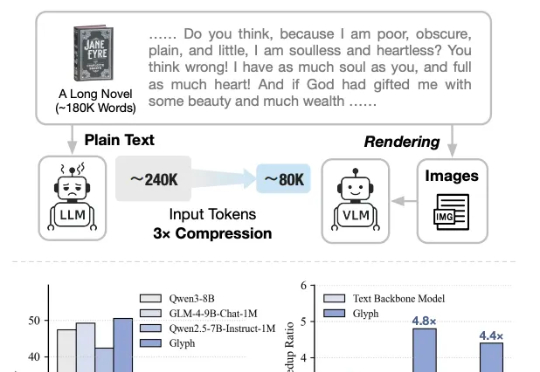
太卷了,DeepSeek-OCR刚发布不到一天,智谱就开源了自家的视觉Token方案——Glyph。既然是同台对垒,那自然得请这两天疯狂点赞DeepSeek的卡帕西来鉴赏一下:
虽然浏览器 AI agent 的概念听起来很美好,但实际构建这样的系统却面临巨大挑战。这正是 Kernel 要解决的核心问题。我发现很多开发者想要构建 AI agent,但却在基础设施层面遇到了各种障碍:性能不稳定、运行时间不可靠、定价不合理、身份认证复杂、权限管理混乱,以及一个本来就不是为 agent 设计的互联网世界。
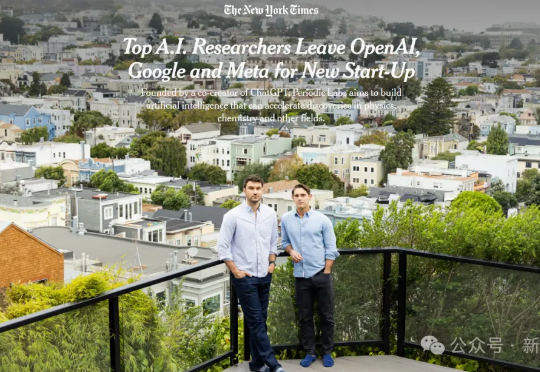
OpenAI前研究副总裁Liam Fedus与DeepMind材料科学领军者Ekin Cubuk共创Periodic Labs,以一轮高达3亿美元的种子融资走出隐身模式,震惊硅谷。然而,曾给出祝福的前东家OpenAI,并未参与本轮投资。
10月21日消息,据最新披露的文件显示,OpenAI正在秘密推进一项名为“水星项目”(Project Mercury)的绝密计划,已招募超过100名前投资银行家,协助训练AI系统构建复杂的金融模型,从而取代初级投行员工耗费大量时间的工作。
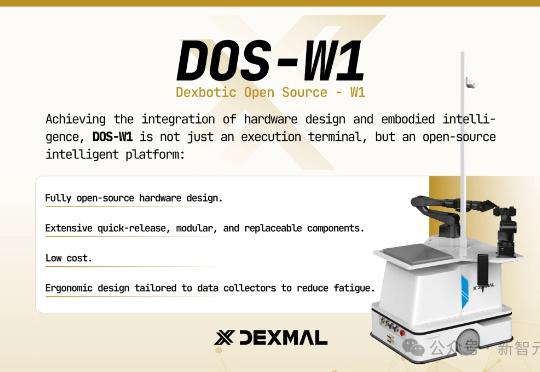
刚刚,这个开源的VLA一站式平台,不仅让UR5e真机实现了100%成功率,还在五大仿真环境中全面领先,最高性能提升高达46%,而且还支持RTX 4090训练!最近,由Dexmal 原力灵机重磅开源的Dexbotic,则构建了一个「VLA统一平台」。Dexbotic作为具身智能VLA模型一站式科研服务平台,可以为VLA科研提供基础设施,加速研究效率。
总部位于东京的人工智能开发商Sakana AI 正与美国和日本投资者洽谈,拟以 25 亿美元的估值融资 1 亿美元,较一年前一轮融资的估值上涨 66%。参与商谈的两位知情人士透露了这一消息。
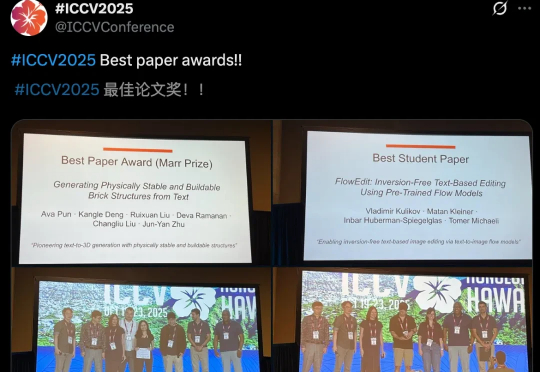
ICCV最佳论文新鲜出炉了!今年,CMU团队满载而归,斩获最佳论文奖和最佳论文提名。同时,何恺明团队论文,RBG大神提出的Fast R-CNN,十年后斩获Helmholtz Prize,实至名归。
视频里,演员们穿着精致的戏服,在片场与工作人员互动、准备拍摄;摄影机、灯光、演员、助理,全都在忙。 就是这样一个 35 秒的「泄露」片段,在社交媒体上迅速疯传,YouTube 相关视频播放量破千万。
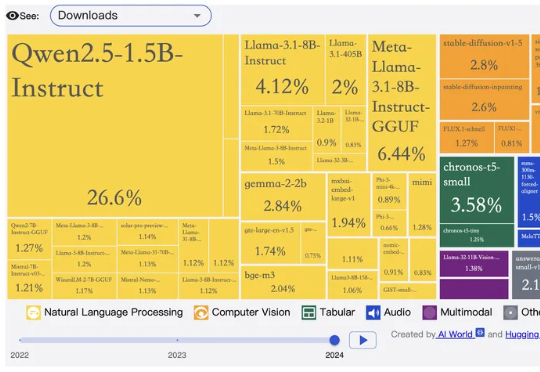
美国 AI 圈开始出现“担心中国开源断供”的苗头了吗?10 月 20 日,在专注于开源模型讨论、拥有 55 万成员的 Reddit 分论坛“r/LocalLLaMA”上,一位网友发布了一则“当中国公司停止提供开源模型时会发生什么?”的提问,并表达了假如中国模型逐渐闭源或开始收费该怎么办的担忧。
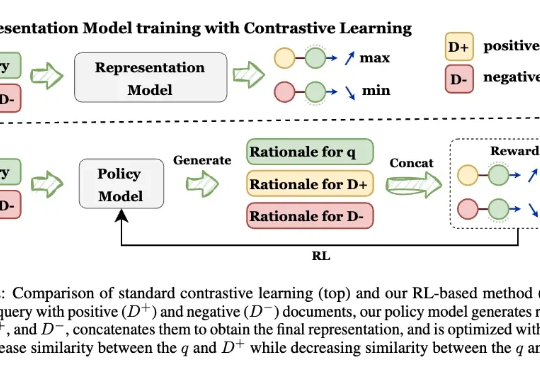
让模型先解释,再学Embedding! 来自UIUC、ANU、港科大、UW、TAMU等多所高校的研究人员,最新推出可解释的生成式Embedding框架——GRACE。过去几年,文本表征(Text Embedding)模型经历了从BERT到E5、GTE、LLM2Vec,Qwen-Embedding等不断演进的浪潮。这些模型将文本映射为向量空间,用于语义检索、聚类、问答匹配等任务。
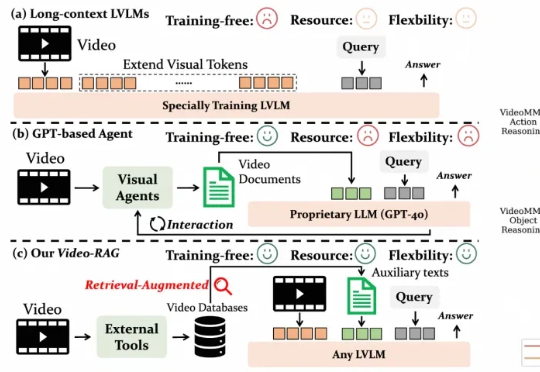
尽管视觉语言模型(LVLMs)在图像与短视频理解中已取得显著进展,但在处理长时序、复杂语义的视频内容时仍面临巨大挑战 —— 上下文长度限制、跨模态对齐困难、计算成本高昂等问题制约着其实际应用。针对这一难题,厦门大学、罗切斯特大学与南京大学联合提出了一种轻量高效、无需微调的创新框架 ——Video-RAG。
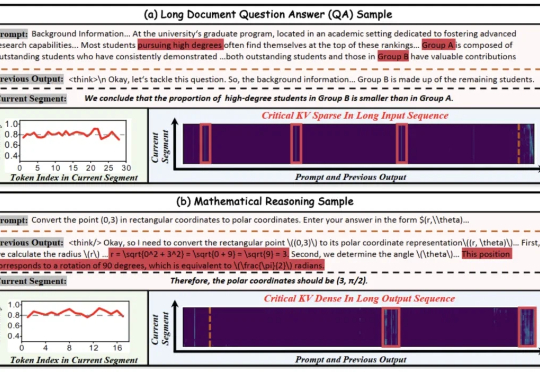
北大华为联手推出KV cache管理新方式,推理速度比前SOTA提升4.7倍! 大模型处理长序列时,KV cache的内存占用随序列长度线性增长,已成为制约模型部署的严峻瓶颈。