
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
「人类造的最后一个 AI」还有多远?OpenAI、Anthropic 等头部厂商进度如何?定义中国 RSI 的 roadmap——前沿 AI 研究机构 Theseus Labs 结合 72 家产业实践,推出「RSI 五级框架」
刚结束的周末,在海外 AI 圈有篇来自中国的 RSI 行业分析报告引起热议。发布仅 10 小时达到百万浏览,binyuan hui、jiachen liu 等多位顶级 AI 研究者与行业 KOL 主动转发推荐,热度还在持续上升中。
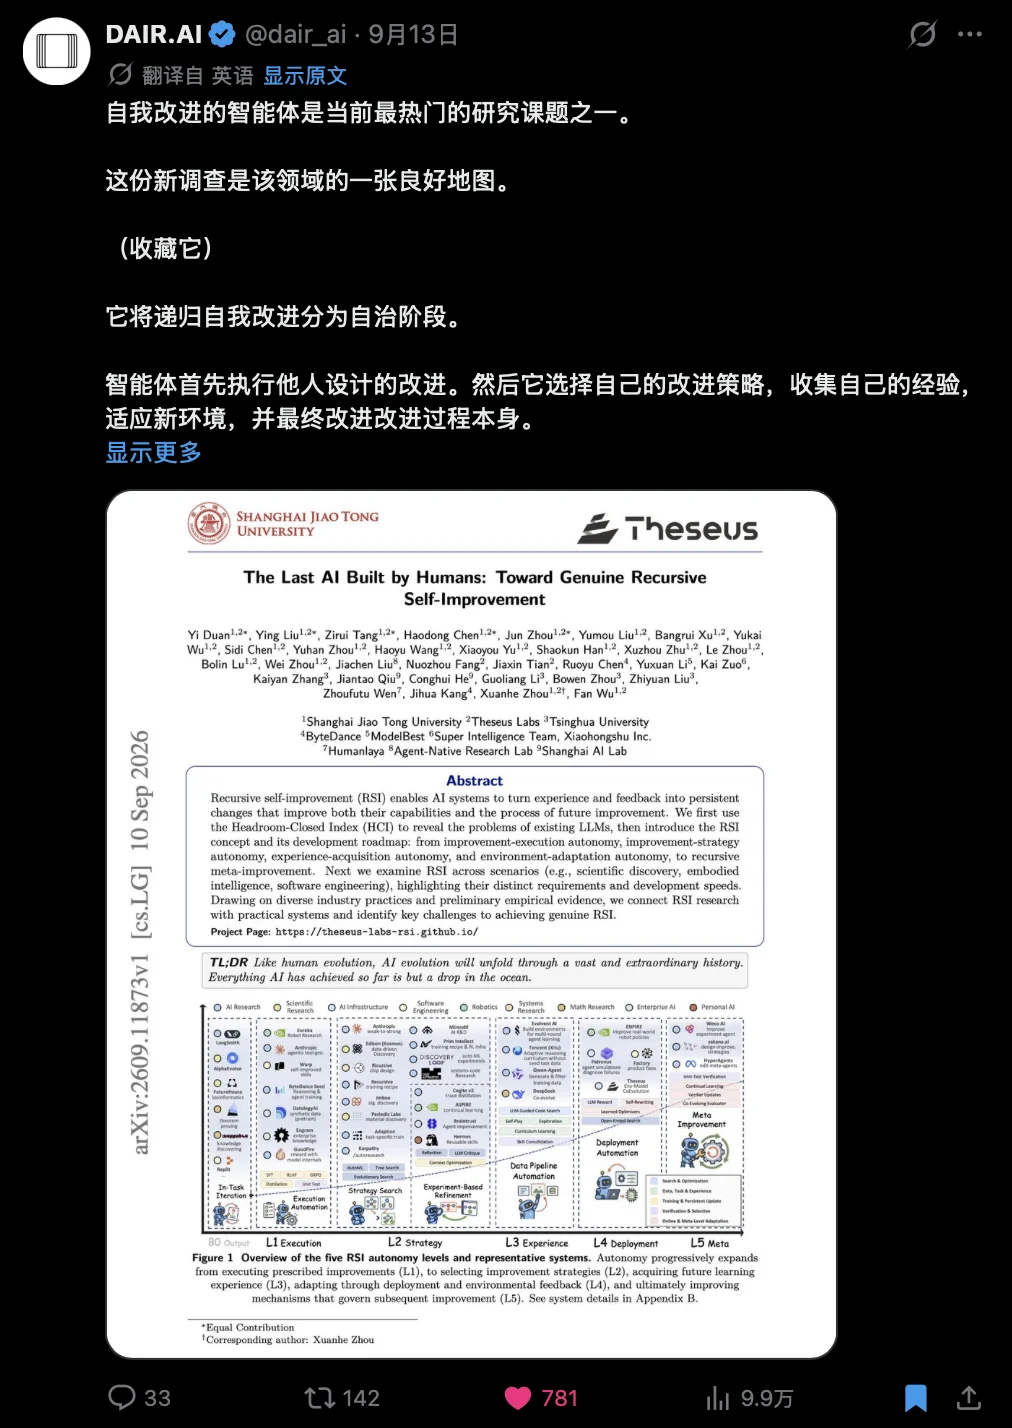
海外知名 AI 媒体 DAIR.AI:自我迭代智能体是当下最热门的研究方向,这份报告是该领域一份清晰的全景地图。
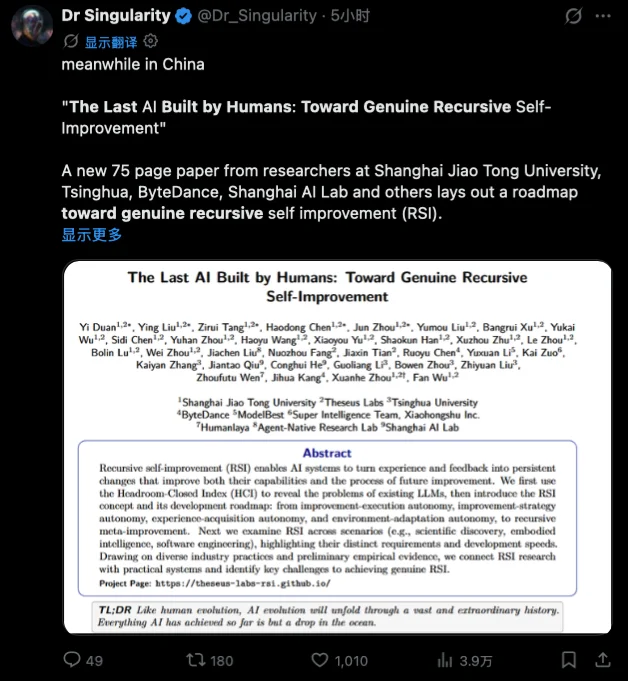
未来主义者 Dr Singularity 评价:中国研究者绘制了通往真正递归自我改进的路线图,探讨「人类构建的最后一个 AI」如何成为可能。
RSI(Recursive Self-Improvement,递归式自我改进)正是今年 AI 圈最热关键词之一。
OpenAI 在组建 RSI 团队,Anthropic 发布《When AI Builds Itself》,Google DeepMind 用 AlphaEvolve 优化自家芯片,Meta 用 AIRA2 做自动研究,腾讯混元用 Hyra 做经验驱动搜索,字节 Seed 让模型进入评测、数据、训练全环节。
全球头部玩家的路线选择已经明显分化:有人从模型权重和训练规则切入,有人从 Harness、记忆和技能库入手,还有人把赌注押在评估器与奖励机制的持续演化上……谁能率先抵达完全体 RSI?
这篇全面定义 RSI 完整路径的 roadmap,出自一家全新的 AI 前沿实验室:Theseus Labs。
核心创始人周煊赫,上海交大计算机学院最年轻 AP(97 年),博士毕业于清华大学。
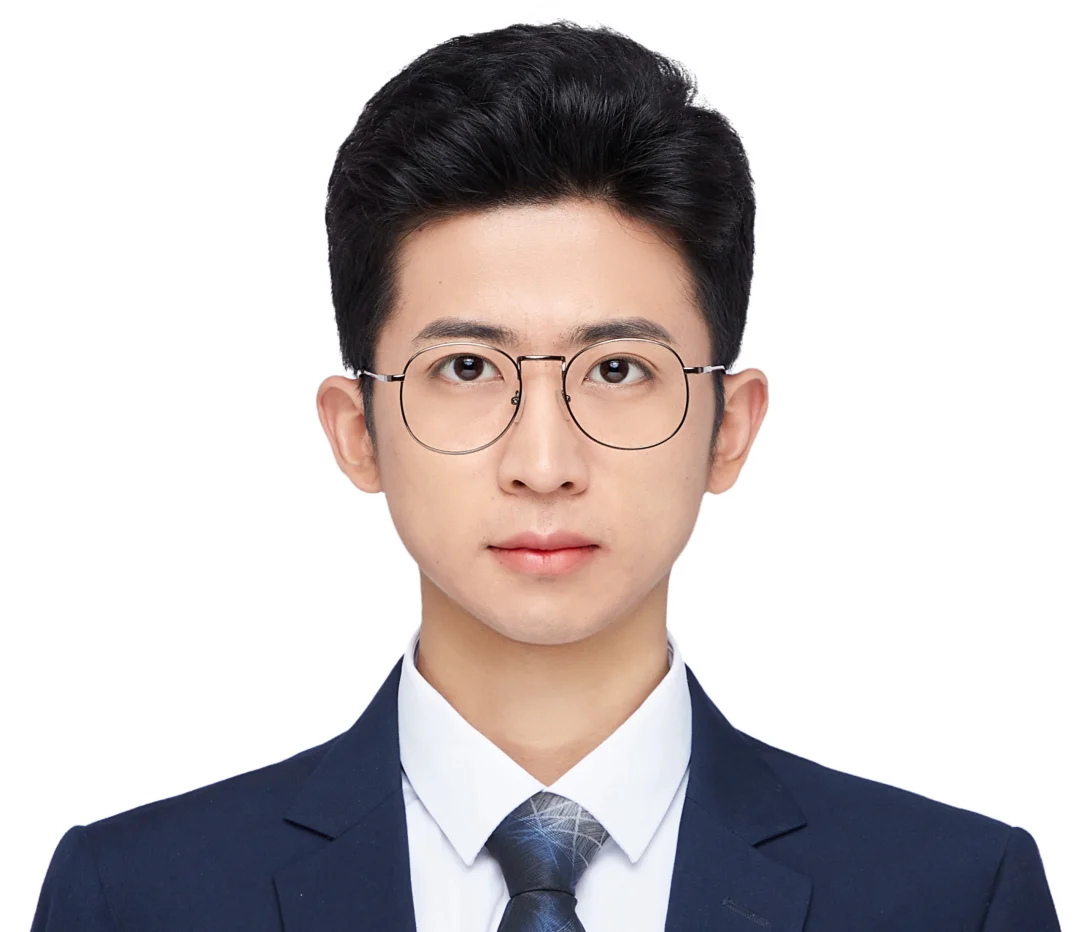
上海人工智能实验室双聘助理研究员,智源青年学者,第四范式、记忆张量技术顾问。
研究聚焦大模型数据治理、自进化理论与智能体记忆,主导多篇近五年 NIPS、VLDB 高被引论文。
获 ACM Jim Gray 博士论文提名奖(大陆高校首位),清华特奖、字节跳动奖学金、微软学者奖学金得主,入选 2026 年人工智能全球最具影响力学者榜单。
研究成果入选卡耐基梅隆大学、康奈尔大学等高校课程,多项项目成果被 OpenAI、字节跳动官方博客引用。
难得的是,Theseus Labs 没有把 RSI 写成一场「智能爆炸」的哲学畅想,而是集合 OpenAI、Anthropic、Google DeepMind、Meta、腾讯混元、字节 Seed 等 72 家公司与团队的公开材料里,一家一家地拆,一条一条地比,最后才给出这套从 L1 到 L5 的自主权路线图。
换句话说,这不是一篇「坐在书桌前想出来的报告」,没有在谈宏大的智能爆炸。
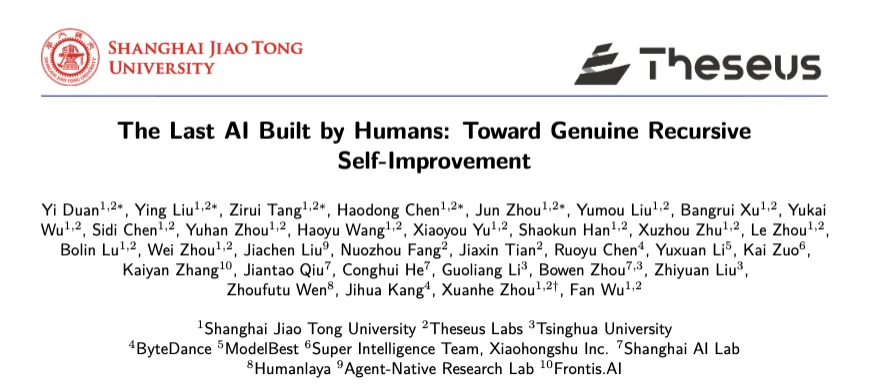
Theseus Labs 联合清华大学、字节跳动、面壁智能(ModelBest)、小红书超级智能团队、Humanlaya、Agent-Native Research Lab、上海 AI Lab、衔远科技等多家学术与产业机构,发布《The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement》。
首次用「改进循环」作为分析单元,系统梳理了 RSI 的技术路线、产业实践和评估挑战。
一句话总结:RSI,终于被拆成了可分级、可度量、可工程化的路线图。
为了客观评估当前大模型离真正的自主还有多远,Theseus Labs 构建了一个新指标:Headroom-Closed Index(HCI,即「能力余量闭合指数」)
HCI 衡量的是:相较于某项评测最初的前沿水平,模型填补了多少通往满分的差距。计算时,以该评测首次纳入数据集那一年模型得分的第 90 百分位作为基准,按「HCI=(当前得分-基准得分)÷(100-基准得分)×100」计算。例如,基准为 60 分、当前为 80 分,HCI 就是 50,表示原有提升空间已被填补一半。汇总某个领域时,先取各评测每年 HCI 的第 90 百分位代表当年前沿水平,再按参与模型数量的平方根加权平均,兼顾覆盖度,同时避免规模最大的评测主导结果。
他们汇集了 2023 年至 2026 年间,覆盖 10 大能力领域的 393 组模型与基准测试观测。
通过将各基准首年前沿设定为 0 分、满分设定为 100 分,HCI 统一了不同测试的量纲,回答了一个最本质的问题:
在各大领域,模型距离人类天花板究竟还差多少「剩余空间」?
数据结果给出了一个极具反差的图景:截至 2026 年,前沿数学的 HCI 已达 86.4,研究生级科学为 85.8,广博知识 77.2。
然而,法律推理仅 64.5,多模态推理 62.2,前沿学术广度 60.4。
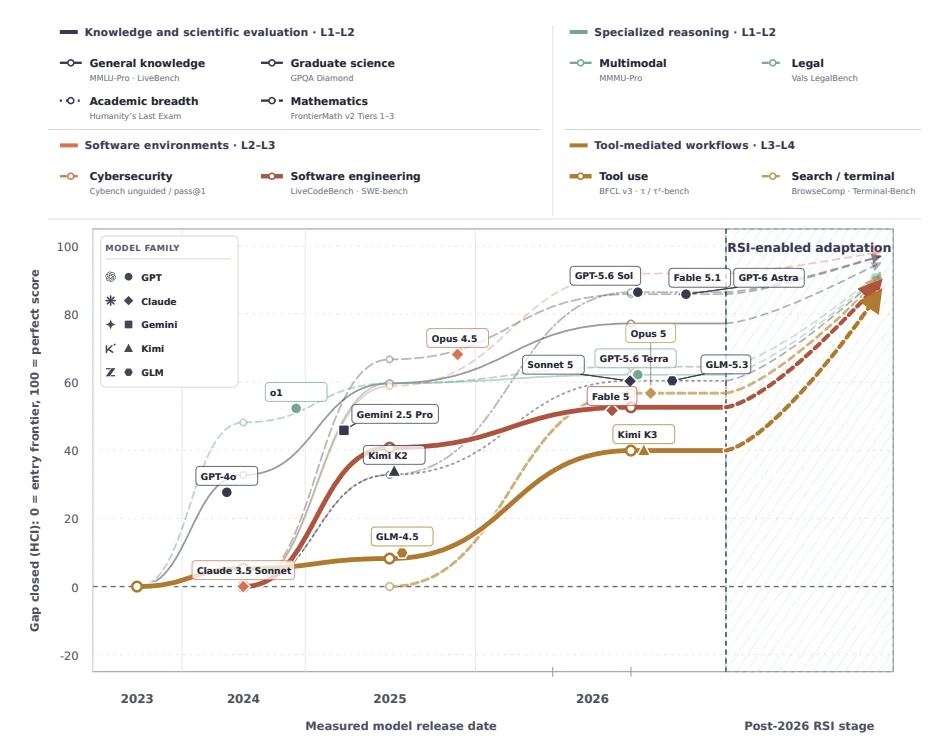
坦言说:模型在「标准化考试」上快摸到顶了,但在「真实任务执行」上才刚刚起步。
HCI 的用意并非给模型排座次,而是作为一张诊断图,指明哪些领域的「剩余空间」最丰厚,也正是 RSI 未来最应该发力去啃的硬骨头。
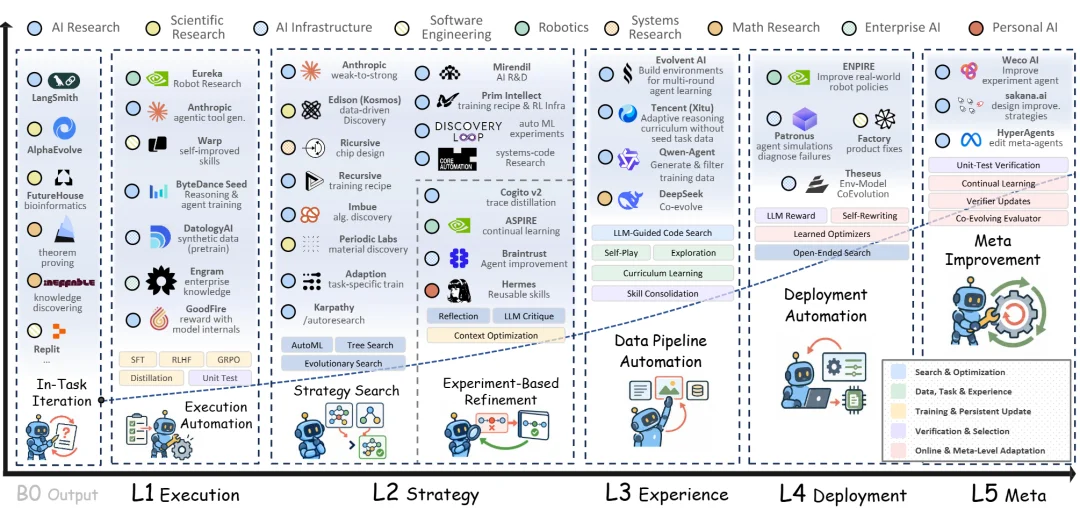
基于此,Theseus Labs 按 AI 在改进循环中承担的责任,发布 RSI 五级框架,首次系统定义「递归自我改进」。
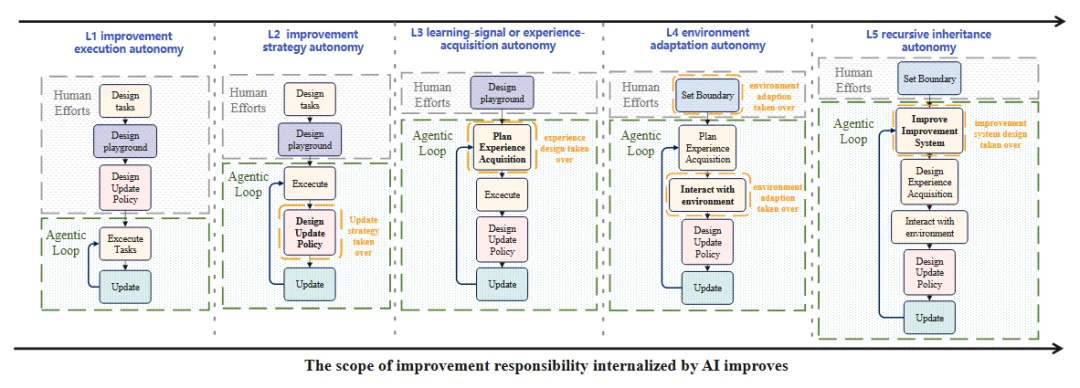
L1 执行自主:人类投入——设计任务、设计试验环境、设计更新策略;智能体闭环——执行任务、更新。
L2 策略自主:人类投入——设计任务、设计试验环境;智能体闭环——执行、设计更新策略、更新;更新策略由系统持久化沉淀。
L3 经验获取自主:人类投入——设计试验环境;智能体闭环——规划经验获取、执行、设计更新策略、更新;经验设计由系统持久化沉淀。
L4 环境适应自主:人类投入——设定边界;智能体闭环——规划经验获取、与环境交互、设计更新策略、更新;环境适应由系统持久化沉淀。
L5 递归继承自主:人类投入——设定边界;智能体闭环——改进改进系统、设计经验获取、与环境交互、设计更新策略、更新;改进系统设计由持久化沉淀。
沿着这五级阶梯看,大厂目前主要集中在 L1–L2,如:
向 L3 迈进的:腾讯 R-Zero 自主出题、求解,开始减少对人工准备学习任务的依赖。
到了 L4,Factory Signals、作为候选的 OpenAI 自改进税务智能体,着力把部署中的失败转成后续更新,缩短「发现问题—修复—验证」的链路。
至于 L5,Meta HyperAgents、Sakana Darwin Gödel Machine、Weco AIDE2 尚属候选,Anthropic 的《When AI Builds Itself》仍是目标愿景:
这一阶段真正值得期待的,是每轮进步不仅让 AI 更能干,还能让下一轮改进更高效、更可靠;但这种持续递归的收益,目前仍缺乏充分验证。
「不」
关键在于改进机制本身是否在同等预算和独立评估下产生更强后代。
L1—L4 主要是在既定改进机制下提升任务能力,而 L5 的「决定后续改进的机制」,才可能触及有效递归。
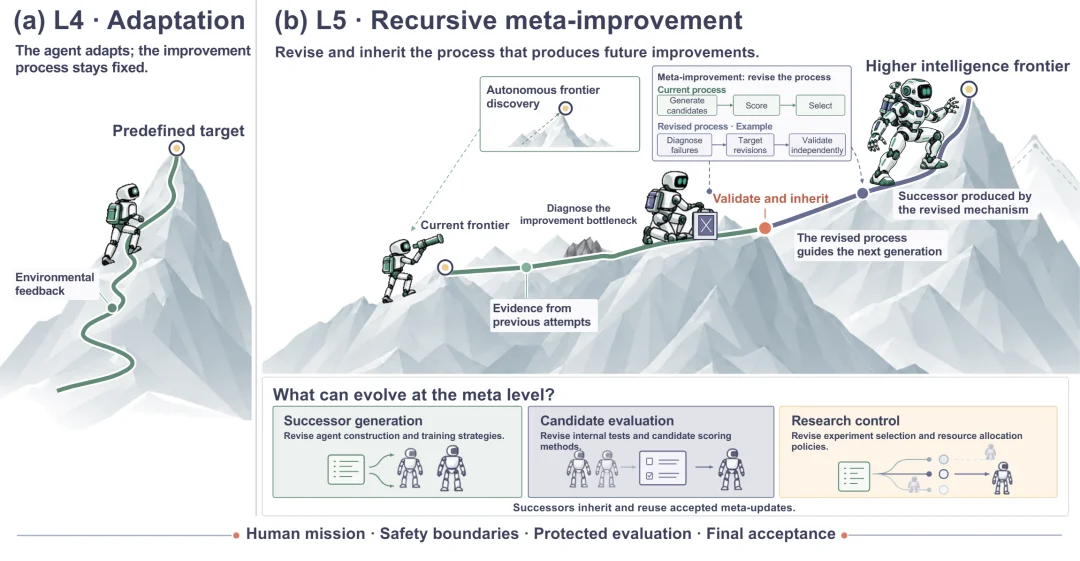
若把能力提升比作登山,L4 使用既定改进方法,适应环境完成目标;
L5 则会关注登山方法本身:自主发现能力前沿,思考受阻原因,选择更值得尝试的路线,并把经过验证的新方法传给下一代继续使用和改进。
能否真正提升,需要在同等预算下通过独立评估来确认,不能仅靠自我修改或自评分来改进。
关键在于让有限的算力和人类,投入并产生更多有效的改进。但总体目标与安全边界仍由人类把关。
在对 HCI(能力余量闭合指数)的三项观察中,最让人警醒的是「交互类能力」的严重滞后。
以 2026 年数据为证:软件工程 HCI 仅为 52.6,搜索与终端 Agent 为 56.8,而工具调用 Agent 更是低至 39.9。相比之下,研究生级科学 HCI 高达 85.8,两者相差 33 到 46 分。
这里值得注意的是,工具 Agent 的得分在年内实现了从 8.2 到 39.9 的猛涨,但仍处于全场最低位;而同步领先的网络安全 Agent 已触达 91.9 的高度,两者相差 52 分之多。
这说明,在「边界清晰、容易验证」的环境里取得的测试增益,并不能自动迁移到「长程/有状态」的真实工作流中。
Theseus Labs 强调:简单的测评主要锻炼 L1–L2 的能力,环境类任务对应 L2–L3,而只有长程交互工作流,才能真正暴露出系统在 L3–L4 阶段所需的「验证、记忆、适应」能力。
那么,RSI 究竟能带来多大的增量?
Theseus Labs 给出了一个示意性的延伸公式:R = 100 - 0.22 × (100 - 2026 年 HCI)
简单来说,就是假设 RSI 能按目前这个效率(0.22 的系数)填补缺口,各领域的理论上限能摸到哪。
测算结果较为可观:网络安全可从 91.9 提升至 98.2,软件工程可从 52.6 跃升至 89.6,搜索与终端从 56.8 提升至 90.5,工具 Agent 更是能从 39.9 直接拉高到 86.8。
为什么 RSI 能补上这个缺口?
因为「干活」需要长程交互、反复试错、回归测试,这正是 RSI 在积累经验 & 验证更新的强项。
也就是说,现有能力缺口越大的领域,能从 RSI 中获得的潜在提升红利就越高。
务实结论随之而来:反复生成经验、验证更新、做回归测试,最能帮助那些「部署工作流薄弱」的环节。
这是工程上最容易切入和落地的入口。
发现软件工程和工具使用型 Agent 的 HCI 剩余空间,仍然很大。
距离能力天花板最远,RSI 的杠杆效应最强。
在工业实践部分,Theseus Labs 梳理了 Theseus、Lark、Humanlaya、ModelBest、腾讯混元、Agent-Native Research Lab 等系统的初步探索。
如:
这些数字说明:RSI 不是纯理论,产业界已经开始跑了。
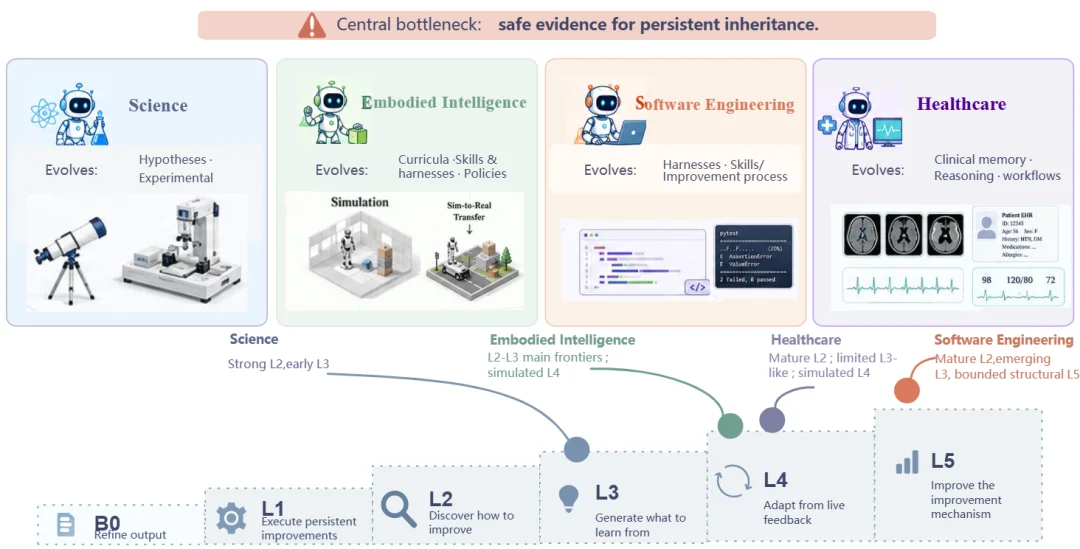
科学发现、具身智能、软件工程、医疗
除厂商外,Theseus Labs 还比较了 4 个实际领域,明确指出不同的领域正以不同的速度向 RSI(递归自我改进)迈进:
软件工程进展最远,而科学、机器人技术和医疗保健则更为受限,因为反馈更难或更冒险地验证。
「反馈成本」「可验证性」「部署约束」决定了 RSI 的进展速度。
报告在 L5 评估中强调:真正的递归改进,不能只看一次成功。
还要问:
这四问,决定了 RSI 是「一次性刷榜」,还是可持续的改进能力。
读完他们的文章,也想再聊聊这家年轻的 lab。
在 RSI 领域,Theseus Labs 有抛出自己的解法吗?
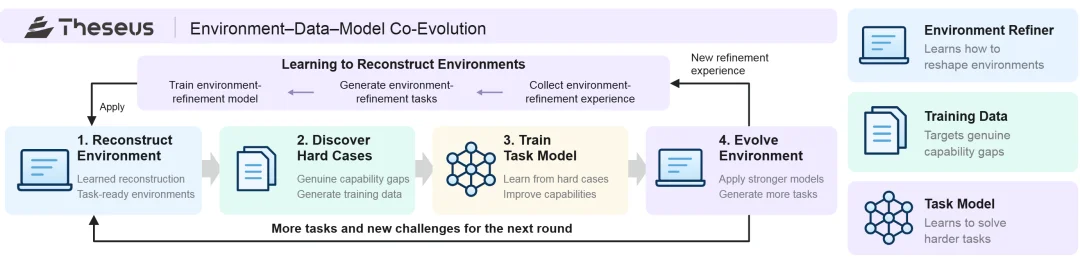
有,而且非常直观:
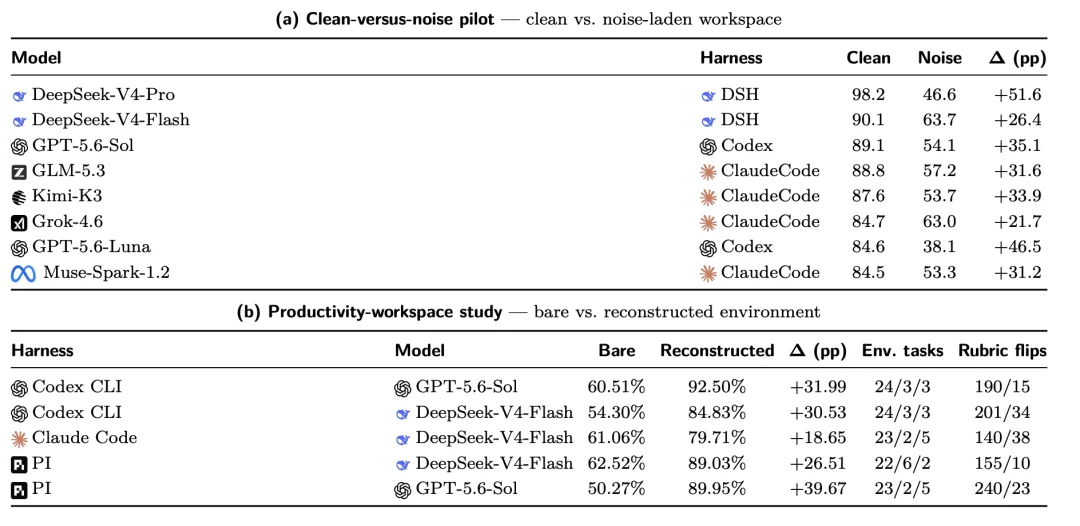
最终,在 30 个生产力任务、547 项评分细则上,五组最新基模和 harness 配置下,都取得了性能跃迁。
报告标题里的「Last AI Built by Humans」其实是一种提醒:
「也许,人类建造的最后一个 AI,并不是某个瞬间诞生的超级智能,而是一粒学会自己添柴、自己校准、自己记住来路的火种」。在仰望星空,也切记脚踏实地。
人类一生都在致力于把「经历」变成「成长」,相信 AI 的自进化也如此。
每一次被验证的改进,都是下一轮探索的起点。
让智能增长形成杠杆,让有限资源撬动持续跃迁。
这是 Theseus Labs 的目标。
文章来自于"机器之心",作者 "机器之心"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
