在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?
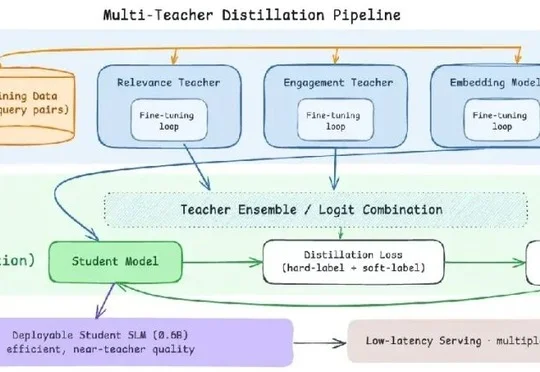
在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
搜索
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
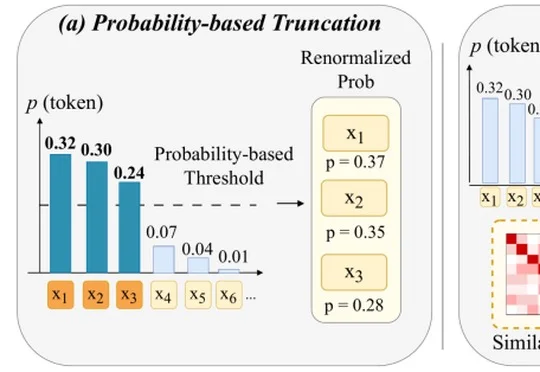
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
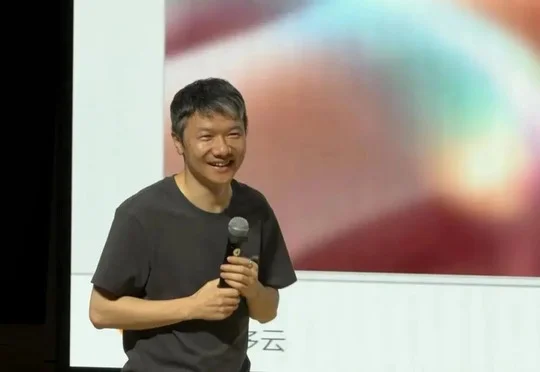
米哈游创始人刘伟(大伟哥)在上海交大校招宣讲会上表示,已为蔡浩宇主导的大模型研发划定1000亿元投入上限,承诺未来2至3年内米哈游将成为国产大模型团队举足轻重的力量,并强调绝不做垃圾项目。
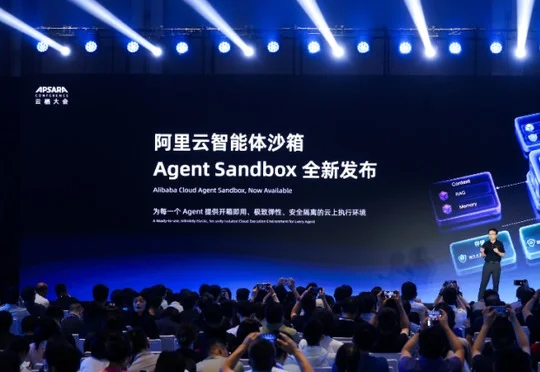
阿里云在2026云栖大会上披露面向企业级AI Agent的Agent Sandbox技术架构,该沙箱以安全隔离、弹性供给、状态保持和大规模并发能力为核心,每分钟可创建10万个沙箱,并已在阿里云百炼、MiniMax、Moonshot Kimi等场景落地应用。
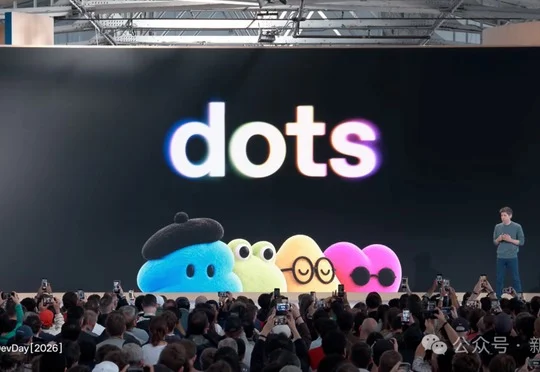
OpenAI开发者大会发布全天候在线Agent"dots"、旗舰模型GPT-6.1 Sol及500美元Pro套餐,Codex搬上云端,ChatGPT升级为AI原生协作空间。
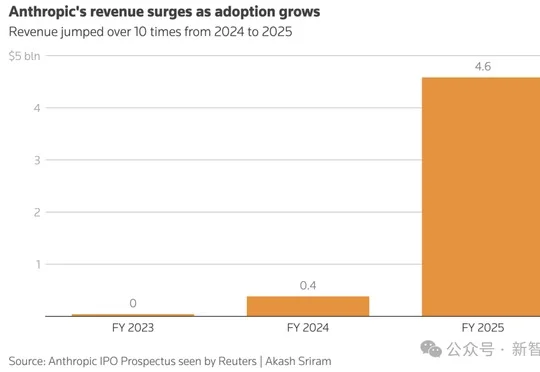
Anthropic招股书披露,其背负未来5180亿美元算力与基建长期支出承诺,2025年营收近46亿美元却净亏约420亿美元,公司正冲击或超2万亿美元的IPO估值,但客户集中度高且订单缺乏长期合同保障,能否撑住天价估值取决于收入增长能否持续跑赢算力成本。
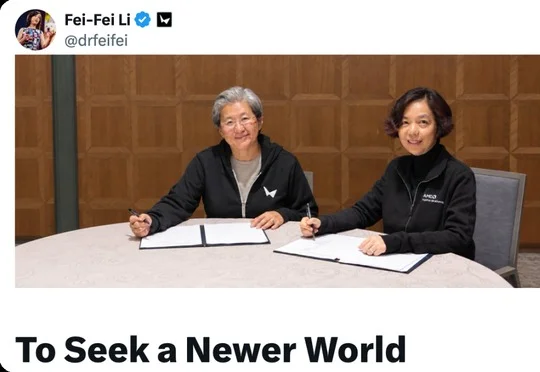
AMD 宣布以约 82 亿美元(折合人民币约 550 亿元)全股票方式收购李飞飞创立的 World Labs,交易完成后李飞飞将出任 AMD 执行副总裁兼首席科学家,双方将围绕空间智能模型研究与算力生态展开深度合作。
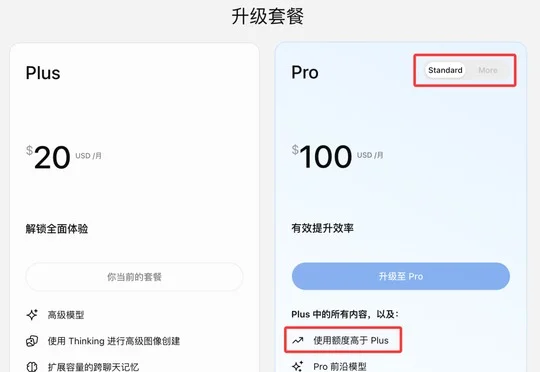
OpenAI对ChatGPT定价页面进行静默修改,将Pro方案更名为Pro Standard和Pro More并删除5x和20x用量倍数承诺,代码仓库泄露新增500美元/月的Pro Max方案,引发社区对透明度下降和现有用户权益隐性降级的争议。
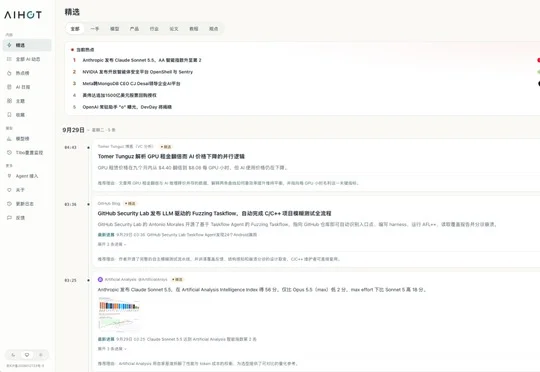
AIHOT开发者卡兹克正式开源月活百万的AI热点资讯网站AIHOT,并上线利用Claude Opus 5.5等模型重写的AIHOT 2.0版本,以便法律、金融、HR等各行业用户基于该开源框架构建属于自己的行业热点监控产品。
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。