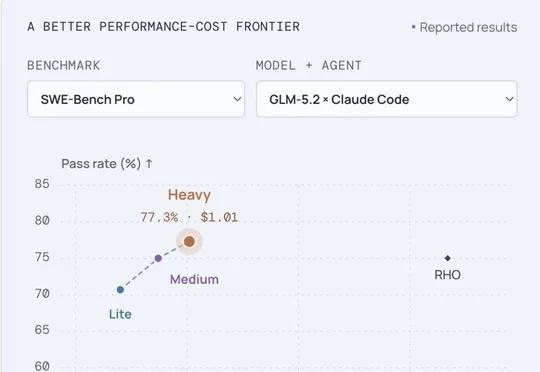
智谱唐杰署名RSI新成果开源!Agent自我进化成本还狂降53%
智谱唐杰署名RSI新成果开源!Agent自我进化成本还狂降53%智谱唐杰团队发布并开源无标签递归自我改进框架HarnessPro,在SWE-Bench Pro等基准提升通过率的同时,将单任务平均成本降低53.0%。
来自主题: AI技术研报
9520 点击 2026-10-24 13:44

 搜索
智谱唐杰团队发布并开源无标签递归自我改进框架HarnessPro,在SWE-Bench Pro等基准提升通过率的同时,将单任务平均成本降低53.0%。
Anthropic与Theorem合作,让Claude为123个开源库的239个测试入口完成形式化验证,产出约1.8亿行经机器检查的证明代码并发现数百个Bug,实现其已知首次大规模汇编层生产软件形式化验证。
无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
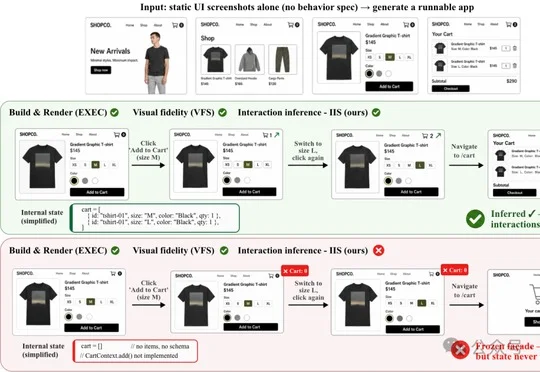
港科广新基准UI2App以600张静态截图评测模型推断并实现应用交互的能力,Gemini 3.1 Pro Preview以73.2分获视觉还原第一,但Claude Sonnet 4.6以36.8分居交互推断首位,跨页面状态仍是参评模型共同难点。
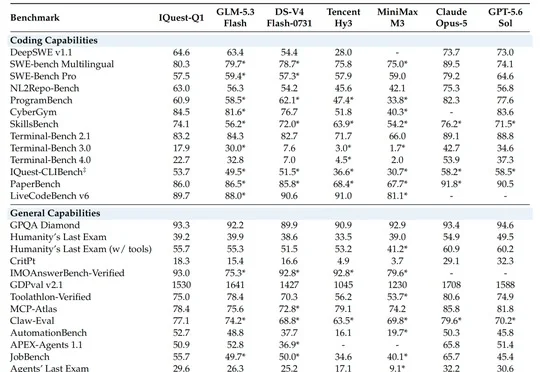
至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
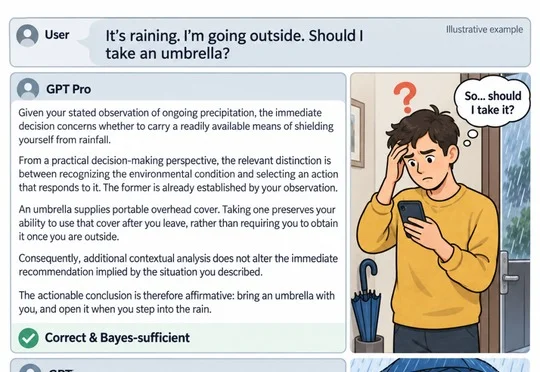
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
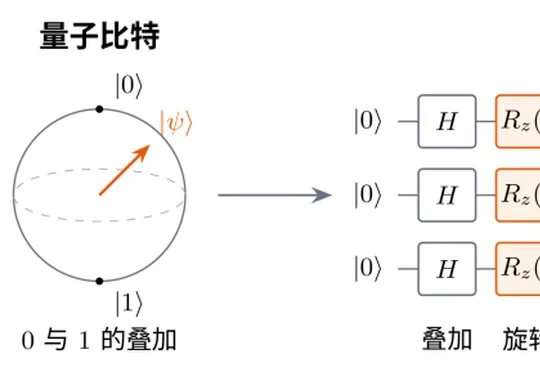
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
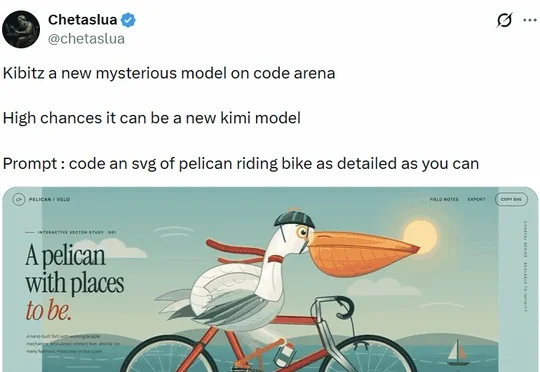
月之暗面正式推出 Kimi K3.1 Pro,认领匿名模型 Kibitz,以3万亿参数和100万token上下文强化Agent、前端与3D创作,并同步上线高速版,完整权重将于11月4日前发布。
上海交大00后团队创办的芯生代完成数千万元种子轮融资,计划让Agent为不同模型、芯片和场景生成可自我迭代的定制推理引擎,其EvoKernel框架已将昇腾算子生成正确率从4%提升至83%。
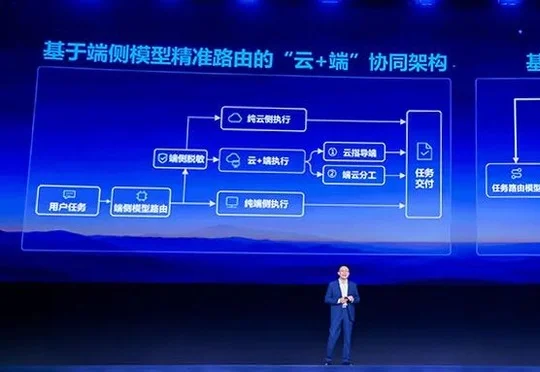
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。