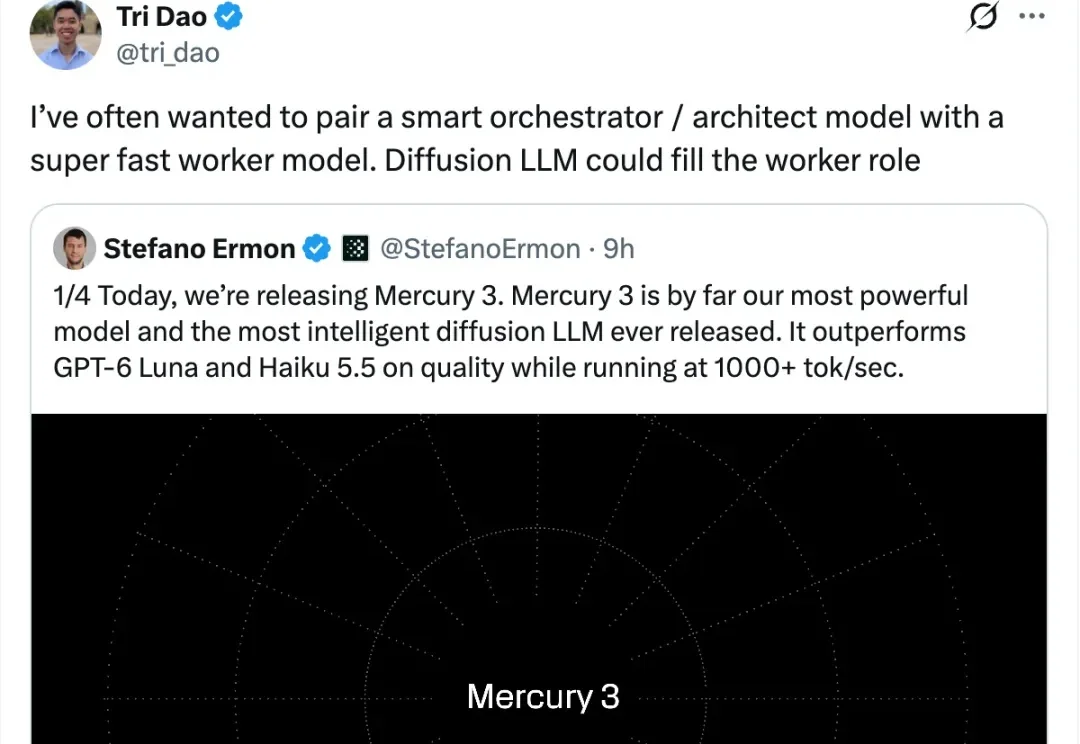
比GPT-6 Luna快8倍!扩散LLM跑分也反超了
比GPT-6 Luna快8倍!扩散LLM跑分也反超了GPT-6 Luna 要被扩散 LLM 抢饭碗了?
来自主题: AI资讯
8133 点击 2026-10-26 11:13

 搜索
GPT-6 Luna 要被扩散 LLM 抢饭碗了?
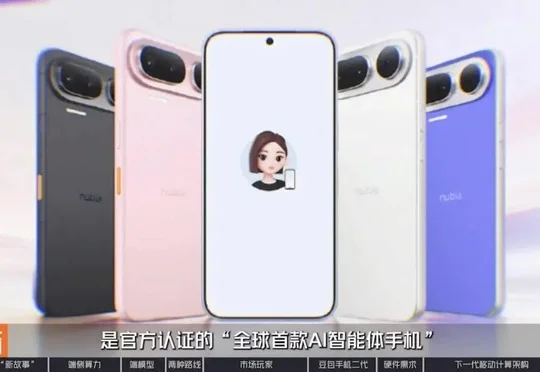
在换机周期拉长、端侧AI与端云协同加速成熟的背景下,苹果、谷歌、OpenAI及国内厂商竞逐智能体手机入口,努比亚NaviX Ultra以豆包手机助手实现跨App操作,高通发布第六代骁龙8至尊版和超级至尊版强化智能体计算能力。
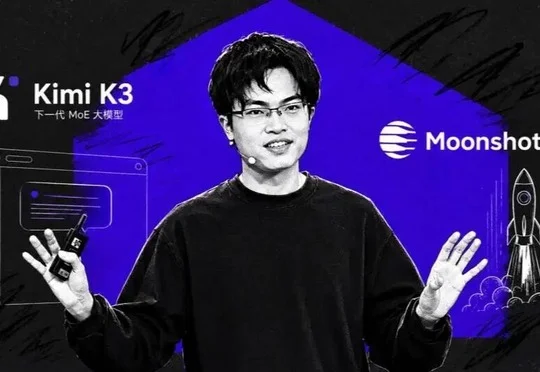
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
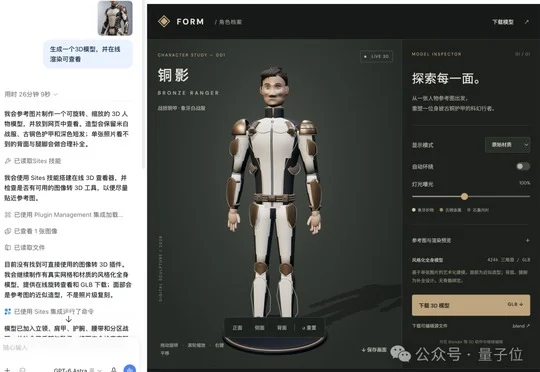
Hi3D正式开放V1.0模型代码,这款基于Sparc3D、约用200万个3D资产训练的国产可商用模型支持研究与部署,最新V3.0达到2048³分辨率并由Hi3D Agent用于3D创作。
Anthropic与Theorem合作,让Claude为123个开源库的239个测试入口完成形式化验证,产出约1.8亿行经机器检查的证明代码并发现数百个Bug,实现其已知首次大规模汇编层生产软件形式化验证。
无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
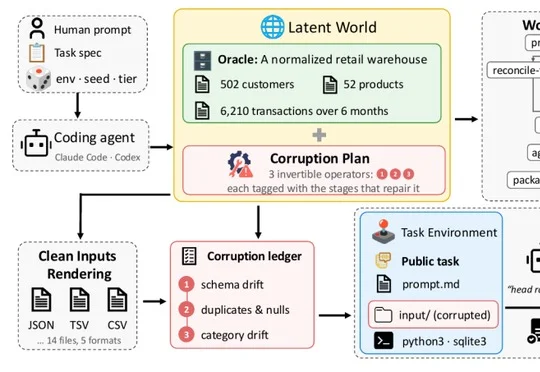
Adobe Research与UCLA提出Tev,构建含1170个环境、覆盖7个领域的Tev-Gym并提出进度势能奖励塑形(PPRS),训练出的Tev-27B在ALE-CM的Pass@5达0.28,与GPT-6 Astra、Claude Opus 5持平。
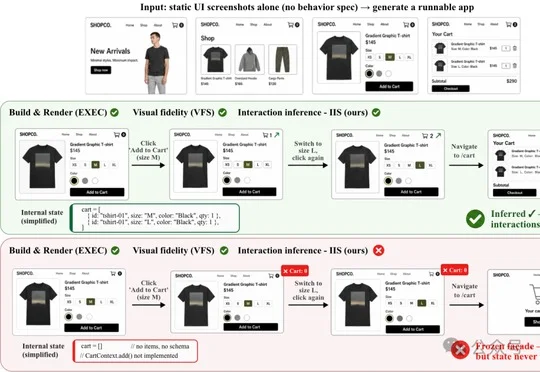
港科广新基准UI2App以600张静态截图评测模型推断并实现应用交互的能力,Gemini 3.1 Pro Preview以73.2分获视觉还原第一,但Claude Sonnet 4.6以36.8分居交互推断首位,跨页面状态仍是参评模型共同难点。
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
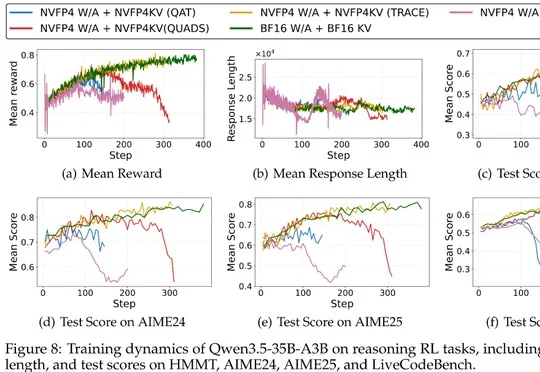
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。