世界模型太慢?西交大提出Fast LeWorldModel:用「动作前缀并行预测」让动态估计加速4倍
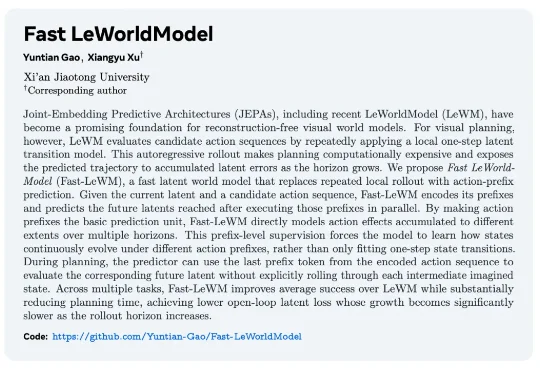
世界模型太慢?西交大提出Fast LeWorldModel:用「动作前缀并行预测」让动态估计加速4倍以 LeWorldModel(LeWM)为例,它在规划时有一个重要瓶颈:每评估一条候选动作序列,模型都要一步步自回归 rollout。也就是说,LeWM 先预测下一步 latent,再把预测出的 latent 输入 dynamics model,继续预测下一步:
搜索
以 LeWorldModel(LeWM)为例,它在规划时有一个重要瓶颈:每评估一条候选动作序列,模型都要一步步自回归 rollout。也就是说,LeWM 先预测下一步 latent,再把预测出的 latent 输入 dynamics model,继续预测下一步:
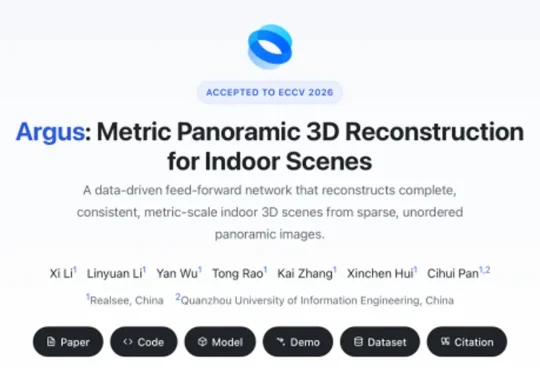
近期, ECCV 2026 结果公布,Realsee 团队的成果 Argus: Metric Panoramic 3D Reconstruction for Indoor Scenes 成功入选。它面向室内全景图像,能够从稀疏、无序的全景照片中,直接预测相机位姿、度量深度和点云重建结果,可以为 3DGS 提供更稳定、更精准的几何约束。
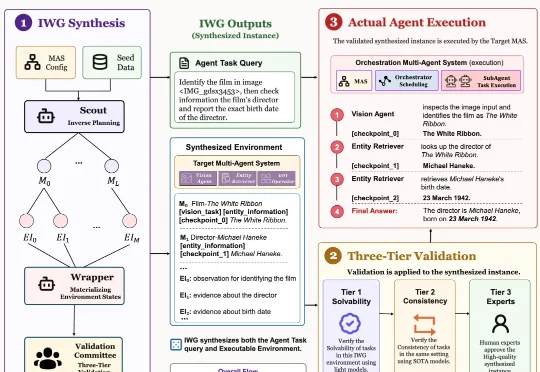
来自南京大学 NLP 实验室的 ICML 2026 论文 Recognize Your Orchestrator: An Entropy Dynamics Perspective for LLM Multi-Agent Systems 指出:在当前主流的 Orchestrator-Executor 多智能体架构中,系统失败往往并不首先来自某个执行器不会干活,
从李飞飞World Labs的50亿估值,到LeCun出走创立AMI Labs的十亿种子轮,再到谷歌Genie 3让文本生成的世界第一次具备实时可交互、可导航的形态,世界模型正在成为AI下一阶段的核心战场。
刚刚,纽约大学联合LeCun初创AMI带来JEPA系列的最新成果——AdaJEPA。与过去在预训练结束后就冻结参数的世界模型不同,AdaJEPA能够在与环境交互中,基于测试时自适应(Test-Time Adaptation, TTA),实时调整世界模型的编码器和预测器参数,从而实现持续学习。
阿里云正式宣布,Apache Flink 3.0全面进入Agentic Streaming For AI时代,并推出全模态数据流处理能力。这是业界第一次,把视频、音频、图像、文本这四类数据,统一放进同一条流式pipeline里调度,让AI能够实时感知、实时理解、实时回应。
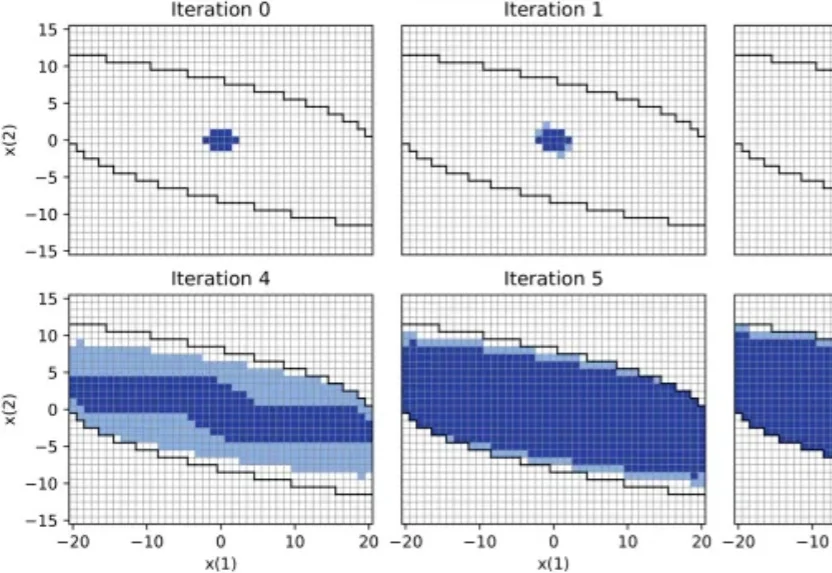
近日清华大学于IEEE TPAMI发表论文,探讨了真机强化学习的安全性保障问题,提出了一套「安全探索均衡」新型机制,揭示了安全探索的理论最大边界,并攻克了其收敛性证明难题。
刚刚,开发者Jamieson O'Reilly用泄露的系统级Prompt,硬核解锁了「轻量版」的Fable 5。仅仅一行代码的注入,就让Opus 4.8当场「开智」。在极限对照实验中,O'Reilly给到同一个指令——制作一个现代苹果风的网页。
奥特曼官宣ChatGPT记忆重大升级!全新Dreaming V3架构正式上线:ChatGPT会在后台「做梦」,首次向数亿免费用户开放。这一次升级,「做梦」功能向十亿人免费开放,Plus和Pro记忆容量直接翻倍。
今天起,ChatGPT 的记忆系统更像人了。OpenAI 刚刚推出了一套全新的记忆系统,底层基于 Dreaming 技术。它会在长期对话中自动整理你的偏好、项目、设备、旅行计划和生活安排,并在回答时判断哪些信息仍然有用,哪些已经过时。