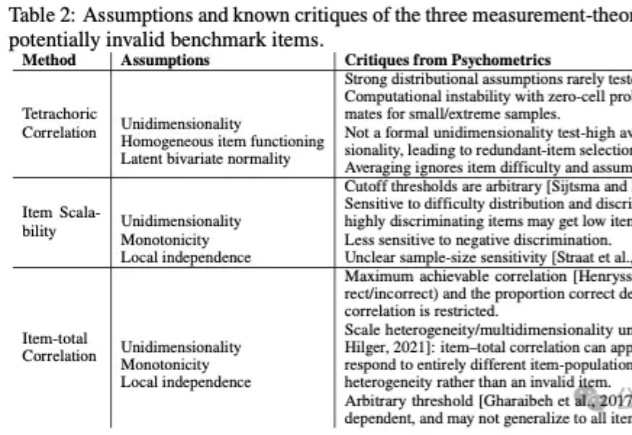
AI基准测试集体塌房,最高84%都是坏题 |斯坦福最新研究
AI基准测试集体塌房,最高84%都是坏题 |斯坦福最新研究基准测试(Benchmarks)在人工智能的发展进程中扮演着至关重要的角色,构成了评价生成式模型(Generative Models)性能的事实标准。对于从事模型训练与评估的AI研究者而言,GSM8K、MMLU等数据集的数据质量直接决定了评估结论的可靠性。
来自主题: AI技术研报
10730 点击 2025-11-28 09:28

 搜索
基准测试(Benchmarks)在人工智能的发展进程中扮演着至关重要的角色,构成了评价生成式模型(Generative Models)性能的事实标准。对于从事模型训练与评估的AI研究者而言,GSM8K、MMLU等数据集的数据质量直接决定了评估结论的可靠性。
最近两周的模型竞赛非常热闹:OpenAI 在 11 月 12 日发布 GPT-5.1,引入更强的推理深度与更高效的对话体验;Google 在 11 月 18 日发布 Gemini 3,全面强化多模态理解与复杂推理能力;Anthropic 在 11 月 24 日又发布了 Claude Opus 4.5,模型在专业文档处理、代码生成与长流程 agent 方面有显著提升。
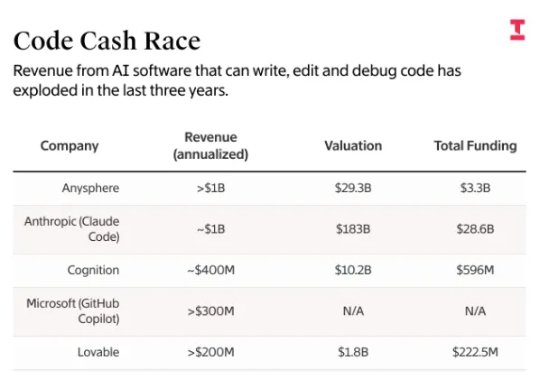
由Anysphere 的 Cursor 和 Anthropic 的 Claude Code 等 AI 编程工具共同创造的收入已突破 31 亿美元。据直接了解 Cognition 财务状况的人士透露,这其中包括 Cognition 的 Devin 编程代理产生的近 4 亿美元年化收入——这一数字此前未被报道过。
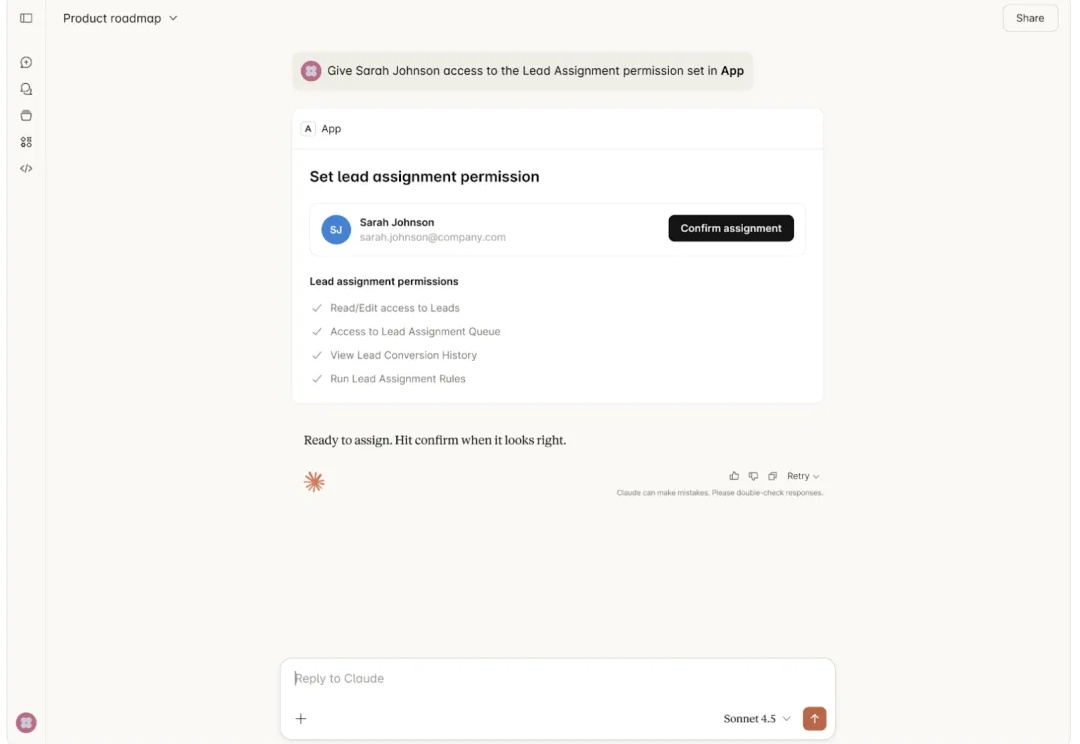
作为连接 AI 模型与广阔数字生态的「神经中枢」,MCP 协议已然成为智能体(AI Agent)不可或缺的基础设施。然而,长期以来,MCP 的交互仅限于文本和结构化数据,这种「盲人摸象」般的体验限制了更复杂应用场景的落地。
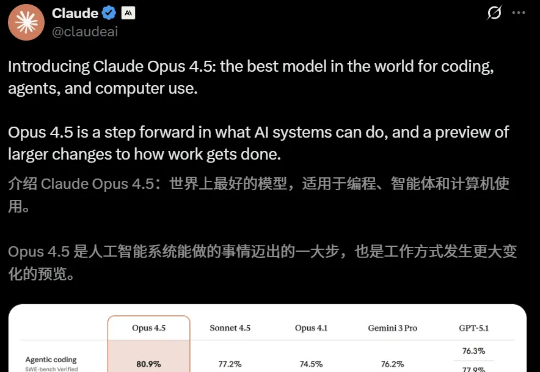
全球编码王座,一夜易主。深夜,Claude Opus 4.5重磅出世,编程实力暴击Gemini 3 Pro、GPT-5.1。才一周的时间,AI圈就完成了一次闭环式迭代。它不仅编程强,而且智能体和计算机使用(computer use)能力也是一流。
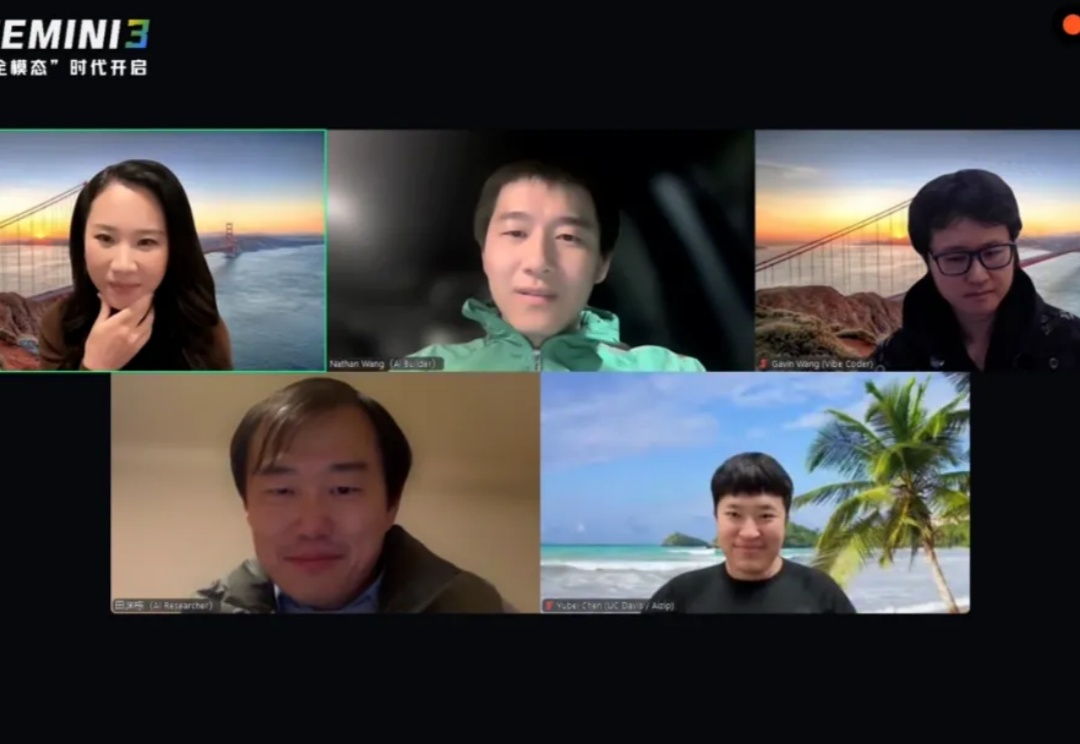
毫无疑问,Google最新推出的Gemini 3再次搅动了硅谷的AI格局。在OpenAI与Anthropic激战正酣之时,谷歌凭借其深厚的基建底蕴与全模态(Native Multimodal)路线,如今已从“追赶者”变成了“领跑者”。
2025年的AI世界,开始出现两种截然不同的声音。OpenAI忙着推出语音、视频、插件生态,想让每个人都用上ChatGPT;Anthropic在研究利润。最新预测显示,这家公司到2028年或将实现700亿美元营收、170亿美元自由现金流。同样是AI巨头,一个押注规模,一个押注稳定。AI的叙事,正在悄悄换频道。
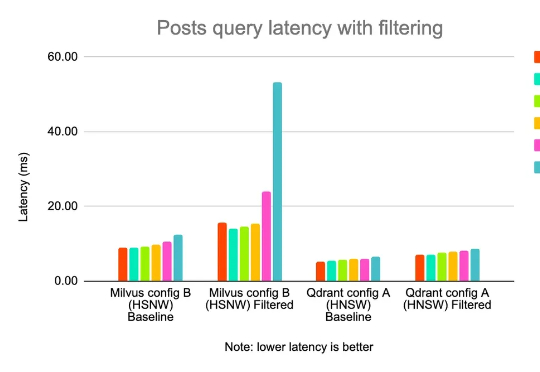
业务团队可能说他们想要个负重一吨,时速两百公里的马车…… 现如今,借助向量检索能力,实现基于语义相似度的智能搜索,已经是所有电商、推荐、社区平台技术架构的重要一环。 作为拥有约 1.08 亿日活、 1
刚刚,Anthropic 发布了一项新研究成果。今天,他们发布的成果是《Natural emergent misalignment from reward hacking》,来自 Anthropic 对齐团队(Alignment Team)。他们发现,现实中的 AI 训练过程可能会意外产生未对齐的(misaligned)模型。

时隔两年后,AI PC的概念已经不再是一个小众的词汇。