原来Scaling Law还能被优化?Meta这招省token又提效
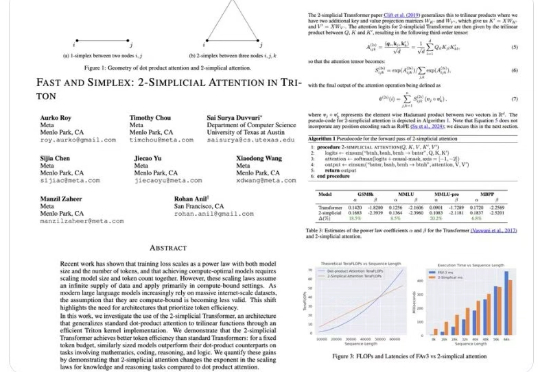
原来Scaling Law还能被优化?Meta这招省token又提效2017 年,一篇《Attention Is All You Need》论文成为 AI 发展的一个重要分水岭,其中提出的 Transformer 依然是现今主流语言模型的基础范式。尤其是在基于 Transformer 的语言模型的 Scaling Law 得到实验验证后,AI 领域的发展更是进入了快车道。
搜索
2017 年,一篇《Attention Is All You Need》论文成为 AI 发展的一个重要分水岭,其中提出的 Transformer 依然是现今主流语言模型的基础范式。尤其是在基于 Transformer 的语言模型的 Scaling Law 得到实验验证后,AI 领域的发展更是进入了快车道。
AI竞争加剧下,Meta面临人才外流和模型性能瓶颈。扎克伯格启动"超级智能单元"招募顶尖AI人才失败后,转向企业风险投资(CVC),通过收购Scale AI和入股NFDG基金,旨在提升竞争力,但优质标的稀缺加剧市场挑战。
2025年,AI界风云激荡,DeepSeek-R1横空出世、英伟达市值称霸全球、谷歌AlphaEvolve打破数学神话,中国Qwen3登顶开源王座……智能爆炸的奇点已悄然降临!新智元十周年之际,2025 AI Era & ASI创新大奖报名正式启动,致敬重塑世界的AI先锋!
当全球目光都聚焦在OpenAI、Anthropic、谷歌、Meta等明星AI公司时,真正靠大模型落地大规模盈利的,却是一家相对不太知名的公司——Palantir。
谷歌、斯坦福等陆续推出「AI科学家」,协助人类科学家推动科研范式革新。科学家亲身试用后或震惊其洞察之深,或质疑其缺乏灵感与人性温度,AI能代替人类思考吗?
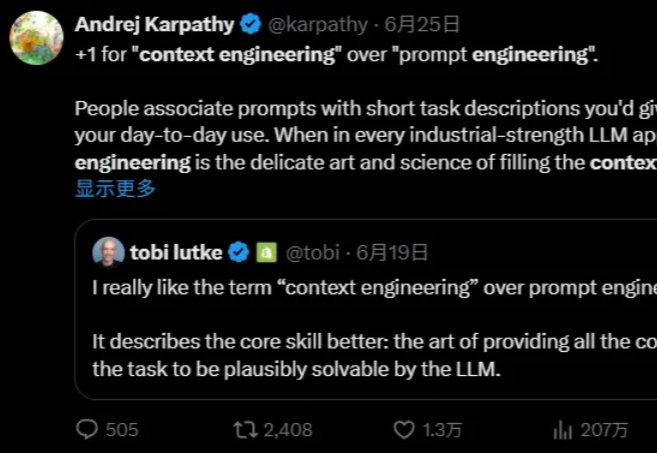
最近「上下文工程」有多火?Andrej Karpathy 为其打 Call,Phil Schmid 介绍上下文工程的文章成为 Hacker News 榜首,还登上了知乎热搜榜。
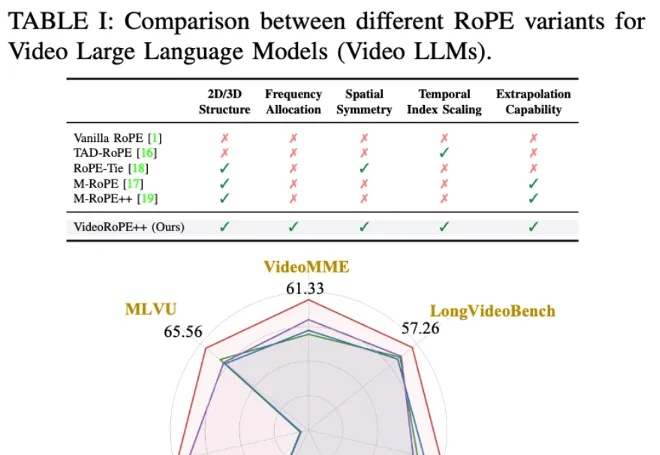
虽然旋转位置编码(RoPE)及其变体因其长上下文处理能力而被广泛采用,但将一维 RoPE 扩展到具有复杂时空结构的视频领域仍然是一个悬而未决的挑战。
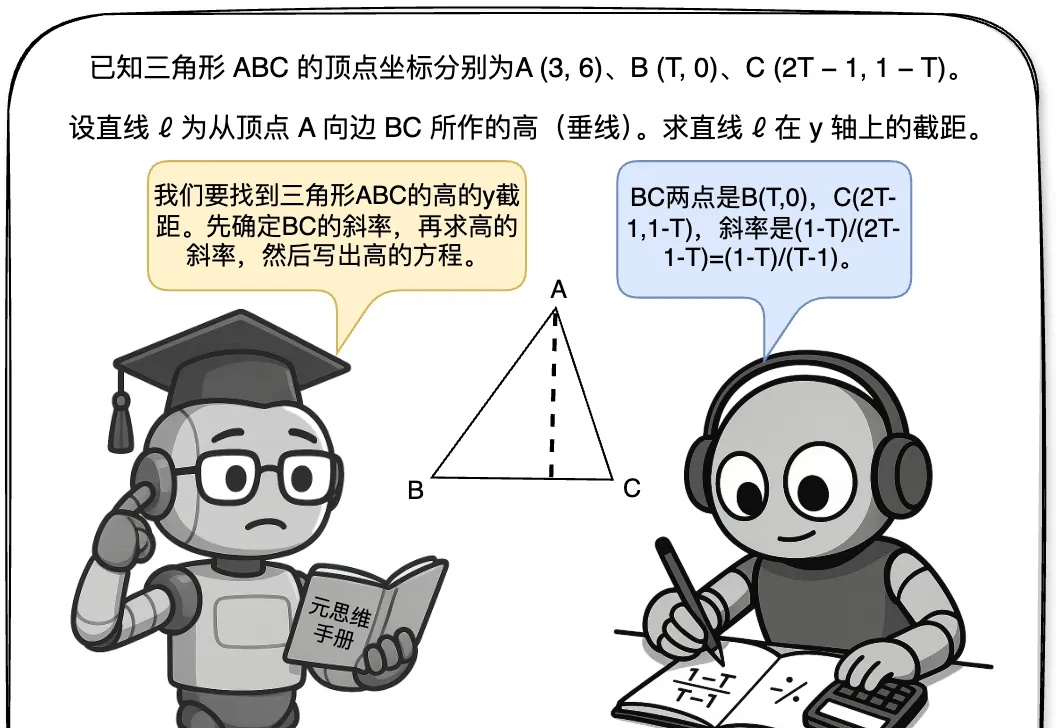
最近,关于大模型推理的测试时间扩展(Test time scaling law )的探索不断涌现出新的范式,包括① 结构化搜索结(如 MCTS),② 过程奖励模型(Process Reward Model )+ PPO,③ 可验证奖励 (Verifiable Reward)+ GRPO(DeepSeek R1)。
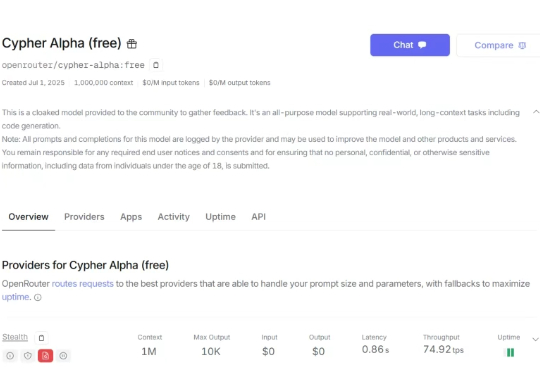
OpenRouter 又上新神秘模型了,支持 100 万 token 上下文,猜猜是谁家的。 刚刚,OpenRouter 上出现了一个神秘模型,该模型被命名为「Cypher Alpha」。其可以免费使用,100 万 token 上下文,还具有推理能力。
想象一下,凌晨三点你被电话吵醒,公司的核心系统彻底崩溃,数十万用户无法正常使用服务,每分钟损失数万美元。你和 50 个工程师挤在一个 Slack 紧急群里,面对着成千上万条日志、指标和报警,却根本找不到问题的根源。