给 Codex 和 Claude Code 接入 DeepSeek-V4-Flash,夯爆了!
给 Codex 和 Claude Code 接入 DeepSeek-V4-Flash,夯爆了!其实 Codex 和 Claude Code 都支持切换模型,咱们直接用 DeepSeek-V4-Flash 来驱动它们就行,量大管饱、不用魔法、也不怕封号。而且现在 DeepSeek 官方已经做了原生适配,接入流程比以前简单多了。
搜索
其实 Codex 和 Claude Code 都支持切换模型,咱们直接用 DeepSeek-V4-Flash 来驱动它们就行,量大管饱、不用魔法、也不怕封号。而且现在 DeepSeek 官方已经做了原生适配,接入流程比以前简单多了。
这两天,AI圈百家争鸣。GPT-6曝光、DeepSeek V4 Flash公测、SD2.5发布、MiniMax多模态开源视频模型发布……
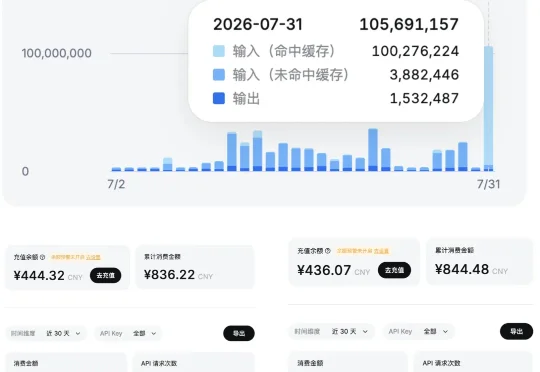
DeepSeek-V4-Flash风评冲爆了,原生支持接入Codex,而且还强化了Agent能力。我第一时间把它接进了Codex,用cc swich非常方便。一个小时,跑了一亿多token。跟大家说说体感。
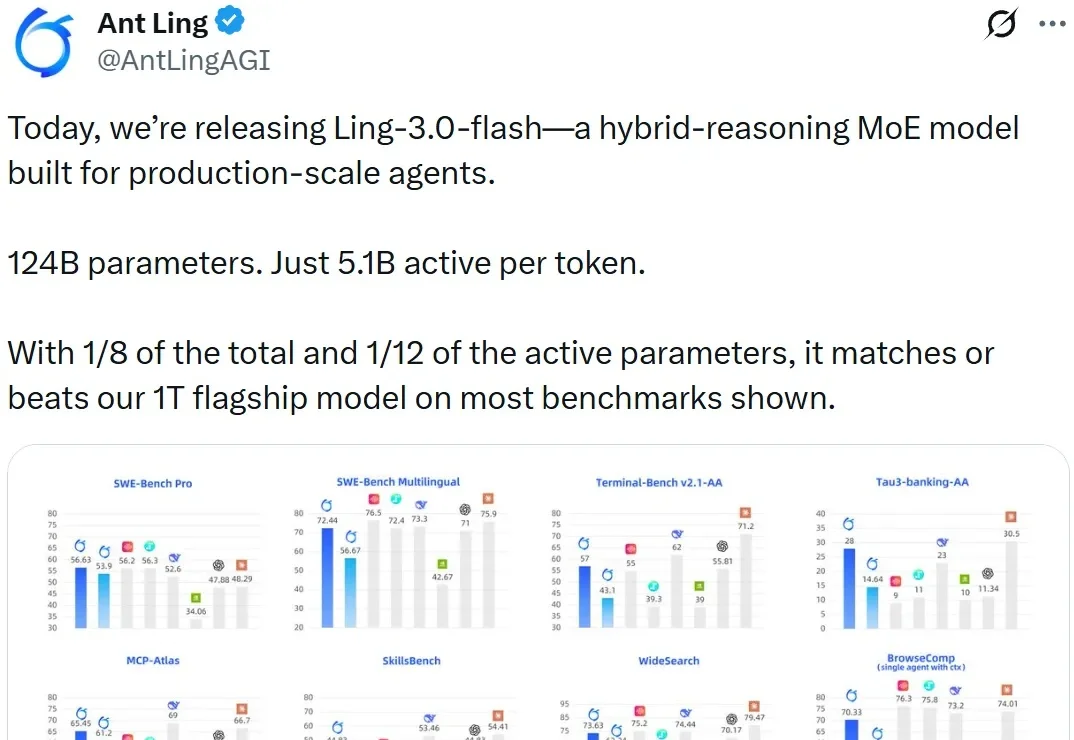
今日,华为开源基于昇腾NPU训练的盘古MoE模型openPangu-2.0-Pro。该模型是openPangu-2.0系列的最新开源模型,总参数规模5050亿,激活参数规模180亿,支持512K上下文长度,训练数据总量约34T tokens。另一轻量化模型openPangu-2.0-Flash已于6月12日开源,参数92亿,其中6亿为激活参数。
7月31日,DeepSeek正式向公众开放V4-Flash正式版API公测。这一次,最亮眼的关键词是——Agent能力大幅跃升。9项基准测试成绩全面披露,多项指标远超此前发布的V4-Pro-Preview预览版,直接将“代码智能体”的天花板又顶高了一截。
每逢重要的新模型发布,我们编辑部通常比新闻本身更早进入工作状态:提前打开官网、直播和社交媒体,等结果陆续出来,大家一边热火朝天地开始写文章,一边梳理参数、榜单和演示案例,判断这一次技术究竟向前走了多远。
微软周一发布了一款名为Project Perception的新AI安全产品,该产品由微软自主研发、专门针对网络安全任务打造的新一代AI模型驱动。微软将这款产品定位为Anthropic旗下Mythos模型的低成本替代方案,后者同样利用AI模型自动发现软件漏洞。
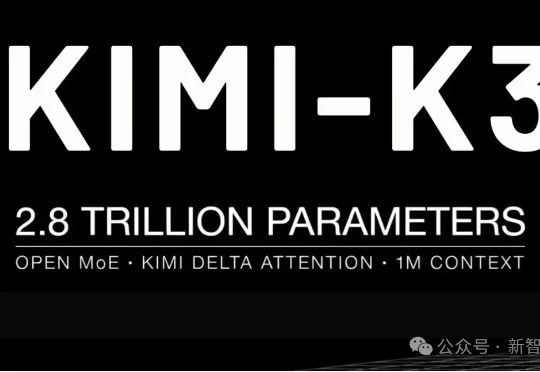
就在刚刚,全球首个3万亿参数级开源模型Kimi K3正式开源!https://github.com/MoonshotAI/Kimi-K3/tree/main。Moonshot AI宣布,发布Kimi K3的模型权重、技术报告,并开源支撑Kimi K3模型训练的关键Infra技术:MoonEP、FlashKDA和AgentEnv。
近日,Meta 首席 AI 官、被称为公司“最高薪员工”的 Alexandr Wang,因一句简单却极具挑衅意味的话引起热议:“gemini who?(Gemini,谁啊?)”这场口水战的背后,其实是一场 AI 巨头之间的公开较量——Meta 最新模型 Muse Spark 1.1 在一份模型排行榜中超过了谷歌刚发布的 Gemini 3.6 Flash
金涛今年 26 岁,还是清华在读博士。真正把他带进「推理加速」的,是一个很朴素的判断——当大家都默认 FlashAttention 已经把 Attention 算子做到极致时,他却发现:显卡上明明还有更快的计算单元没被用起来 ——「这么明显的收益,为什么没人做?」