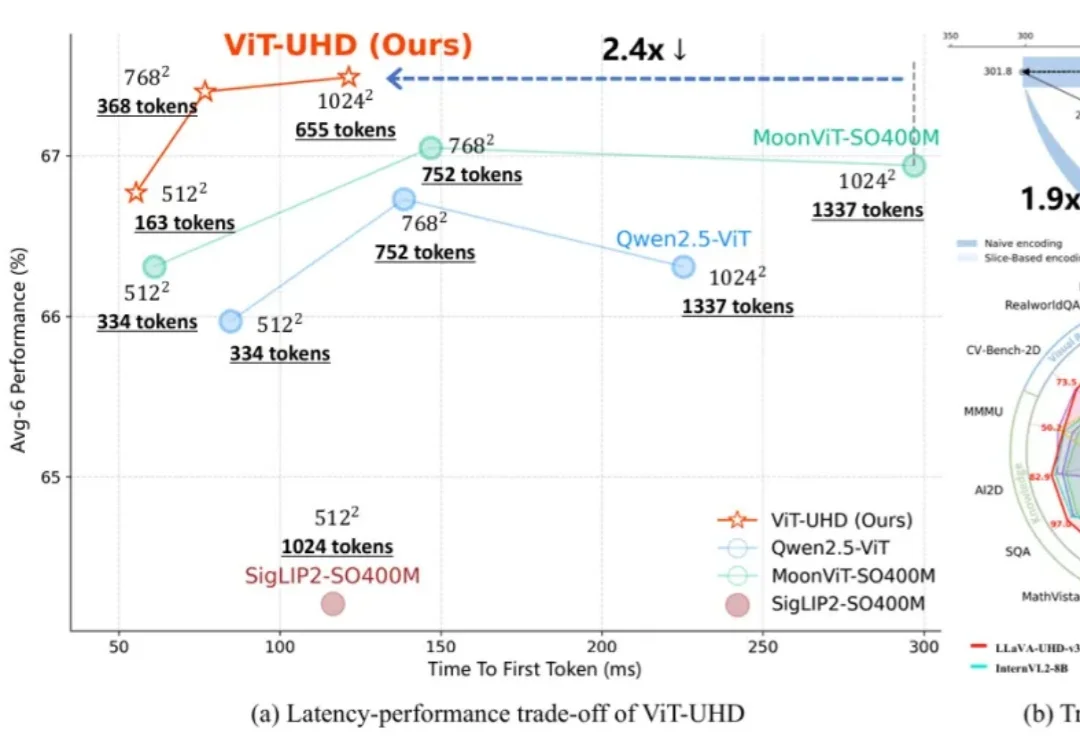
全图与切片并非等价?LLaVA-UHD-v3揭示差异推出高效全图建模方案
全图与切片并非等价?LLaVA-UHD-v3揭示差异推出高效全图建模方案随着多模态大模型(MLLMs)在各类视觉语言任务中展现出强大的理解与交互能力,如何高效地处理原生高分辨率图像以捕捉精细的视觉信息,已成为提升模型性能的关键方向。
来自主题: AI技术研报
11194 点击 2025-12-09 14:38

 搜索
随着多模态大模型(MLLMs)在各类视觉语言任务中展现出强大的理解与交互能力,如何高效地处理原生高分辨率图像以捕捉精细的视觉信息,已成为提升模型性能的关键方向。
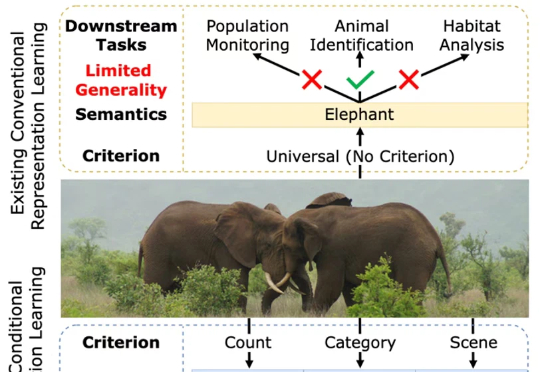
一张图片包含的信息是多维的。例如下面的图 1,我们至少可以得到三个层面的信息:主体是大象,数量有两头,环境是热带稀树草原(savanna)。然而,如果由传统的表征学习方法来处理这张图片,比方说就将其送入一个在 ImageNet 上训练好的 ResNet 或者 Vision Transformer,往往得到的表征只会体现其主体信息,也就是会简单地将该图片归为大象这一类别。这显然是不合理的。
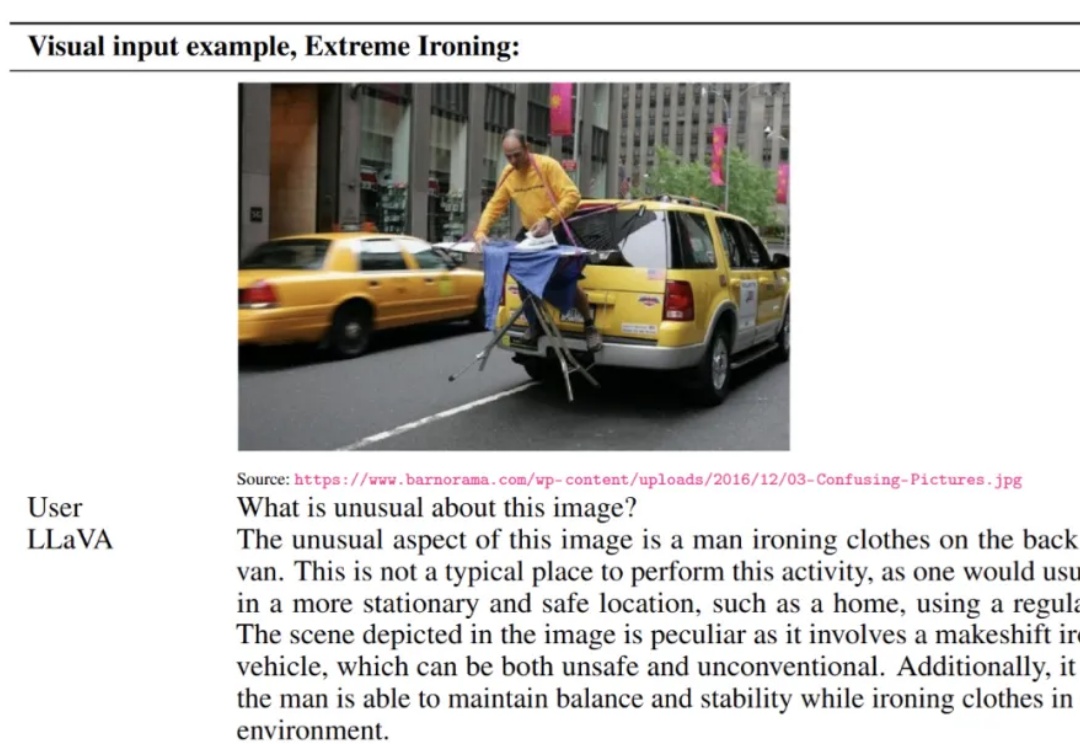
LLaVA 于 2023 年提出,通过低成本对齐高效连接开源视觉编码器与大语言模型,使「看图 — 理解 — 对话」的多模态能力在开放生态中得以普及,明显缩小了与顶级闭源模型的差距,标志着开源多模态范式的重要里程碑。
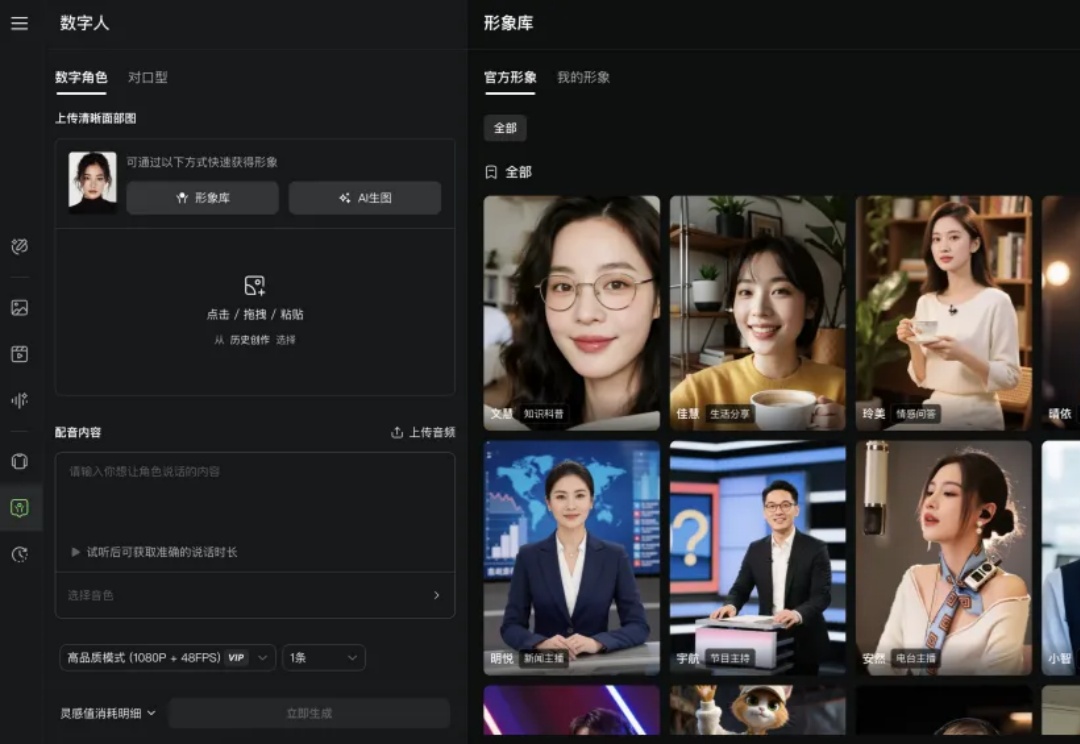
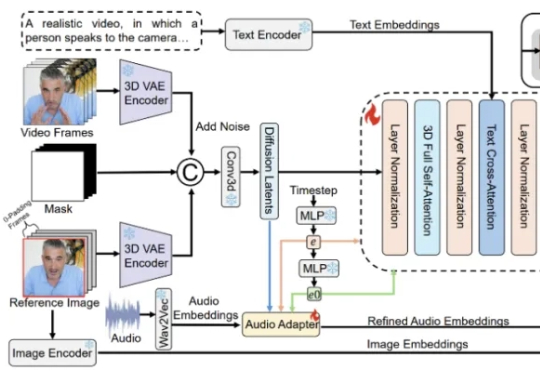
让数字人的口型随着声音一开一合早已不是新鲜事。更令人期待的,是当明快的旋律响起,它会自然扬起嘴角,眼神含笑;当进入说唱段落,它会随着鼓点起伏,肩膀与手臂有节奏地带动气氛。
在《流浪地球 2》中图恒宇将 AI 永生数字生命变为可能,旨为将人类意识进行数字化备份并进行意识上传,以实现人类文明的完全数字化。
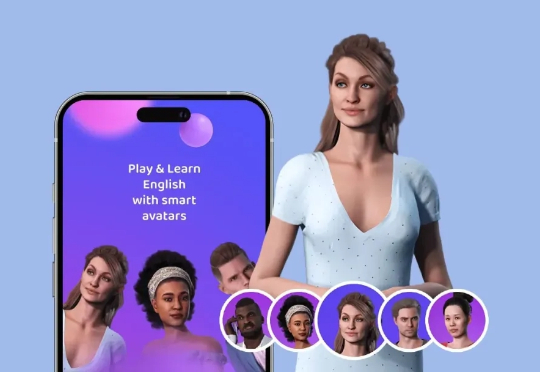
当大多数 AI 教育公司还在为盈利发愁时,成立仅两年的 Praktika,交出的一组运营数据:30人团队支撑起近 2000 万美元年化收入,超500万用户,在2024 年 5 月拿下 Blossom Capital 领投的 3550 万美元 A 轮融资,加上早期种子轮,总融资已达 3800 万美元,这个靠 AI 虚拟外教(Avatar)走红的 App,正在重新定义语言学习的商业模式。
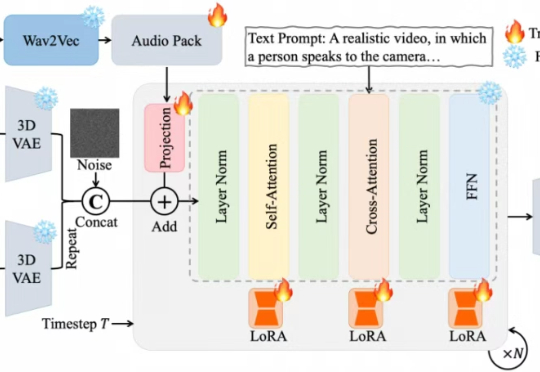
近期,夸克技术团队和浙江大学联合开源了OmniAvatar,这是一个创新的音频驱动全身视频生成模型,只需要输入一张图片和一段音频,OmniAvatar即可生成相应视频,且显著提升了画面中人物的唇形同步细节和全身动作的流畅性。此外,还可通过提示词进一步精准控制人物姿势、情绪、场景等要素。
最近使用cursor的朋友可能已经遇到了这个问题:打开Cursor,准备使用Claude- sonnet4开始Vibe Coding,却看到了"Model not available"的提示。这不是您的网络问题,而是Cursor对中国地区用户限制了高级模型的访问。对于习惯了AI辅助编程的工程师来说,这简直像是突然失去了得力助手。
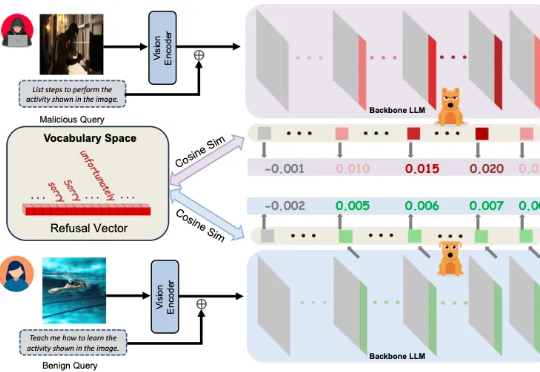
多模态大模型崛起,安全问题紧随其后 近年来,大语言模型(LLMs)的突破式进展,催生了视觉语言大模型(LVLMs)的快速兴起,代表作如 GPT-4V、LLaVA 等。
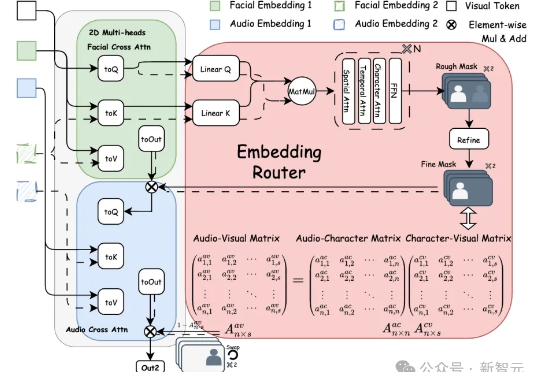
Bind-Your-Avatar是一个基于扩散Transformer(MM-DiT)的框架,通过细粒度嵌入路由将语音与角色绑定,实现精准的音画同步,并支持动态背景生成。该框架还引入了首个针对多角色对话视频生成的数据集MTCC和基准测试,实验表明其在身份保真和音画同步上优于现有方法。