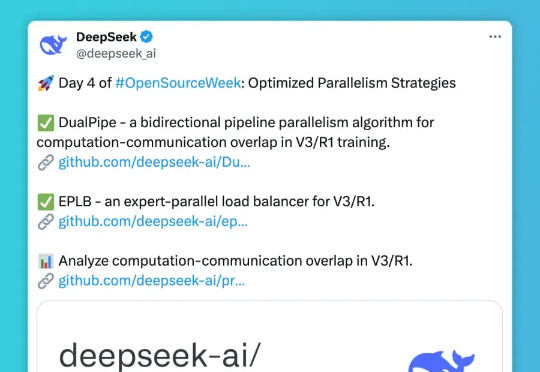
一文详解:DeepSeek 第四天开源的模型设计套件
一文详解:DeepSeek 第四天开源的模型设计套件第四天,DeepSee发布包括三个主要项目: DualPipe- 一种用于 V3/R1 训练的双向流水线并行算法,实现计算和通信完全重叠; EPLB(Expert Parallelism Load Balancer) - 专为 V3/R1 设计的专家并行负载均衡器; Profile-data- 分析 V3/R1 中计算与通信重叠的性能数据集。
搜索
第四天,DeepSee发布包括三个主要项目: DualPipe- 一种用于 V3/R1 训练的双向流水线并行算法,实现计算和通信完全重叠; EPLB(Expert Parallelism Load Balancer) - 专为 V3/R1 设计的专家并行负载均衡器; Profile-data- 分析 V3/R1 中计算与通信重叠的性能数据集。
按时整活!DeepSeek开源周第四天,直接痛快「1日3连发」,且全都围绕一个主题:优化并行策略。
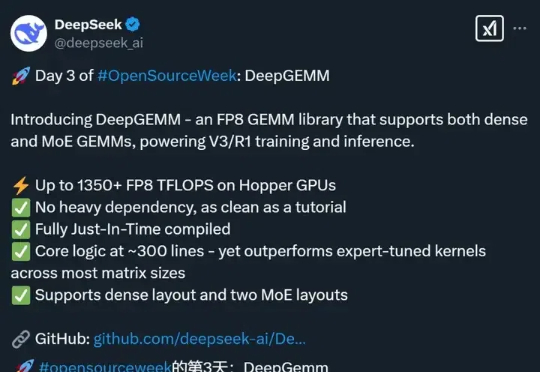
DeepSeek 的开源周已经进行到了第三天(前两天报道见文末「相关阅读」)。今天开源的项目名叫 DeepGEMM,是一款支持密集型和专家混合(MoE)GEMM 的 FP8 GEMM 库,为 V3/R1 的训练和推理提供了支持,在 Hopper GPU 上可以达到 1350+ FP8 TFLOPS 的计算性能。
AI开源潮涌现,推理模型成主流。
DeepSeek开源第二弹如期而至。这一次,他们把MoE模型内核库开源了,支持FP8专为Hopper GPU设计,低延迟超高速训练推理。
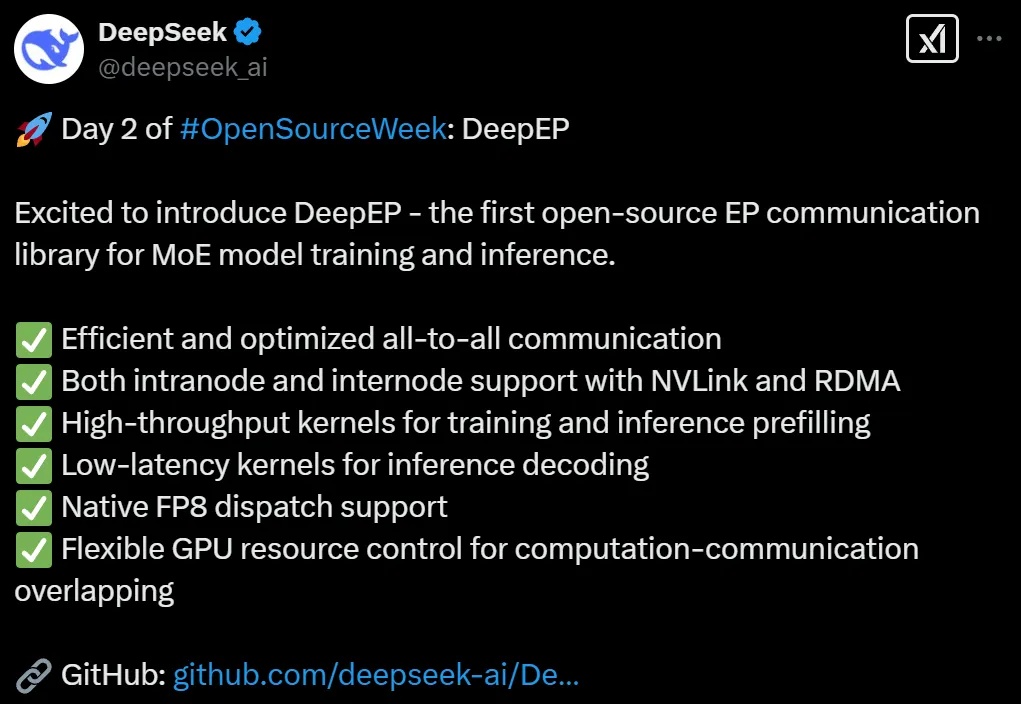
DeepSeek开源第二弹如期而至。这一次,他们把MoE训推EP通信库DeepEP开源了,支持FP8专为Hopper GPU设计,低延迟超高速训练推理。
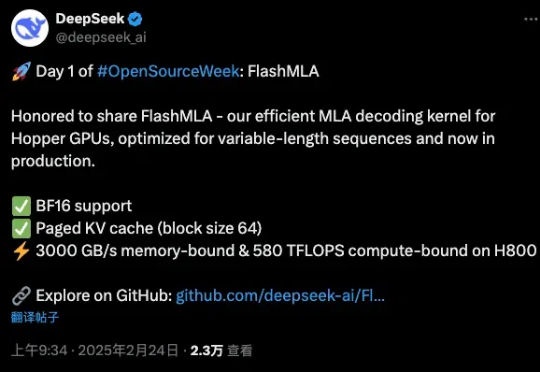
刚刚,万众瞩目的DeepSeek,开源了他们第一天的项目。FlashMLA是一款面向Hopper GPU的高效MLA解码内核,并针对可变长度序列的服务场景进行了优化。
DeepSeek开源周第一天就放大招!FlashMLA强势登场,这是专为英伟达Hopper GPU打造MLA解码内核。注意,DeepSeek训练成本极低的两大关键,一个是MoE,另一个就是MLA。
上周五,DeepSeek 发推说本周将是开源周(OpenSourceWeek),并将连续开源五个软件库。第一个项目,果然与推理加速有关。北京时间周一上午 9 点,刚一上班(同时是硅谷即将下班的时候),DeepSeek 兑现了自己的诺言,开源了一款用于 Hopper GPU 的高效型 MLA 解码核:FlashMLA。
早上MiniMax上线TTS,字节上线AI编程Trae;下午字节全量上线豆包实时语音;晚上DeepSeek开源R1性能直接对标OpenAI o1,然后Kimi的k1.5直接正面硬刚。昨天的余温还没过,今天下午,腾讯混元又悄悄开了个闭门发布会,作为混元的老基友,我自然是受邀参加期期不落。