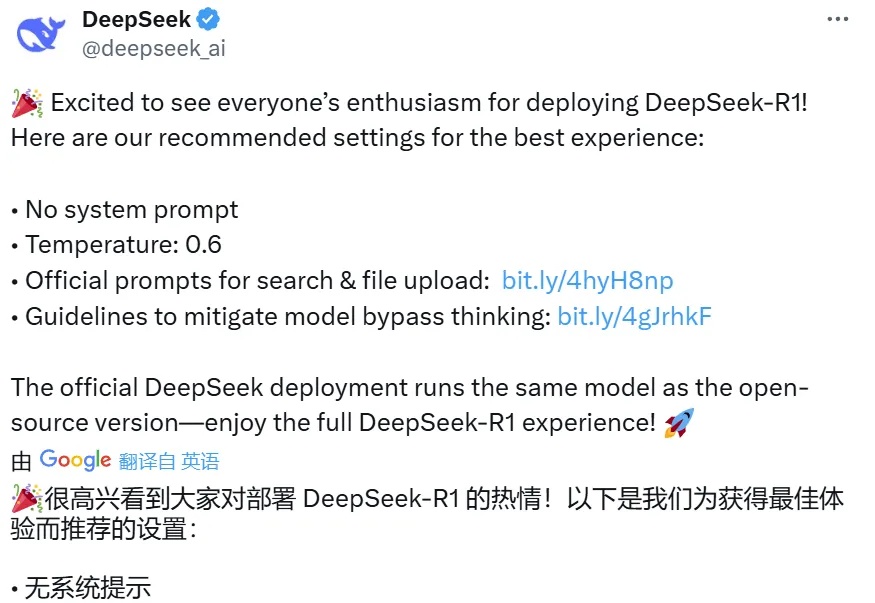
刚刚,DeepSeek官方发布R1模型推荐设置,这才是正确用法
刚刚,DeepSeek官方发布R1模型推荐设置,这才是正确用法自春节以来,DeepSeek 就一直是 AI 领域最热门的关键词,甚至可能没有之一,其官方 App 成为了史上最快突破 3000 万日活的应用。最近一段时间,各家 AI 或云服务厂商更是掀起了部署 DeepSeek-R1 服务的狂潮,甚至让薅羊毛的用户们都有点忙不过来了。
来自主题: AI资讯
6596 点击 2025-02-15 12:00

 搜索
自春节以来,DeepSeek 就一直是 AI 领域最热门的关键词,甚至可能没有之一,其官方 App 成为了史上最快突破 3000 万日活的应用。最近一段时间,各家 AI 或云服务厂商更是掀起了部署 DeepSeek-R1 服务的狂潮,甚至让薅羊毛的用户们都有点忙不过来了。
最新大语言模型推理测试引众议,DeepSeek R1常常在提供错误答案前就“我放弃”了?? Cursor刚刚参与了一项研究,他们基于NPR周日谜题挑战(The Sunday Puzzle),构建了一个包含近600个问题新基准测试。
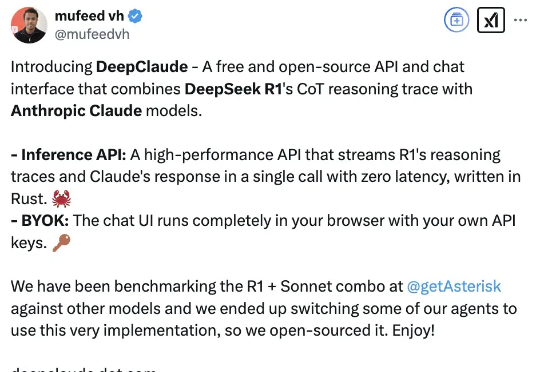
让DeepSeek代替Claude思考,缝合怪玩法火了。原因无它:比单独使用DeepSeek R1、Claude Sonnet 3.5、OpenAI o1模型的效果更好。DeepClaude应用本身100%免费且开源,在GitHub上已揽获3k星星(当然API要用自己的)。
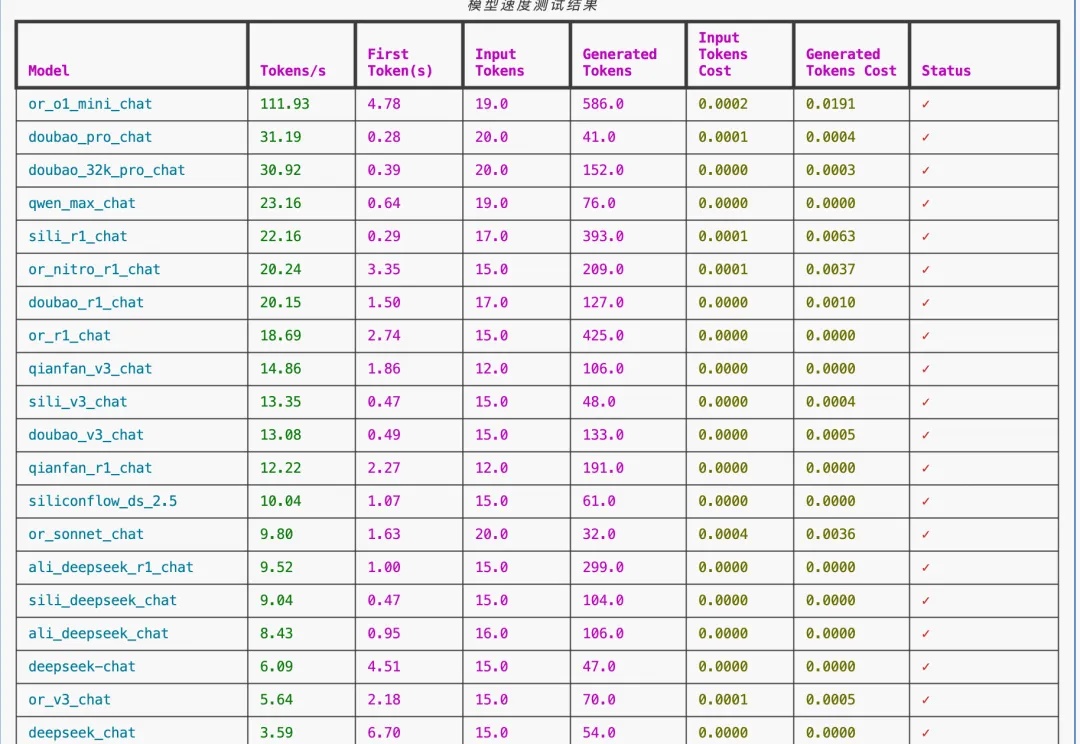
判断哪些是凑热闹的供应商
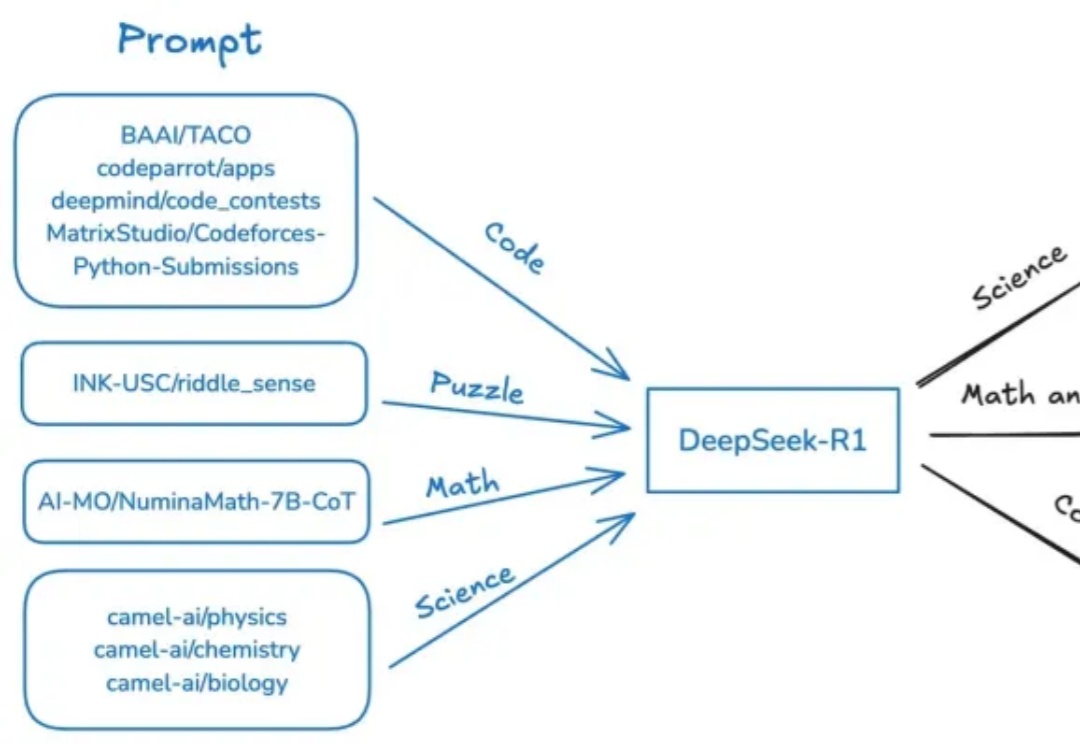
近日,斯坦福、UC伯克利等多机构联手发布了开源推理新SOTA——OpenThinker-32B,性能直逼DeepSeek-R1-32B。其成功秘诀在于数据规模化、严格验证和模型扩展。
一个简单的笑脸😀可能远不止这么简单?最近,AI大神Karpathy发现,一个😀竟然占用了多达53个token!这背后隐藏着Unicode编码的哪些秘密?如何利用这些「隐形字符」在文本中嵌入、传递甚至「隐藏」任意数据。更有趣的是,这种「数据隐藏术」甚至能对AI模型进行「提示注入」!
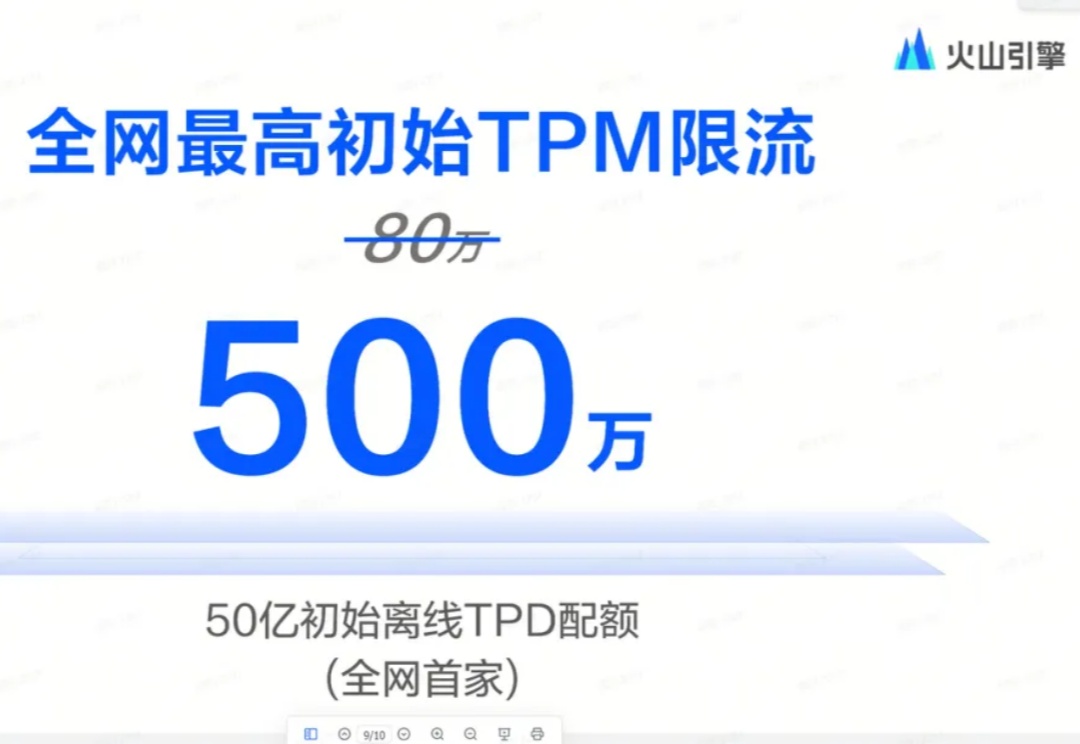
最近,DeepSeek 很热,是个好 AI,但不是每个人都能用上。

这项尝试只用到了 R1 模型和基本验证器,没有针对 R1 的工具,没有对专有的英伟达代码进行微调。其实根据 DeepSeek 介绍,R1 的编码能力不算顶尖。

【新智元导读】仅凭测试时Scaling,1B模型竟完胜405B!多机构联手巧妙应用计算最优TTS策略,不仅0.5B模型在数学任务上碾压GPT-4o,7B模型更是力压o1、DeepSeek R1这样的顶尖选手。

这应该是我知道的第一家有自己大模型的大厂,第一次在面向C端的AI助手应用中,第一次接入DeepSeek R1。这个意义影响还是非常深远的,腾讯在AI这一步上,好像走的格外的开放,从之前的批量开源MoE、混元绘图模型、混元视频模型、混元3D模型,还有今天这神之一手接入DeepSeek R1。