独家丨爱诗融资 3 亿美元,中国视频生成最大单笔融资诞生
独家丨爱诗融资 3 亿美元,中国视频生成最大单笔融资诞生爱诗科技近期完成了 3 亿美元 C 轮融资,由鼎晖投资领投,超过 20 家机构参与,包括中国儒意、三七互娱等文娱行业产业方,亦庄国投、苏创投等地方国资,和 UOB Venture Management、 Lion X 基金等海外机构。
来自主题: AI资讯
9782 点击 2026-03-13 00:34

 搜索
爱诗科技近期完成了 3 亿美元 C 轮融资,由鼎晖投资领投,超过 20 家机构参与,包括中国儒意、三七互娱等文娱行业产业方,亦庄国投、苏创投等地方国资,和 UOB Venture Management、 Lion X 基金等海外机构。
OpenAI的最新研究揭示了一个反直觉的真相:越强大的推理模型,越管不住自己的「脑子」。在CoT-Control套件测试的13款前沿模型中,DeepSeek R1控制自身思维链的成功率仅为0.1%,Claude Sonnet 4.5也只有2.7%。
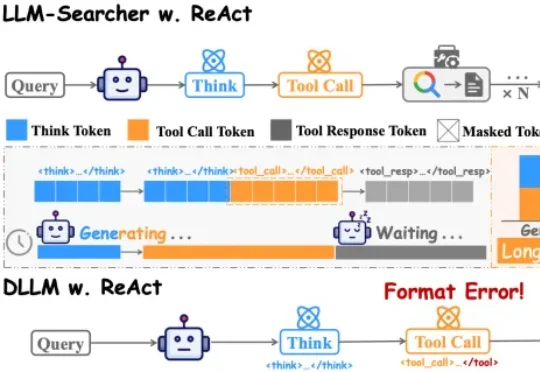
中国人民大学团队在论文DLLM-Searcher中,第一次让扩散大语言模型(dLLM)学会了这种“一心二用”的本事。目前主流的搜索Agent,不管是Search-R1还是R1Searcher,用的都是ReAct框架。这个框架的执行流程是严格串行的:
李国杰院士指出,AI安全风险应按逻辑复杂性分为三类:R1可验证、R2可发现但不可证明安全、R3不可治理。当前AI多属R2,关键不在「证明安全」,而在构建人类主导的制度性刹车机制,拒绝让渡终极控制权。
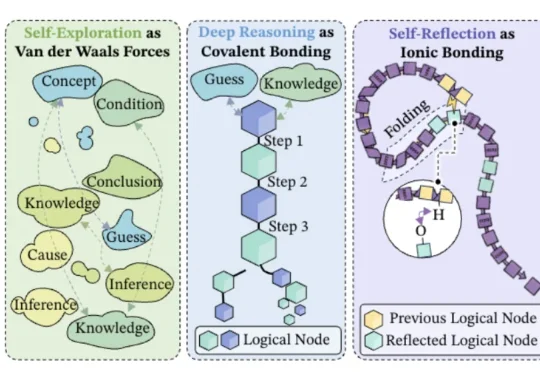
字节Seed都开始用化学思想搞大模型了——深度推理是共价键、自我反思是氢键、自我探索是范德华力?!
机器之心编译 如果把人生看作一个开放式的大型多人在线游戏(MMO),那么游戏服务器在刚刚完成一次重大更新的时刻,规则改变了。 自 2022 年 ChatGPT 惊艳亮相以来,世界已经发生了深刻变化。在
近日,微软Bing Ads与DKI团队发表论文《AdNanny: One Reasoning LLM for All Offline Ads Recommendation Tasks》,宣布基于DeepSeek-R1 671B打造了统一的离线推理中枢AdNanny,用单一模型承载所有离线任务。这标志着从维护一系列任务特定模型,转向部署一个统一的、推理中心化的基础模型,从
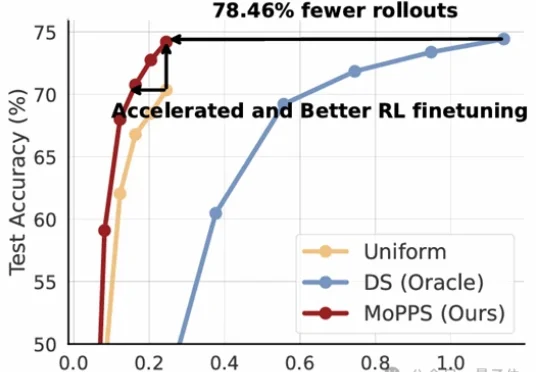
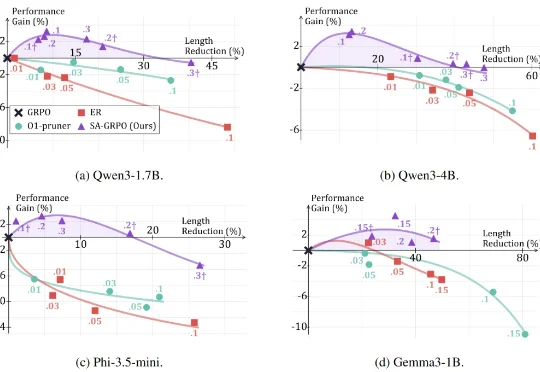
以DeepSeek R1为代表的一系列基于强化学习(RLVR)微调的工作,显著提升了大语言模型的推理能力。但在这股浪潮背后,强化微调的代价却高得惊人。
2025 年 1 月 20 日,DeepSeek 发布了推理大模型 DeepSeek-R1,在学术界和工业界引发了对大模型强化学习方法的广泛关注与研究热潮。 研究者发现,在数学推理等具有明确答案的任务
过去两年,大模型的推理能力出现了一次明显的跃迁。在数学、逻辑、多步规划等复杂任务上,推理模型如 OpenAI 的 o 系列、DeepSeek-R1、QwQ-32B,开始稳定拉开与传统指令微调模型的差距。直观来看,它们似乎只是思考得更久了:更长的 Chain-of-Thought、更高的 test-time compute,成为最常被引用的解释。