AI资讯新闻榜单内容搜索-RSI

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: RSI
让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

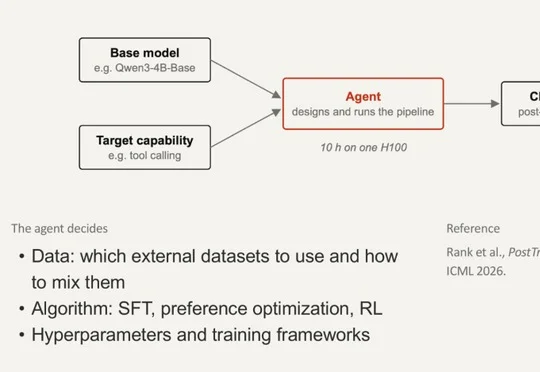
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain

来自主题: AI技术研报
9637 点击    2026-10-03 10:29
Token用量暴涨124倍,研发提速仅一成?前微软合伙人万字长文质疑RSI引发“智能爆炸”

Token用量暴涨124倍,研发提速仅一成?前微软合伙人万字长文质疑RSI引发“智能爆炸”

Token用量暴涨124倍,研发提速仅一成?前微软合伙人万字长文质疑RSI引发“智能爆炸”

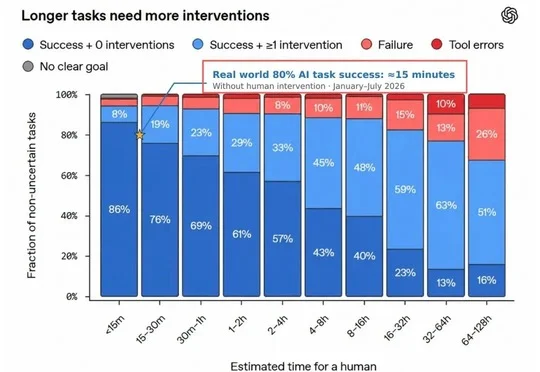
AI 确实在帮 AI 变强,但收益正逐轮递减。当前 AI 自我改进回路的实际强度,仅为触发“智能爆炸”所需理论阈值的 10% 到 20%;若要实现自我维持式的加速进化,这条回路必须再增强 5 到 10 倍。而在巨额过程损耗面前,眼下的系统连维持匀速进步都已十分吃力。

来自主题: AI技术研报
6724 点击    2026-10-02 12:47
OpenAI 和 Anthropic 都在谈的 RSI,今天走到哪一步了?

OpenAI 和 Anthropic 都在谈的 RSI,今天走到哪一步了?

OpenAI 和 Anthropic 都在谈的 RSI,今天走到哪一步了?

RSI(Recursive Self-Improvement,递归自我改进)最近成为了行业内关注的新热点。 简单说来,模型参与训练和提升模型自己,在业界已经开始成为一种惯例。Anthropic 在六月

来自主题: AI资讯
9269 点击    2026-10-02 12:46
看一遍就会,三星&上交提出RoboICL新方法,GPT-6 Astra多项机器人操控评测全面领先

看一遍就会,三星&上交提出RoboICL新方法,GPT-6 Astra多项机器人操控评测全面领先

看一遍就会,三星&上交提出RoboICL新方法,GPT-6 Astra多项机器人操控评测全面领先

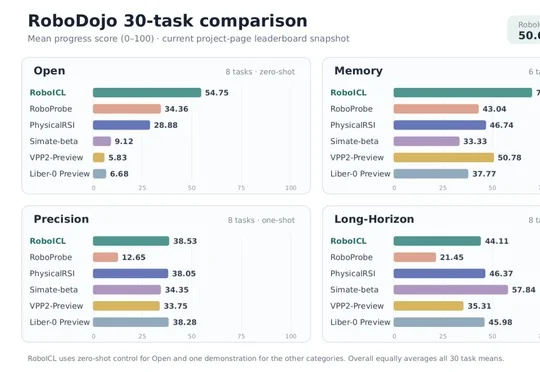
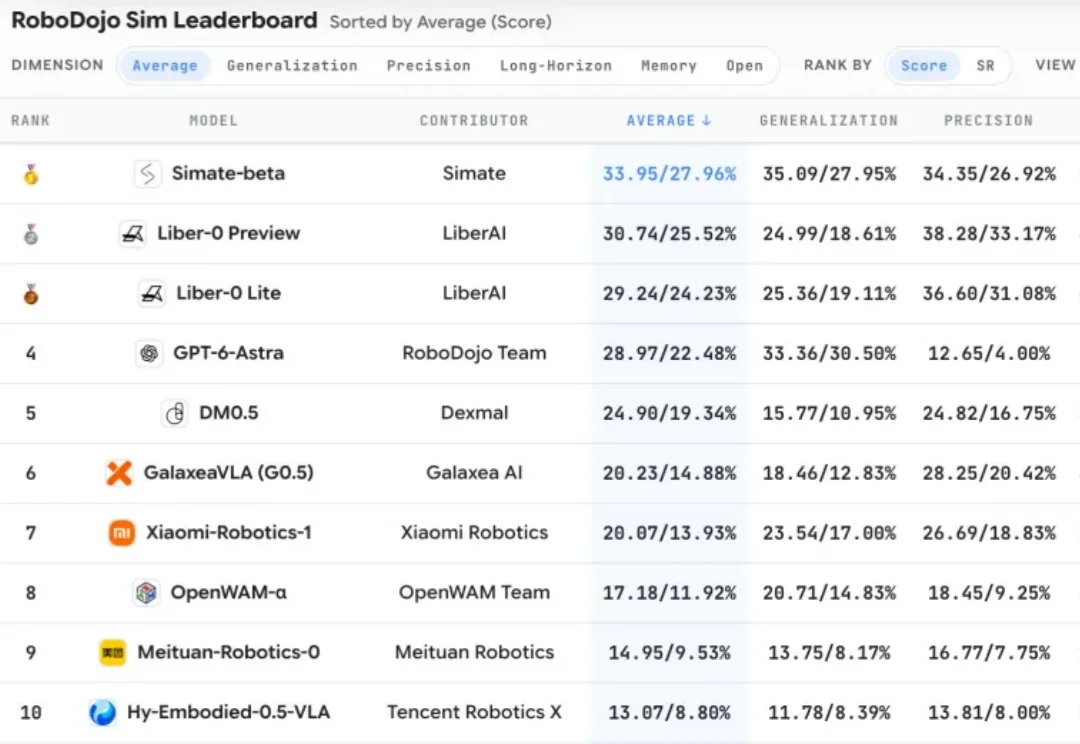
三星与上海交通大学提出RoboICL具身上下文学习方法,通过冻结GPT-6 Astra模型并在推理时提供少量示范与机器人自身交互记忆,在RoboDojo 30项机器人操控评测中以50.64分全面领先PhysicalRSI等现有方法,并公开了929条可逐布局核查的执行记录及真实机械臂实验结果。

来自主题: AI技术研报
10915 点击    2026-10-01 13:15
Gemini 4震撼发布,已实现RSI?谷歌80万行内核已被重写

Gemini 4震撼发布,已实现RSI?谷歌80万行内核已被重写

Gemini 4震撼发布,已实现RSI?谷歌80万行内核已被重写

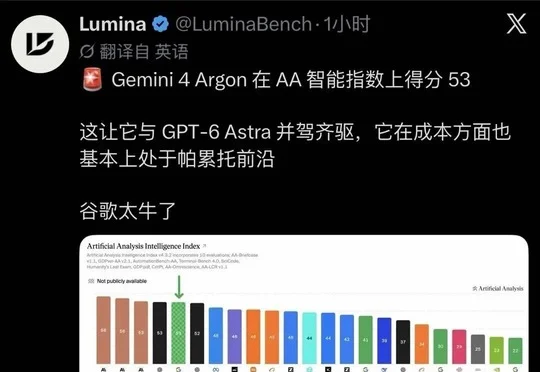
谷歌正式发布前沿AI模型Gemini 4 Argon,其在Text Arena排名第一、Vals RSI指数超越GPT-6 Astra达30%,单任务成本仅1.99美元,单次输出上限升至100万Token,并在谷歌内部以Rust安全语言重写了80万行系统内核代码。

来自主题: AI资讯
10223 点击    2026-10-01 10:16
三榜第一,完胜GPT-6!中国物理RSI杀出黑马

三榜第一,完胜GPT-6!中国物理RSI杀出黑马

三榜第一,完胜GPT-6!中国物理RSI杀出黑马

诺因(Knowin)发布生成式学习框架GLOW,在RoboDojo、LIBERO-Pro、Embodied Arena三大具身智能榜单斩获第一,性能显著超越GPT-6,其原生自回归架构、Harness闭环反馈系统与RSI递归自我改进机制共同推动机器人实现"一教就会"的个性化家庭服务能力。

来自主题: AI资讯
9419 点击    2026-09-25 10:11
梁文锋用沙盒开启RSI

梁文锋用沙盒开启RSI

梁文锋用沙盒开启RSI

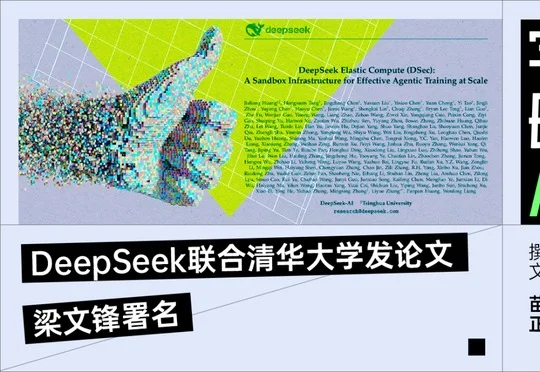
DeepSeek联合清华大学发布论文公开Agent训练沙盒基础设施DSec,梁文锋署名,论文第6节揭示DeepSeek已部分实现RSI(递归自我改进)闭环,Agent可在沙盒中自主构建训练环境,标志着Agent沙盒成为下一代云基础设施的新战场。

来自主题: AI资讯
9337 点击    2026-09-25 10:10
冻结模型权重,Agent还能持续进化:ModularRSI探索Harness自我改进

冻结模型权重,Agent还能持续进化:ModularRSI探索Harness自我改进

冻结模型权重,Agent还能持续进化:ModularRSI探索Harness自我改进

近日,IQuest Research 同北京航空航天大学、曼彻斯特大学等合作伙伴发布 ModularRSI,尝试让 Agent 根据自身执行经验,持续修改模型外围的运行机制——Harness。

来自主题: AI技术研报
6288 点击    2026-09-24 13:20
马卡龙的下注:把模型后训练,做成企业服务

马卡龙的下注:把模型后训练,做成企业服务

马卡龙的下注:把模型后训练,做成企业服务

Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。

来自主题: AI资讯
9947 点击    2026-09-24 10:10