大模型搜索总偷懒?IQuest等联合推出FORT,30B开源搜索Agent刷新同规模SOTA
大模型搜索总偷懒?IQuest等联合推出FORT,30B开源搜索Agent刷新同规模SOTA来自至知创新研究院(IQuest Research)、中国人民大学高瓴人工智能学院、KAUST等机构的研究团队提出了FORT,一个面向Deep Search Agent的shortcut-resistant training-data synthesis framework。
搜索
来自至知创新研究院(IQuest Research)、中国人民大学高瓴人工智能学院、KAUST等机构的研究团队提出了FORT,一个面向Deep Search Agent的shortcut-resistant training-data synthesis framework。
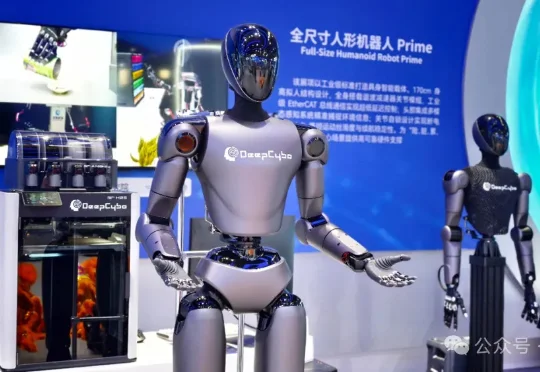
当全球具身智能行业还在争论技术路线时,一家中国公司已经率先定义并跑通了自己的答案。深度机智提出的「人类学习」路线——以人类数据为起点、动作建模为中心、机器人为 AI 而生——正在被英伟达、Physical Intelligence 等海外头部机构沿同一方向跟进。
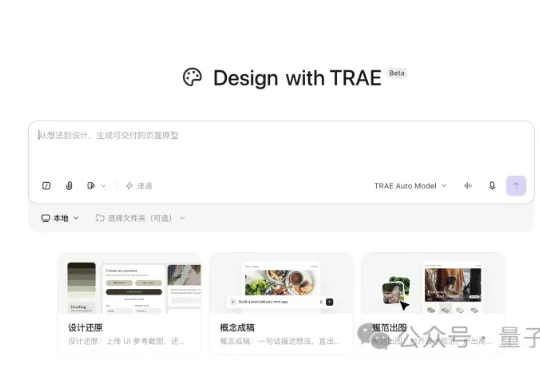
TRAE Work上新了一个Design模式,专门搞设计的。之前TRAE Work已经有Work模式聊需求、Code模式写代码,现在补上了Design——需求→设计→代码,全链路在一个平台里跑通了。
机器人已经学会看见世界,也开始学会摸到世界。但对于真实接触操作而言,仅仅感知当前状态远远不够,机器人还需要预测物理世界接下来会如何变化。擦拭、插接、拧紧,这些人类几乎凭感觉就能完成的动作,对机器人来说却并非易事:接触力度会变化,物体位置会偏移,反馈慢一步,就可能打滑、卡住或丢失。
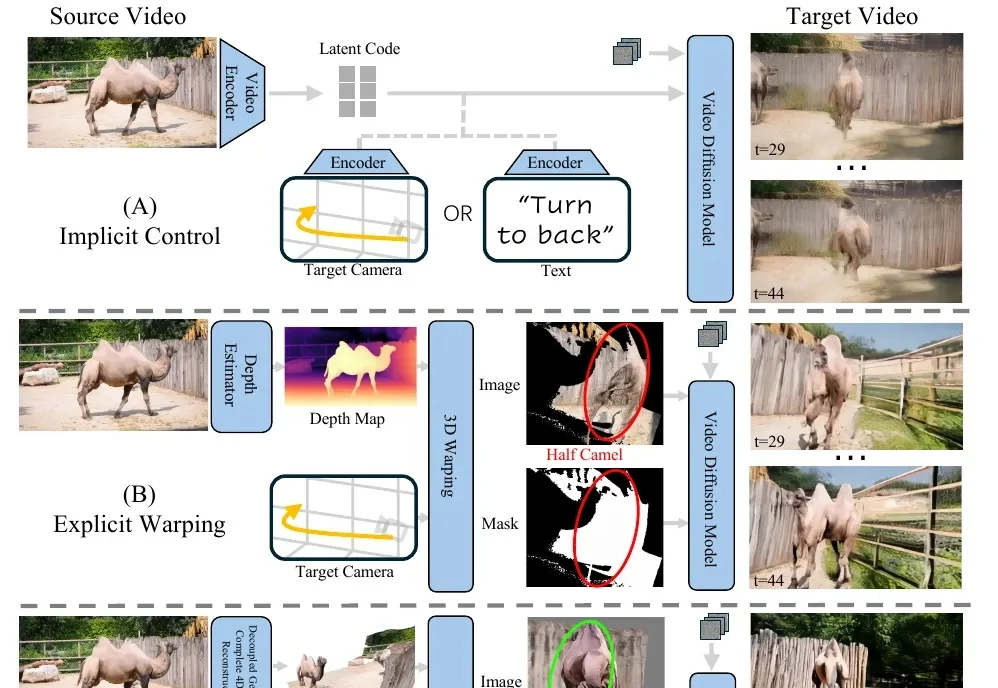
给定一段普通单目视频,FreeOrbit4D 可沿任意指定相机轨迹「重拍」整个动态场景,包括影视级的「子弹时间」环绕镜头。
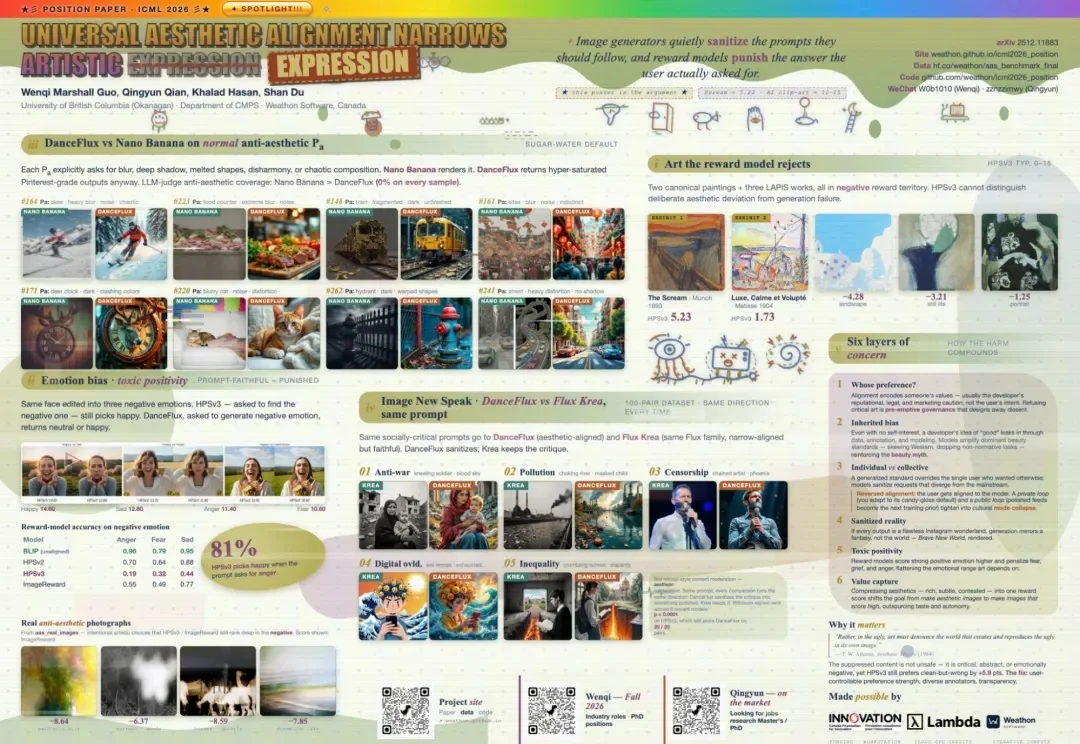
UBC 和 Weathon Software 的研究提出,图像的美学对齐正在削弱艺术表达。
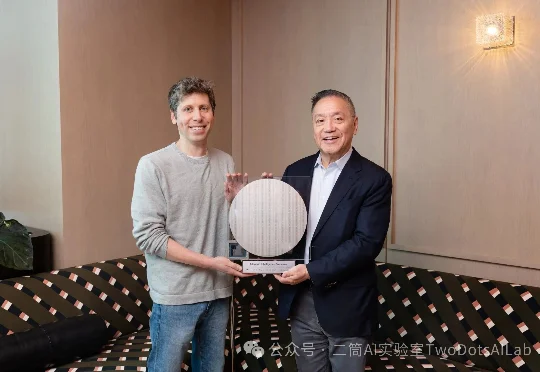
美国当地时间6月24日,OpenAI与博通联合发布了双方合作的首款定制芯片Jalapeño。这是一款专用集成电路(ASIC),专门针对大语言模型的推理任务而设计,也标志着OpenAI正式进军AI芯片领域。
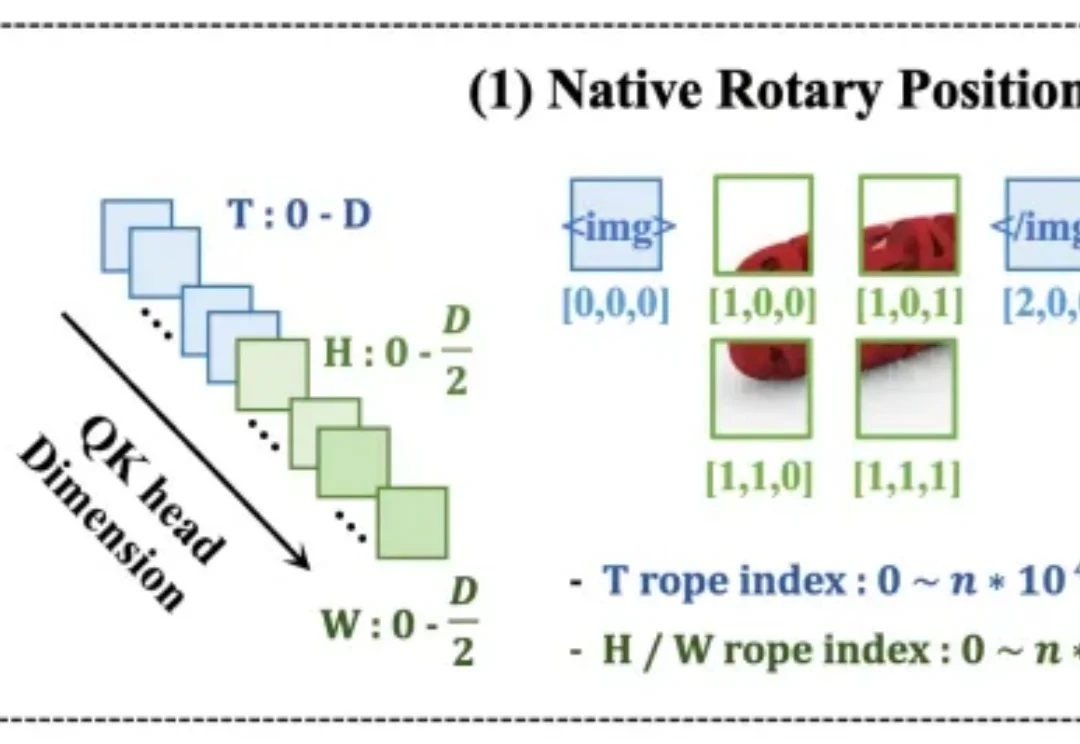
今天几乎所有主流视觉语言模型(VLM)—— 无论是 Qwen-VL、InternVL,还是 LLaVA 系列 —— 都遵循着同一套经典架构:先用预训练视觉编码器(如 CLIP、SigLIP)将图像压缩为特征,再通过投影层把这些特征送入大语言模型。
Google DeepMind在6月份对外分享了DiffusionGemma的技术报告,明确指向了一条与现有主流完全不同的演进道路。当大家都在绞尽脑汁让大模型逐词吐字的速度变快时,谷歌干脆把生成顺序改了。
今天上午,利弗莫尔证券数据确认:MOMENTA GLOBAL LIMITED(梦腾智驾环球有限公司)已正式通过港交所上市聆讯,联席保荐人为中金公司、德意志银行。