
超越π0.5,复旦团队首创「世界模型+具身训练+强化学习」闭环框架
超越π0.5,复旦团队首创「世界模型+具身训练+强化学习」闭环框架Vision–Language–Action(VLA)策略正逐渐成为机器人迈向通用操作智能的重要技术路径:这类策略能够在统一模型内同时处理视觉感知、语言指令并生成连续控制信号。
来自主题: AI技术研报
10883 点击 2025-12-05 09:27

 搜索
Vision–Language–Action(VLA)策略正逐渐成为机器人迈向通用操作智能的重要技术路径:这类策略能够在统一模型内同时处理视觉感知、语言指令并生成连续控制信号。

AI 创业卷出新高度,AI 都可以自己设计芯片了。
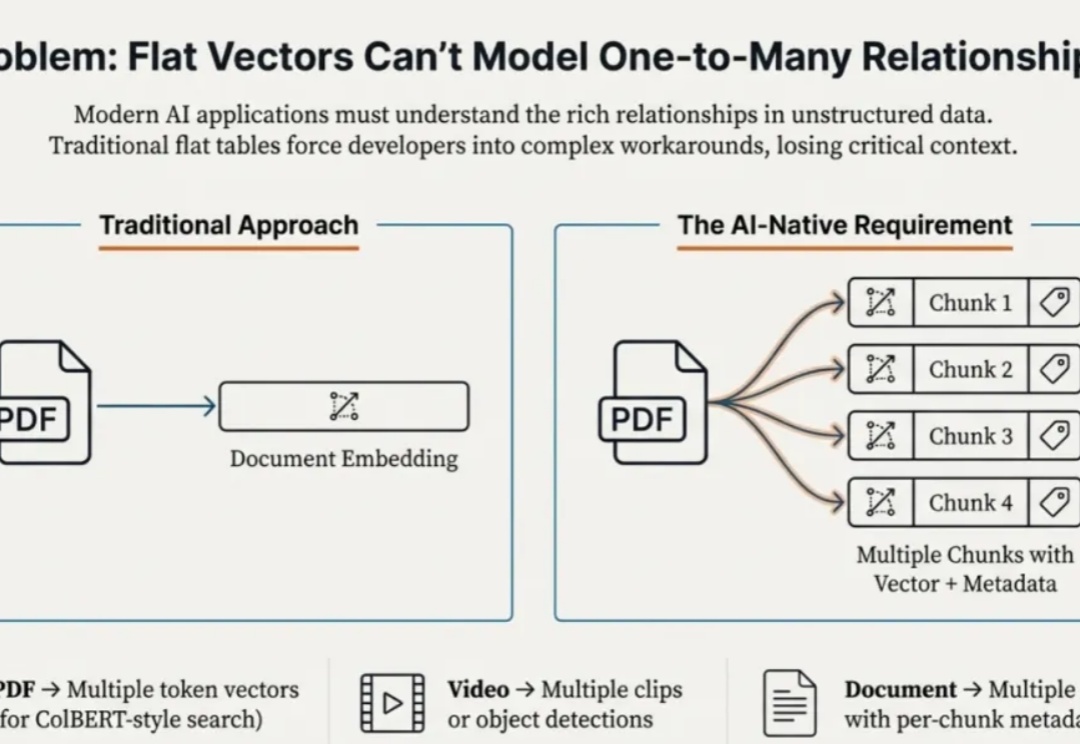
本文为Milvus Week系列第二篇,该系列旨在分享Zilliz、Milvus在系统性能、索引算法和云原生架构上的创新与实践,以下是DAY2内容划重点: Struct Array + MAX_SIM ,能够让数据库看懂 “多向量组成一个实体” 的逻辑,进而原生返回业务要的完整结果

在 Vision-Language Model 领域,提升其复杂推理能力通常依赖于耗费巨大的人工标注数据或启发式奖励。这不仅成本高昂,且难以规模化。

终于,几天前登上 Artificial Analysis 榜首的神秘模型 Whisper Thunder (aka) David 现出了真身。

AI创业赛道,即将迎来一名15岁少年博士——还是量子物理学方向的博士。

今天,谷歌生成式AI团队发布了Nano-Banana的首个官方教程——《The Complete Guide to Nano Banana Pro: 10 Tips for Professional Asset Production》。核心信息是如何用 Nano-Banana Pro 制作专业级的素材!

最近,一位被誉为「比利时小爱因斯坦」的 15 岁少年 Laurent Simons 在安特卫普大学(University of Antwerp)成功通过了博士论文答辩,获得了量子物理学博士学位。
CB Insights 发布的《2025 Future Tech Hotshots:Scouting Reports》报告,结合生成式 AI 分析与专有 Mosaic 评分体系,从全球海量初创企业中遴选出 45 家最具潜力的科技公司。

REG 是一种简单而有效的方法,仅通过引入一个 class token 便能大幅加速生成模型的训练收敛。其将基础视觉模型(如 DINOv2)的 class token 与 latent 在空间维度拼接后共同加噪训练,从而显著提升 Diffusion 的收敛速度与性能上限。在 ImageNet 256×256 上,