
9岁女孩靠AI「万能钥匙」赚到第一桶金!OpenAI新CEO的六大野心
9岁女孩靠AI「万能钥匙」赚到第一桶金!OpenAI新CEO的六大野心Fidji Simo以Instacart CEO的成功经验,加入OpenAI管理层。这份备忘录展示了她的宏大愿景:让AI成为知识、健康和创意的钥匙,打破资源壁垒,重塑人类的生活方式。
来自主题: AI资讯
7169 点击 2025-07-23 12:55

 搜索
Fidji Simo以Instacart CEO的成功经验,加入OpenAI管理层。这份备忘录展示了她的宏大愿景:让AI成为知识、健康和创意的钥匙,打破资源壁垒,重塑人类的生活方式。
AMD携手Stability AI宣布推出世界首款适用于Stable Diffusion 3.0 Medium的B16 NPU模型。该模型可直接运行于AMD XDNA 2 NPU之上,能够显著提升图像生成质量。新模型作为Amuse 3.1平台的组件之一亮相,于今天一起发布。
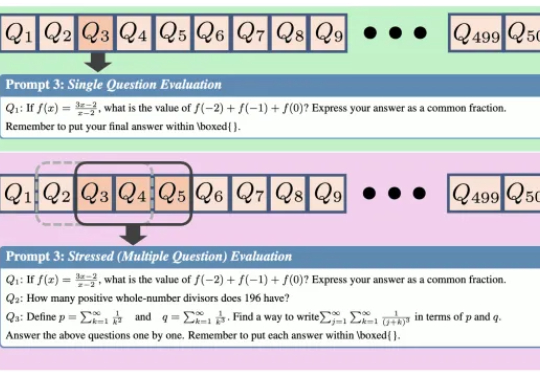
给AI一场压力测试,结果性能暴跌近30%。 来自上海人工智能实验室、清华大学和中国人民大学的研究团队设计了一个全新的“压力测试”框架——REST (Reasoning Evaluation through Simultaneous Testing)。
Transformer杀手来了?KAIST、谷歌DeepMind等机构刚刚发布的MoR架构,推理速度翻倍、内存减半,直接重塑了LLM的性能边界,全面碾压了传统的Transformer。网友们直呼炸裂:又一个改变游戏规则的炸弹来了。
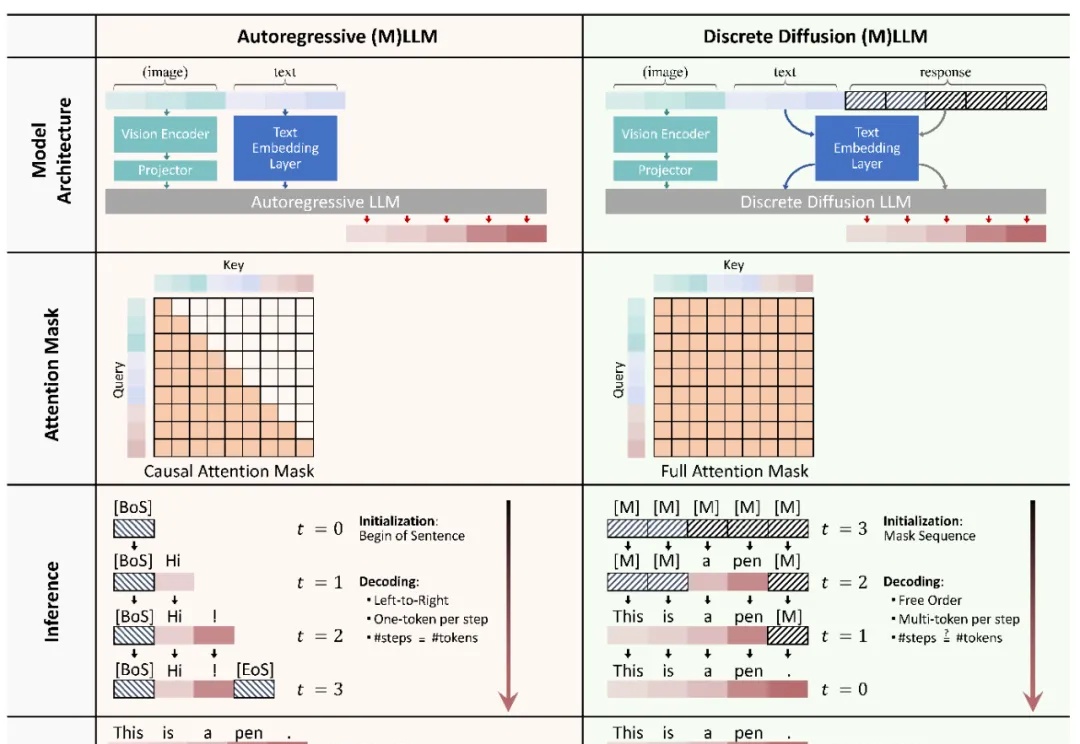
本文主要介绍 xML 团队的论文:Discrete Diffusion in Large Language and Multimodal Models: A Survey。
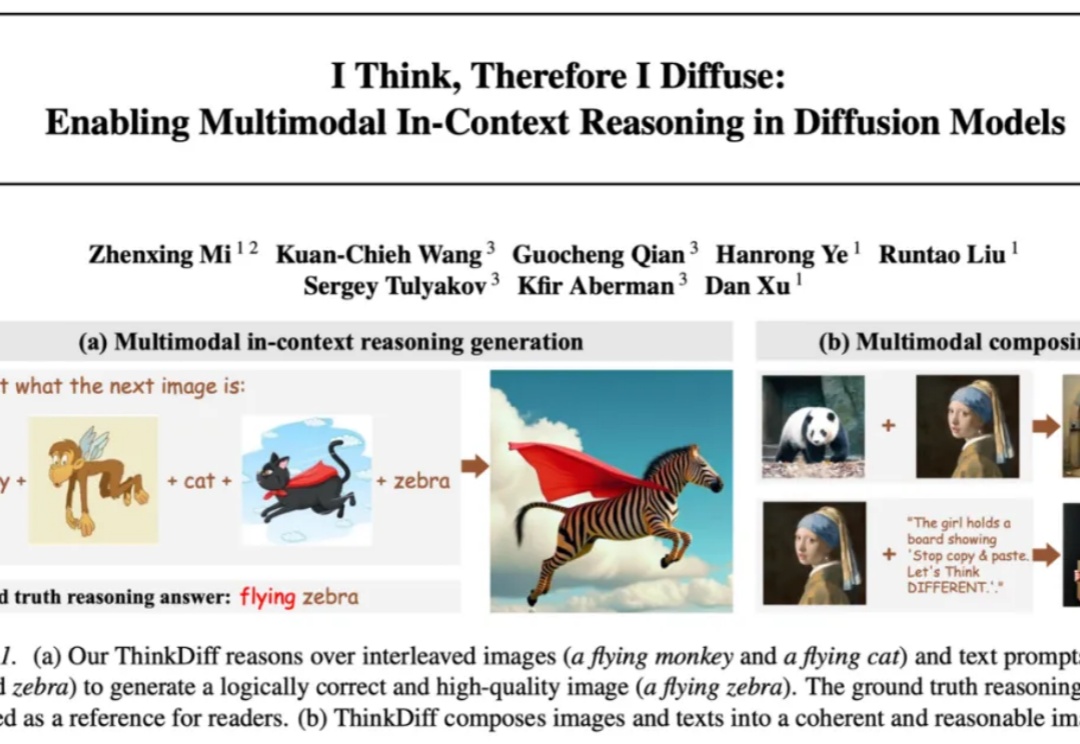
自 Stable Diffusion、Flux 等扩散模型 (Diffusion models) 席卷图像生成领域以来,文本到图像的生成技术取得了长足进步。但它们往往只能根据精确的文字或图片提示作图,缺乏真正读懂图像与文本、在多模 态上下文中推理并创作的能力。能否让模型像人类一样真正读懂图像与文本、完成多模态推理与创作,一直是学术界和工业界关注的热门问题。
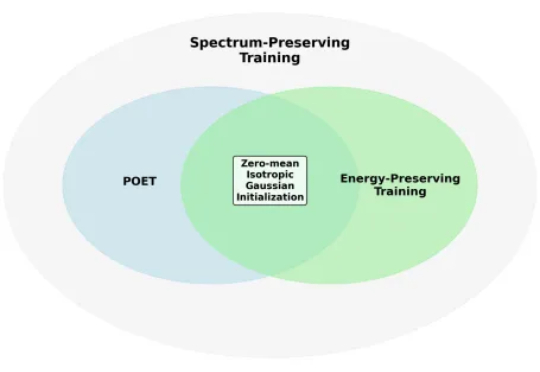
Zeju Qiu和Tim Z. Xiao是德国马普所博士生,Simon Buchholz和Maximilian Dax担任德国马普所博士后研究员
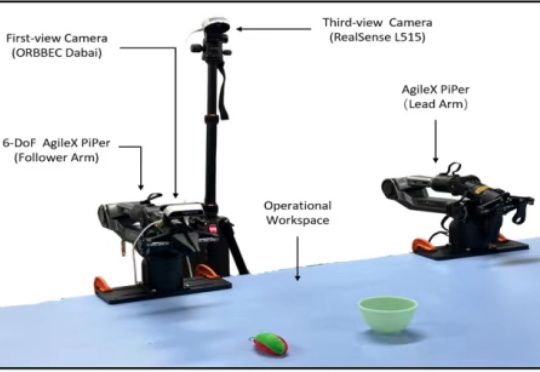
近年来,视觉 - 语言 - 动作(Vision-Language-Action, VLA)模型因其出色的多模态理解与泛化能力,已成为机器人领域的重要研究方向。尽管相关技术取得了显著进展,但在实际部署中,尤其是在高频率和精细操作等任务中,VLA 模型仍受到推理速度瓶颈的严重制约。
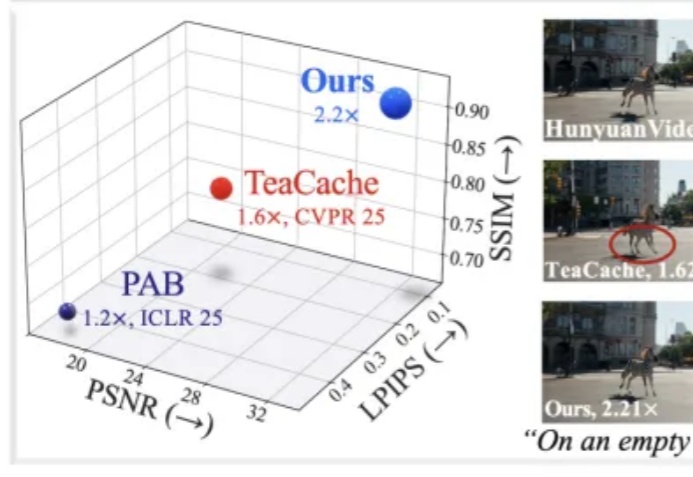
近年来,随着扩散模型(Diffusion Models)和扩散 Transformer(DiT)在视频生成领域的广泛应用,AI 合成视频的质量和连贯性有了飞跃式提升。像 OpenAI Sora、HunyuanVideo、Wan2.1 等大模型,已经能够生成结构清晰、细节丰富且高度连贯的长视频内容,为数字内容创作、虚拟世界和多媒体娱乐带来了巨大变革。
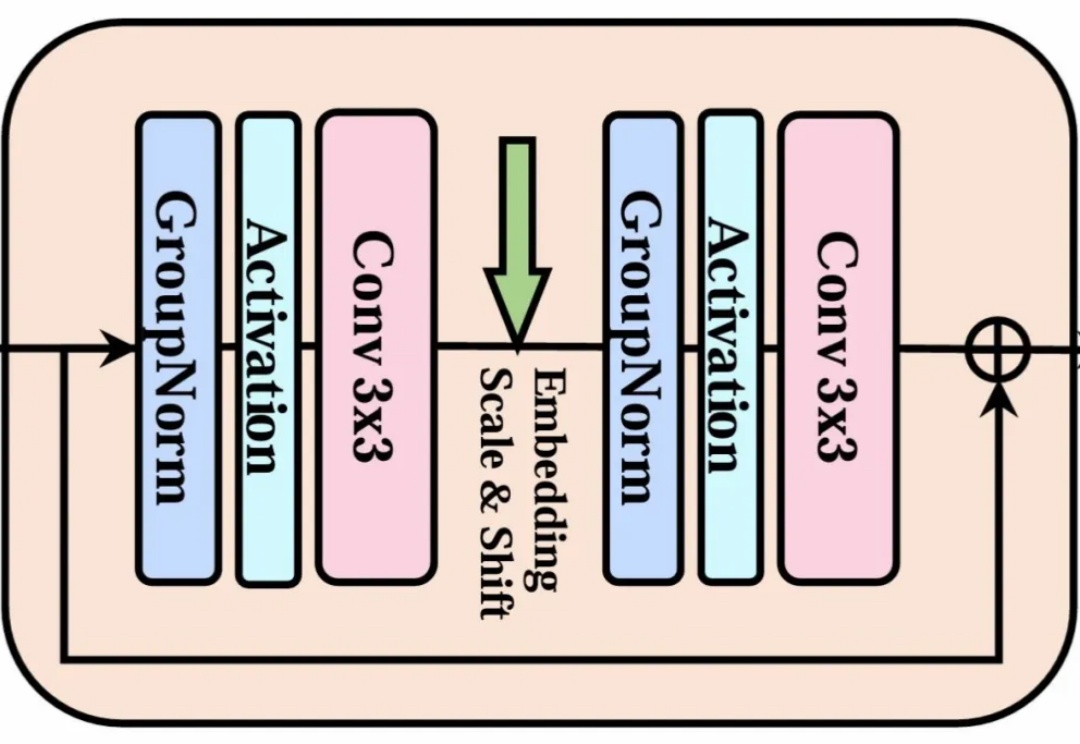
当整个 AI 视觉生成领域都在 Transformer 架构上「卷生卷死」时,一项来自北大、北邮和华为的最新研究却反其道而行之,重新审视了深度学习中最基础、最经典的模块——3x3 卷积。