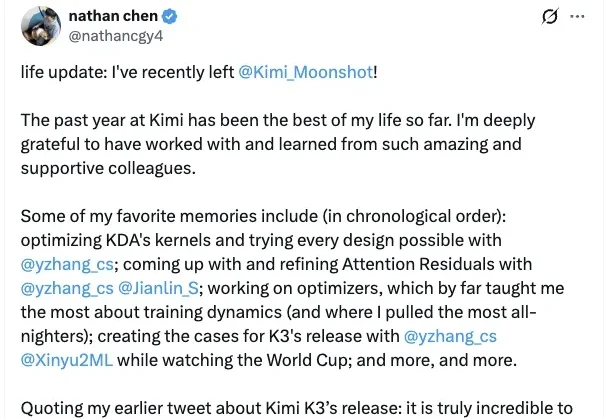
17岁天才少年陈广宇,宣布离开Kimi
17岁天才少年陈广宇,宣布离开Kimi今天,曾因 Attention Residuals 论文走红的 AI 少年陈广宇(Nathan Chen),宣布离开 Kimi。
来自主题: AI资讯
11200 点击 2026-10-16 12:10

 搜索
今天,曾因 Attention Residuals 论文走红的 AI 少年陈广宇(Nathan Chen),宣布离开 Kimi。
Z Potentials 独家获悉,Xspark AI(无界智航)近日完成新一轮融资。本轮融资由猎道投资、华山资本、元航资本、浦东创投、钧源资本、南山战新投、水木创投等机构共同参与,多维资本担任本轮融资独家财务顾问。
Z Potentials 独家获悉,上海半图科技(SemiGraph)已完成单轮超过千万美元融资,由联想创投等多家国内及海外一线资本领投,老股东IDG资本持续加码。本轮融资将主要用于人类行为模型研发、数据体系建设、团队扩充,以及AI原生3D互动场景的产品化落地。
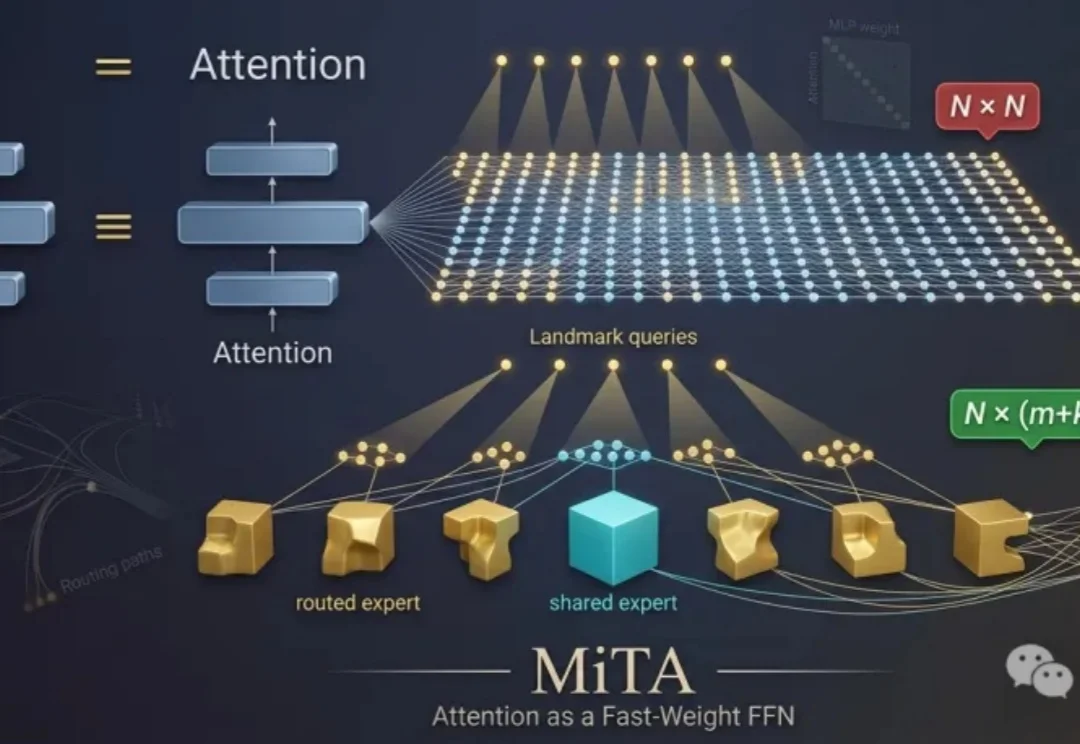
一直以来,在Transformer架构中,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)被认为是两个功能不同且互补的模块: 前者让词元(Token)彼此交互,后者对每个词元进行非线性变换。
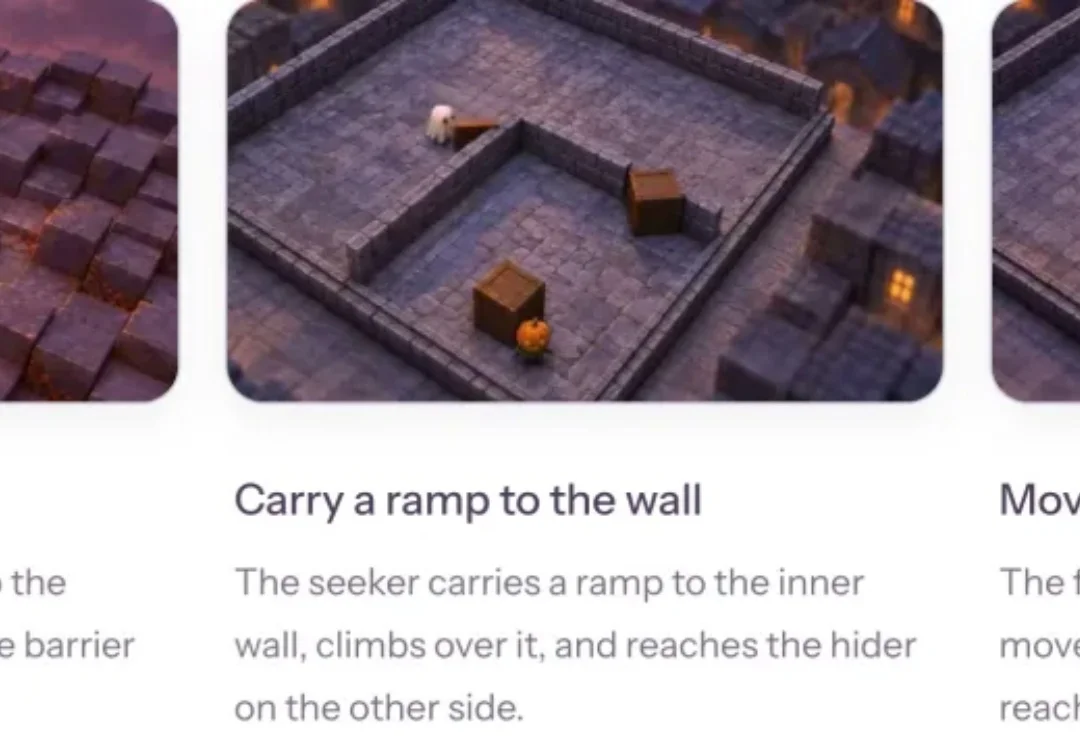
推开一块挡板,通道就此封闭;搬来一段坡道,高墙便有了越过的可能。
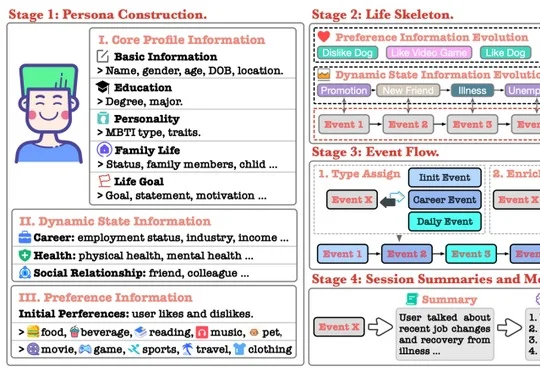
中国电信研究院与MemTensor等机构提出首个面向智能体记忆系统的操作级幻觉评测基准HaluMem,已被EMNLP 2026主会接收,该基准分别对记忆提取、更新和问答三个环节进行检查,并对Mem0、MemOS等六套系统实测,发现高召回率可能伴随虚假信息写入、低更新幻觉率背后存在大量遗漏、上游记忆问题最终会影响回答等核心现象。
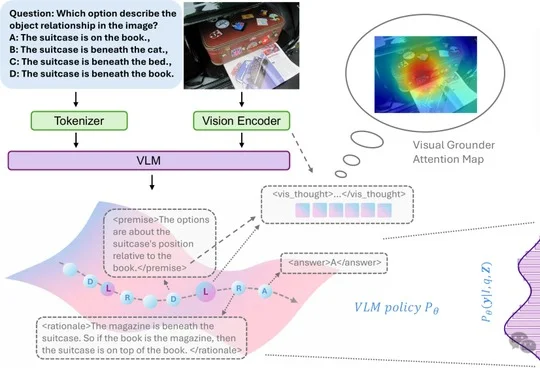
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
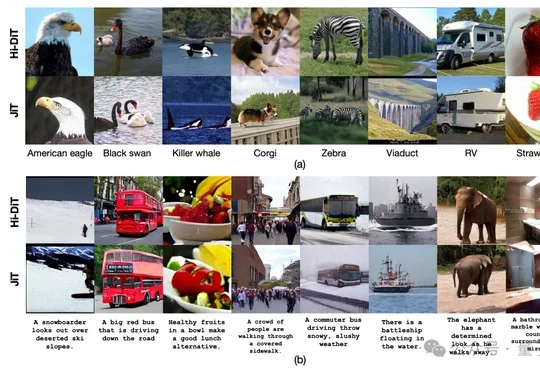
中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
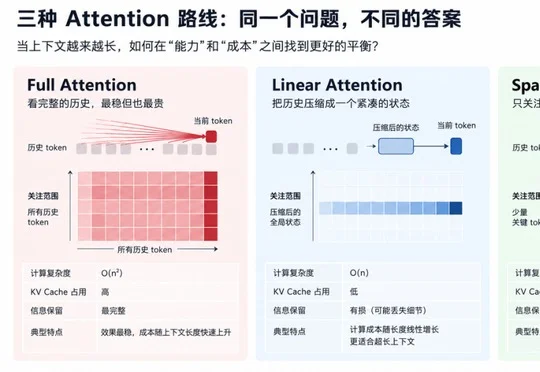
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
Z Potentials获悉,Physical AI公司息壤开物近日连续完成数亿元种子轮及天使轮融资,目前估值达5亿美元。本轮融资由敦鸿资产领投,华控基金、三花控股、银杏谷资本、泽然资本、本坚基金、天使基石、标朴投资等机构跟投。募集资金将主要用于原生物理AI模型的规模预训练、真实物理交互数据建设、核心研发人才引入及场景验证。