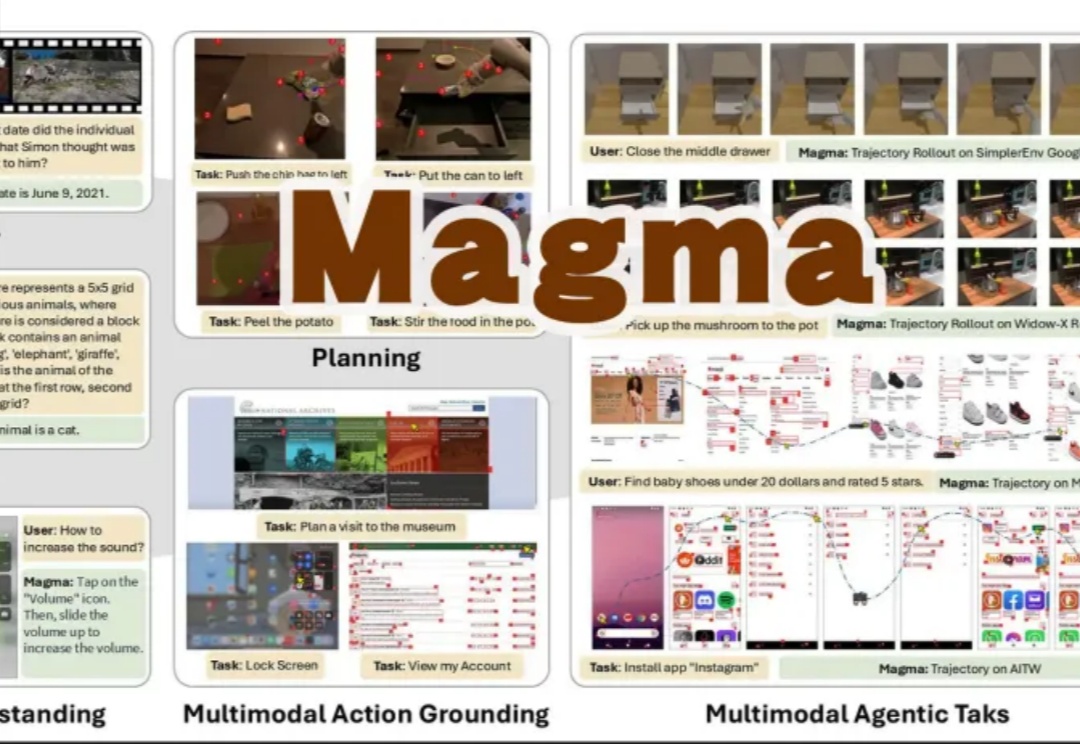
具身智能新时代!VLA迎来最强基础模型Magma:UI导航、机器人操作全能
具身智能新时代!VLA迎来最强基础模型Magma:UI导航、机器人操作全能Magma是一个新型多模态基础模型,能够理解和执行多模态任务,适用于数字和物理环境:通过标记集合(SoM)和标记轨迹(ToM)技术,将视觉语言数据转化为可操作任务,显著提升了空间智能和任务泛化能力。
来自主题: AI技术研报
8319 点击 2025-03-11 10:49

 搜索
Magma是一个新型多模态基础模型,能够理解和执行多模态任务,适用于数字和物理环境:通过标记集合(SoM)和标记轨迹(ToM)技术,将视觉语言数据转化为可操作任务,显著提升了空间智能和任务泛化能力。
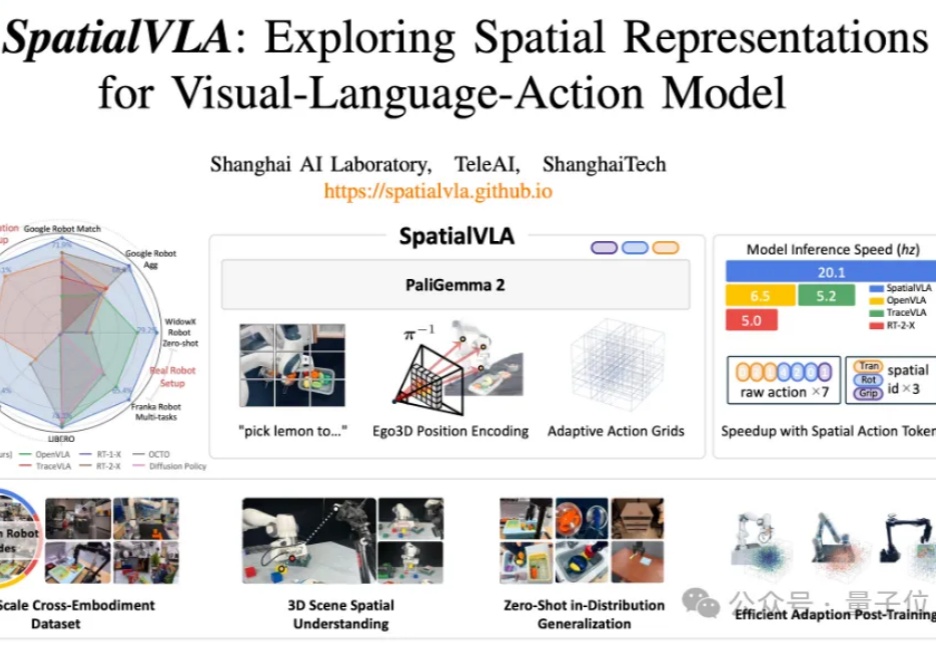
与3D物理环境交互、适应不同机器人形态并执行复杂任务的通用操作策略,一直是机器人领域的长期追求。
因为就在岁末年初,一种全新的技术范式正在开启落地,头部玩家有了爆款证明,引领行业跟进对齐,隐隐成为共识趋势……这种技术范式,就是——VLA。
今天,银河通用机器人发布了端到端具身抓取基础大模型「GraspVLA」,全球第一个预训练完全基于仿真合成大数据的具身大模型,展现出了比OpenVLA、π0、RT-2、RDT等模型更全面强大的泛化性和真实场景实用潜力。
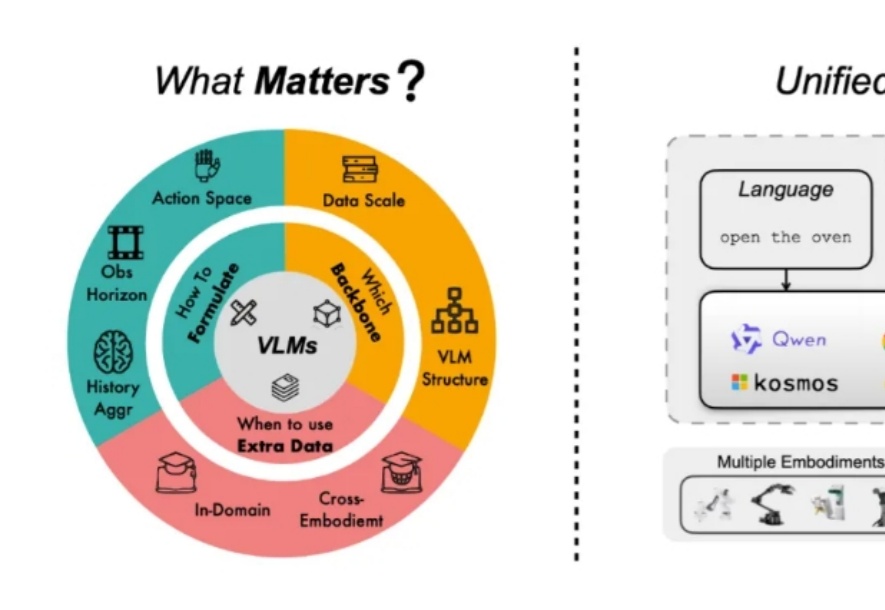
近年来,视觉语言基础模型(Vision Language Models, VLMs)大放异彩,在多模态理解和推理上展现出了超强能力。现在,更加酷炫的视觉语言动作模型(Vision-Language-Action Models, VLAs)来了!通过为 VLMs 加上动作预测模块,VLAs 不仅能 “看” 懂和 “说” 清,还能 “动” 起来,为机器人领域开启了新玩法!
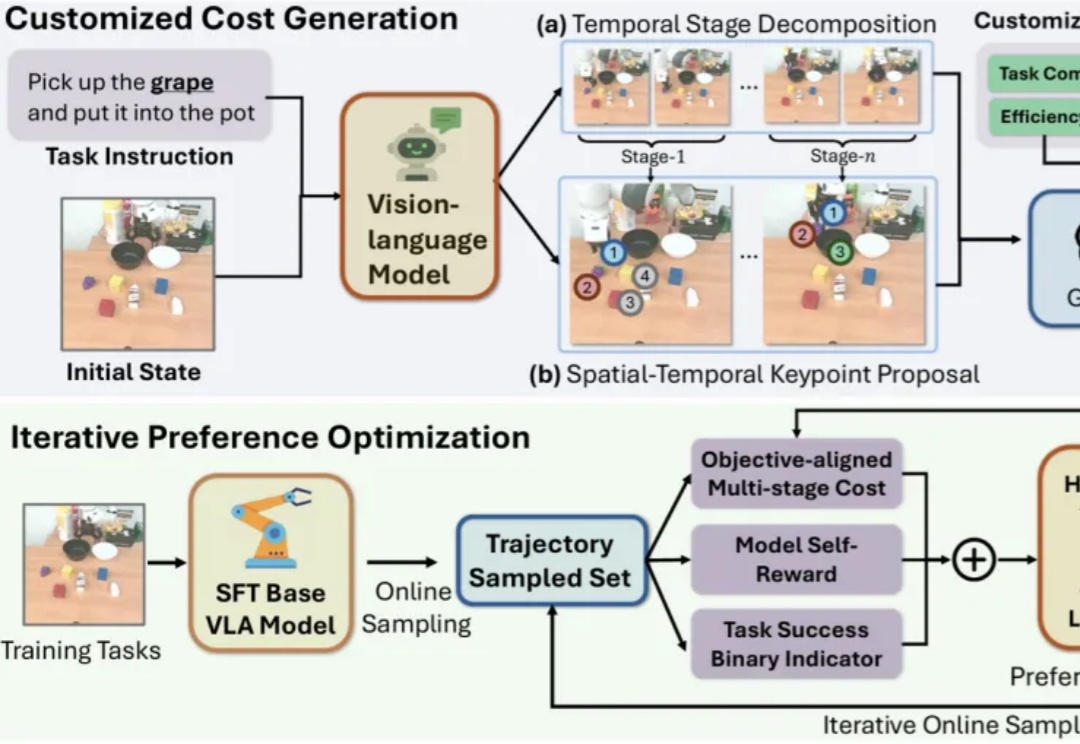
近年来,视觉-语言-动作模型(Vision-Language-Action, VLA)在诸多机器人任务上取得了显著的进展,但它们仍面临一些关键问题,例如由于仅依赖从成功的执行轨迹中进行行为克隆,导致对新任务的泛化能力较差。
2024 年,理想汽车以突破 100 万辆的累计交付量成为中国智能电动车市场的一大亮点。然而,在这一辉煌背后,理想汽车正迎来一场前所未有的转型。
2024年,智驾领域最热的词,就是“端到端”。甚至,到了不聊端到端都没法出门的程度。
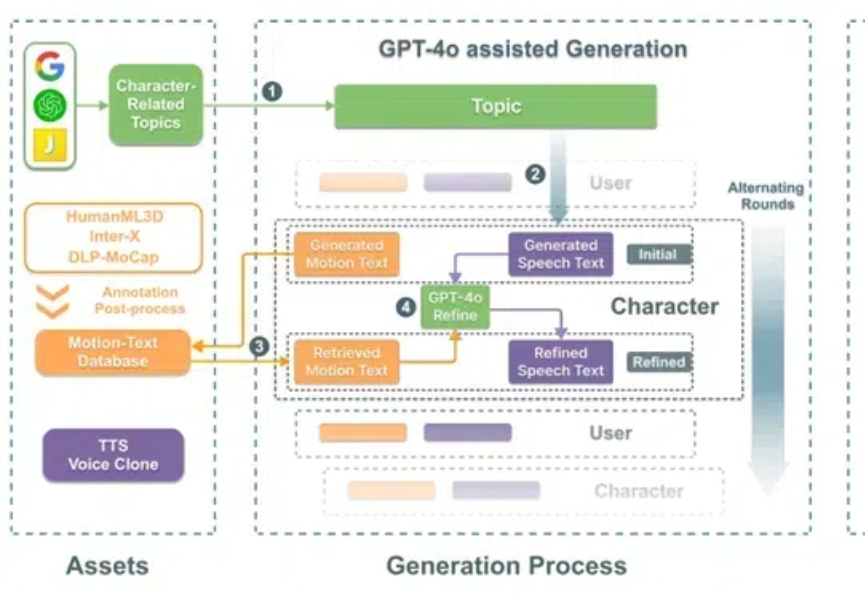
SOLAMI是一个创新的VR端3D角色扮演AI系统,用户可以通过语音和肢体语言与虚拟角色进行沉浸式互动。该系统利用先进的社交视觉-语言-行为模型,结合合成的数据集,提供更自然的交流体验,超越了传统的文本和语音交互。
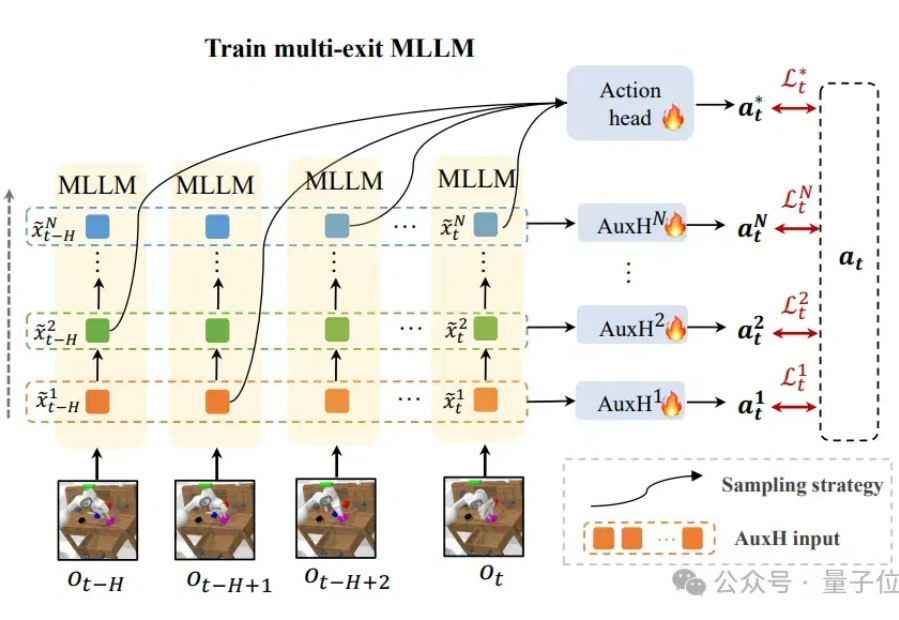
计算、存储消耗高,机器人使用多模态模型的障碍被解决了! 来自清华大学的研究者们设计了DeeR-VLA框架,一种适用于VLA的“动态推理”框架,能将LLM部分的相关计算、内存开销平均降低4-6倍。