专访 VideoPoet 作者:视频模型技术会收敛,LLM 将取代diffusion带来真正的视觉智能
专访 VideoPoet 作者:视频模型技术会收敛,LLM 将取代diffusion带来真正的视觉智能在 AI 领域,近年来各个子领域都逐渐向 transformer 架构靠拢,只有文生图和文生视频一直以 diffusion + u-net 结构作为主流方向。diffusion 有更公开可用的开源模型,消耗的计算资源也更少。
搜索
在 AI 领域,近年来各个子领域都逐渐向 transformer 架构靠拢,只有文生图和文生视频一直以 diffusion + u-net 结构作为主流方向。diffusion 有更公开可用的开源模型,消耗的计算资源也更少。
扩散模型在图像生成方面取得了显著的成功,但由于对输出保真度和时间一致性的高要求,将这些模型应用于视频超分辨率仍然具有挑战性,特别是其固有的随机性使这变得复杂。
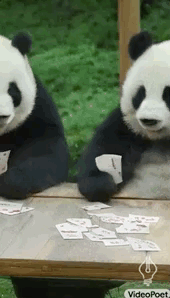
你敢信?大熊猫都会打牌了!
谷歌全新视频生成模型VideoPoet再次引领世界!十秒超长视频生成效果碾压Gen-2,还可进行音频生成,风格转化。
后期狂喜了家人们~现在,只需一张图片就能替换视频主角,效果还是如此的丝滑!且看这个叫做“VideoSwap”的新视频编辑模型——
最近,来自北京大学等机构研究者提出了一种全新视觉语言大模型——Video-LLaVA,使得LLM能够同时接收图片和视频为输入。Video-LlaVA在下游任务中取得了卓越的性能,并在图片、视频的13个基准上达到先进的性能。这个结果表明,统一LLM的输入能让LLM的视觉理解能力提升。
Stable Diffusion官方终于对视频下手了——发布生成式视频模型Stable Video Diffusion(SVD)。
Stability AI 的视频生成模型看来效果不错。AI 画图的著名公司 Stability AI,终于入局 AI 生成视频了。本周二,基于 Stable Diffusion 的视频生成模型 Stable Video Diffusion 来了,AI 社区马上开始了热议。
AI能理解搞笑视频笑点在哪里了。北大等团队开源视觉语言大模型Video-LLaVA,将图像和视频表示对齐到统一的视觉特征空间,在13个图片和视频基准上达到先进的性能。
提到视频生成,很多人首先想到的可能是 Gen-2、Pika Labs。但刚刚,Meta 宣布,他们的视频生成效果超过了这两家,而且编辑起来还更加灵活。