从o1-mini到DeepSeek-R1,万字长文带你读懂推理模型的历史与技术
从o1-mini到DeepSeek-R1,万字长文带你读懂推理模型的历史与技术自 OpenAI 发布 o1-mini 模型以来,推理模型就一直是 AI 社区的热门话题,而春节前面世的开放式推理模型 DeepSeek-R1 更是让推理模型的热度达到了前所未有的高峰。
来自主题: AI技术研报
10811 点击 2025-02-24 14:40

 搜索
自 OpenAI 发布 o1-mini 模型以来,推理模型就一直是 AI 社区的热门话题,而春节前面世的开放式推理模型 DeepSeek-R1 更是让推理模型的热度达到了前所未有的高峰。
如何让大模型感知知识图谱知识?
省一半算力跑出2倍效果,月之暗面开源优化器Muon,同预算下全面领先。
DeepSeek 懂的都懂,从爆火那天起,官方就常年“服务器繁忙“,想问个问题,比春运抢票还难。
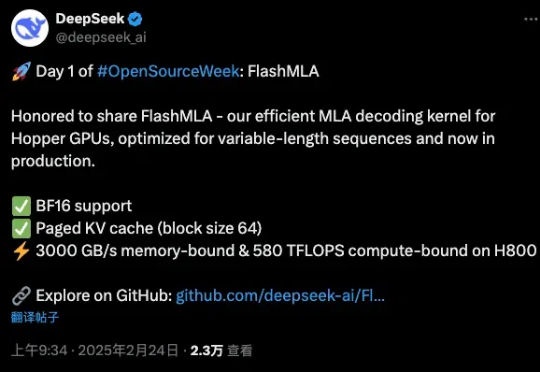
刚刚,万众瞩目的DeepSeek,开源了他们第一天的项目。FlashMLA是一款面向Hopper GPU的高效MLA解码内核,并针对可变长度序列的服务场景进行了优化。
本周一,阿里巴巴集团CEO吴泳铭抛出了炸弹——未来三年将投入超3800亿元建设云和AI硬件基础设施。这个金额,不仅创下了中国民营企业在该领域有史以来最大规模的投资纪录,更像一枚投入湖面的巨石,在中国科技产业激起层层涟漪。
DeepSeek开源周第一天就放大招!FlashMLA强势登场,这是专为英伟达Hopper GPU打造MLA解码内核。注意,DeepSeek训练成本极低的两大关键,一个是MoE,另一个就是MLA。

猜想界的皇冠——黎曼猜想,离被证明的那一天不远了。Grok 3便是关键所在:暴力计算+验证器能让AI穷举所有解法,再加上AI辅助科学家打出的组合拳,下一个诺奖级突破近在咫尺。
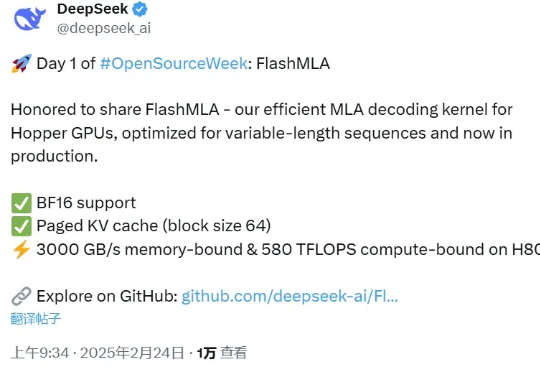
上周五,DeepSeek 发推说本周将是开源周(OpenSourceWeek),并将连续开源五个软件库。第一个项目,果然与推理加速有关。北京时间周一上午 9 点,刚一上班(同时是硅谷即将下班的时候),DeepSeek 兑现了自己的诺言,开源了一款用于 Hopper GPU 的高效型 MLA 解码核:FlashMLA。
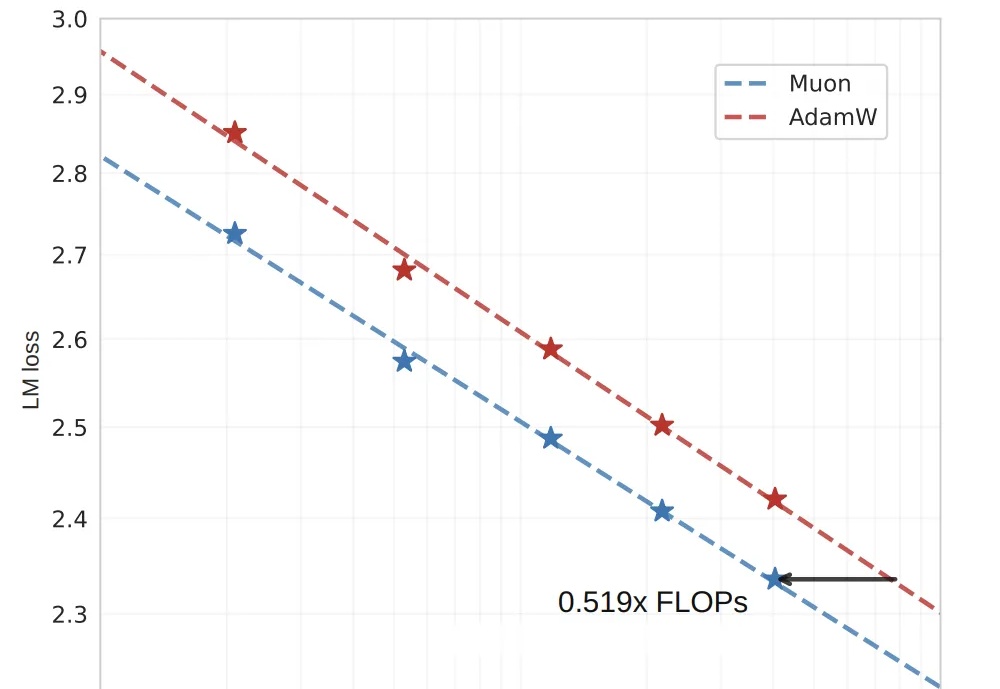
算力需求比AdamW直降48%,OpenAI技术人员提出的训练优化算法Muon,被月之暗面团队又推进了一步!