Meta新研究挑战CV领域基操:ViT根本不用patch,用像素做token效果更佳
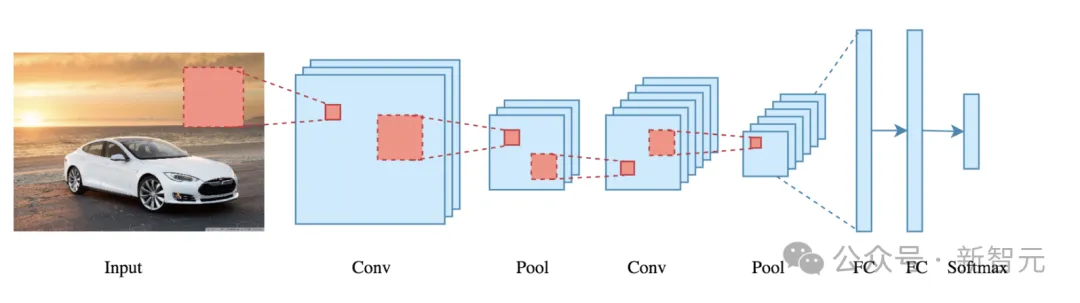
Meta新研究挑战CV领域基操:ViT根本不用patch,用像素做token效果更佳下一代视觉模型会摒弃patch吗?Meta AI最近发表的一篇论文就质疑了视觉模型中局部关系的必要性。他们提出了PiT架构,让Transformer直接学习单个像素而不是16×16的patch,结果在多个下游任务中取得了全面超越ViT模型的性能。
搜索
下一代视觉模型会摒弃patch吗?Meta AI最近发表的一篇论文就质疑了视觉模型中局部关系的必要性。他们提出了PiT架构,让Transformer直接学习单个像素而不是16×16的patch,结果在多个下游任务中取得了全面超越ViT模型的性能。
今日,Odyssey视觉AI发布预告,这款获得GV 900万美元种子资金的创新技术,旨在用AI技术讲好电影故事。具备强大的视觉内容生成与控制能力,视觉效果对标好莱坞制作水平。
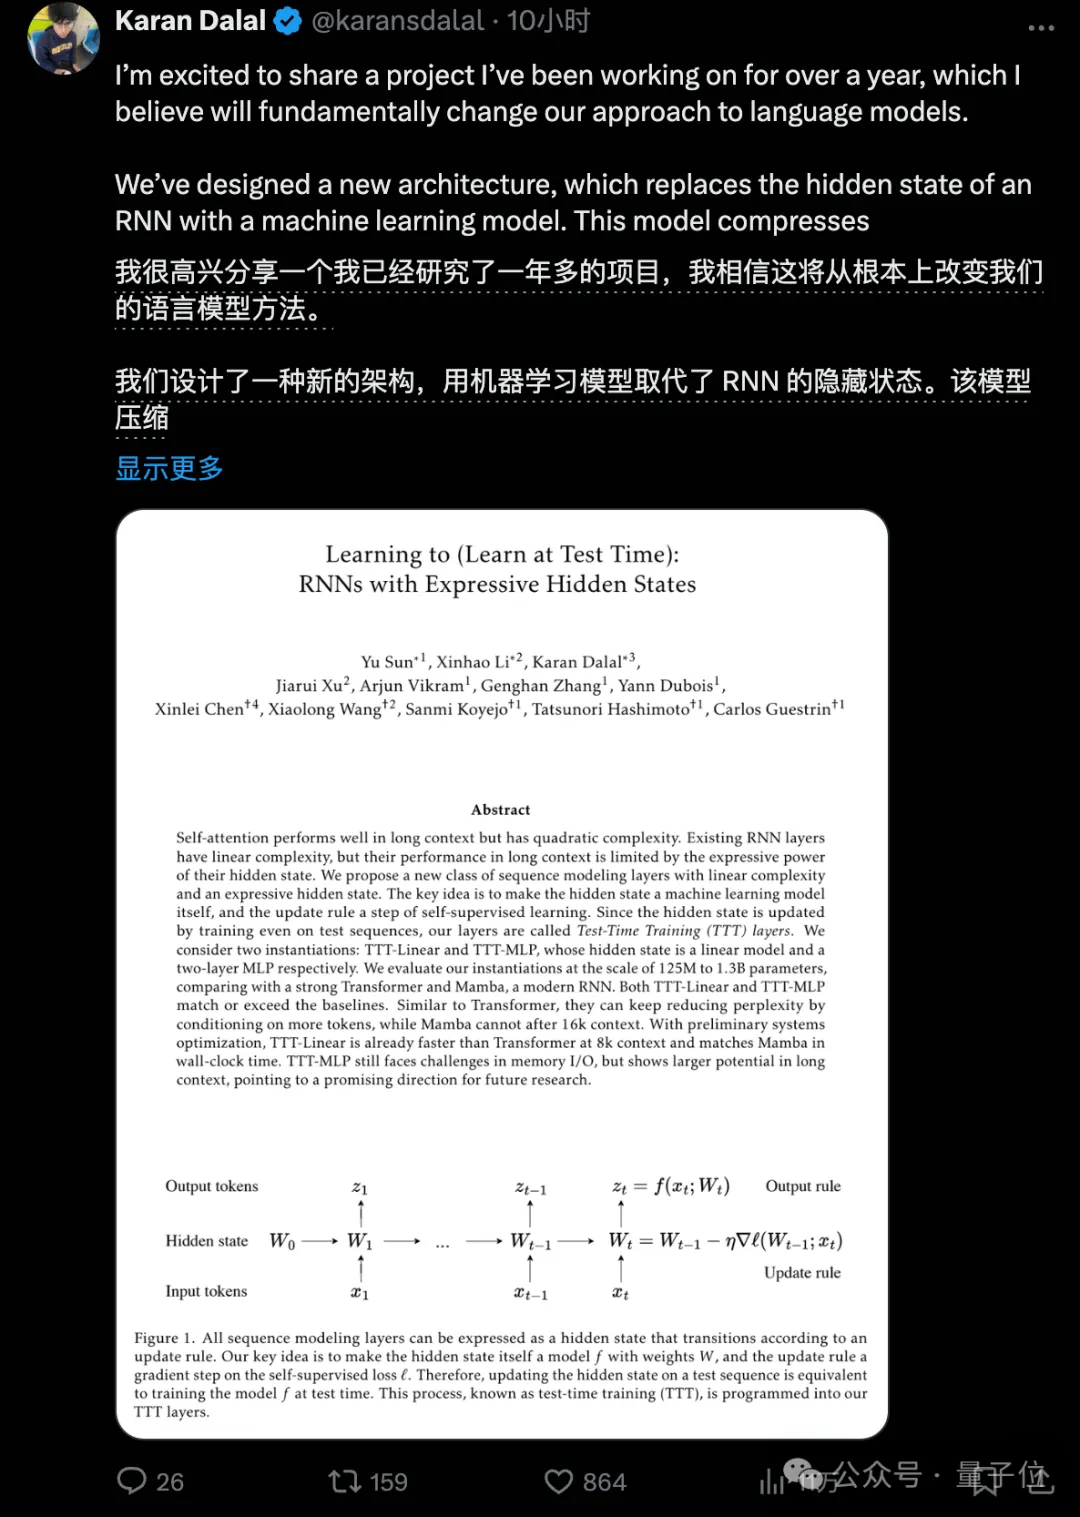
超越Transformer和Mamba的新架构,刚刚诞生了。斯坦福UCSD等机构研究者提出的TTT方法,直接替代了注意力机制,语言模型方法从此或将彻底改变。
人类采访了机器人,足足一个多小时,还是对答如流的那种!
好莱坞级视觉AI横空出世!一个demo已令网友疯狂~
新架构,再次向Transformer发起挑战!
尽管生成式AI现阶段并不完美,但绝对称得上是量大管饱。
WHO 表示,1/3 的癌症可以通过早发现、早治疗得以治愈。
AI终将重塑教育行业
Anthropic首席执行官表示,当前AI模型训练成本是10亿美元,未来三年,这个数字可能会上升到100亿美元甚至1000亿美元。要知道,GPT-4o这个曾经最大的模型也只用了1亿美元。千亿美刀,究竟花在了哪里?