从RLHF到DPO再到TDPO,大模型对齐算法已经是「token-level」
从RLHF到DPO再到TDPO,大模型对齐算法已经是「token-level」在人工智能领域的发展过程中,对大语言模型(LLM)的控制与指导始终是核心挑战之一,旨在确保这些模型既强大又安全地服务于人类社会。早期的努力集中于通过人类反馈的强化学习方法(RLHF)来管理这些模型,成效显著,标志着向更加人性化 AI 迈出的关键一步。
来自主题: AI技术研报
6881 点击 2024-06-23 19:39

 搜索
在人工智能领域的发展过程中,对大语言模型(LLM)的控制与指导始终是核心挑战之一,旨在确保这些模型既强大又安全地服务于人类社会。早期的努力集中于通过人类反馈的强化学习方法(RLHF)来管理这些模型,成效显著,标志着向更加人性化 AI 迈出的关键一步。
如何判断一个AI模型是否属于开源阵营?开源or闭源,到底哪种系统才更安全?最近,两位荷兰学者发表的一篇ACM FAccT论文给出了富有卓见的回答。

AI淘汰大部分人类似乎就是一场终局。OpenAI CTO在采访中称,一些创意性的工作会消失。今天,她再次发长文佐证自己的观点。而现在,AI取代大厂的一大批员工真真实实发生了。
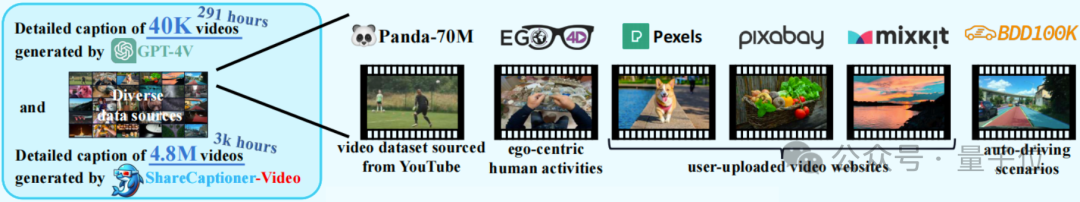
中科大、上海AI实验室等组成的ShareGPT4V团队,推出了新的视频数据集,登顶HuggingFace排行榜!
刚刚,OpenAI收购了数据库初创公司Rockset。

“鸿蒙原生智能”Harmony Intelligence来了!

明明是最懂大 DAU 应用的大模型创业者,却最晚发布 toC 应用;

“从横向来看,我们显然仍与国际顶尖工作如Sora和GPT-4o有显著差距;同时,从纵向来看,我们已经从十几年的nobody,快速成长为人工智能科技创新的关键推动者。面向即将到来的AGI时代,我们应该更加自信积极地投身其中。”
GPT-5延期?

国内大模型公司在AI应用层的步伐正在加速。