里程碑时刻!100B扩散语言模型跑出892 Tokens /秒,AI的另一条路走通了
里程碑时刻!100B扩散语言模型跑出892 Tokens /秒,AI的另一条路走通了扩散语言模型(dLLM),这个曾被认为是「小众赛道」的研究方向,如今终于迎来了质变。
来自主题: AI技术研报
10519 点击 2026-02-11 15:26

 搜索
扩散语言模型(dLLM),这个曾被认为是「小众赛道」的研究方向,如今终于迎来了质变。
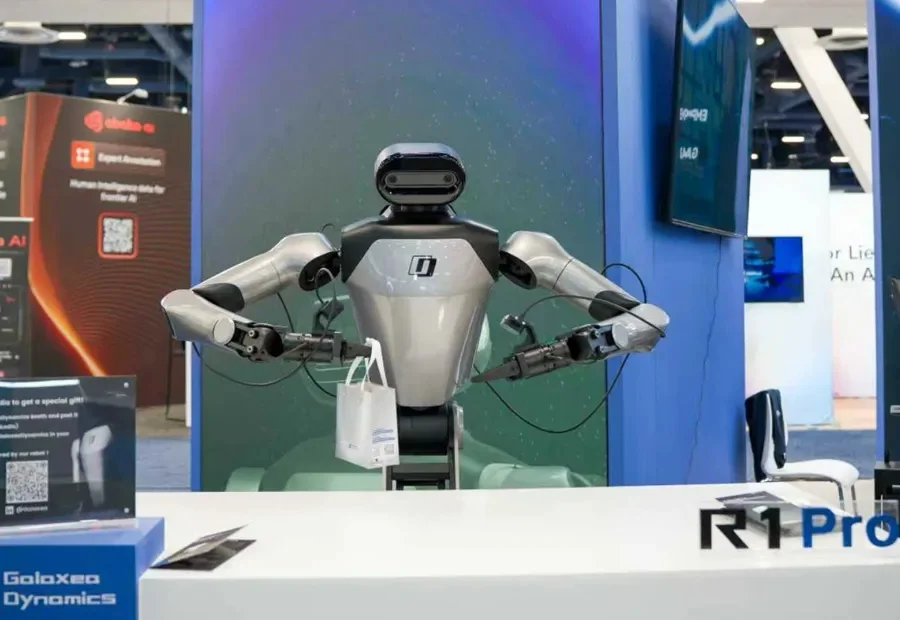
CEO高继扬判断,2026年下半年,具身智能将进入 “成果验证”阶段。
Anthropic刚刚扔出一份18页重磅炸弹:《2026年智能体编码趋势报告》。结论直接炸裂:程序员不再写代码了,他们变成了「指挥官」。
过去几年,AI 行业几乎把所有注意力都投向了“会不会想”:更强的推理、更大的模型、更快的生成。但在真实世界里,很多问题并不是想不想得出来,而是你到底记不记得发生过什么——尤其是视频。
思考token在精不在多。Yuan 3.0 Flash用RAPO+RIRM双杀过度思考,推理token砍75%,网友们惊呼:这就是下一代AI模型的发展方向!

AI互动版抖音雏形出现了!
AI 时代,别搞虚的,真实才是必杀技。
硬氪获悉,AI智能运动穿戴品牌「苔源MossCode」近日完成数千万元天使轮融资,本轮由XVC和清流资本共同投资。
在十九世纪的暹罗王国曾诞生过这样一对连体兄弟:他们分别拥有完整的四肢和独立的大脑,但他们六十余年的人生被腰部相连着的一段不到十厘米的组织带永远绑定在了一起。他们的连体曾带来无尽的束缚,直到他们离开暹罗,走上马戏团的舞台。十年间,两兄弟以近乎合二为一的默契巡演欧美,获得巨大成功。
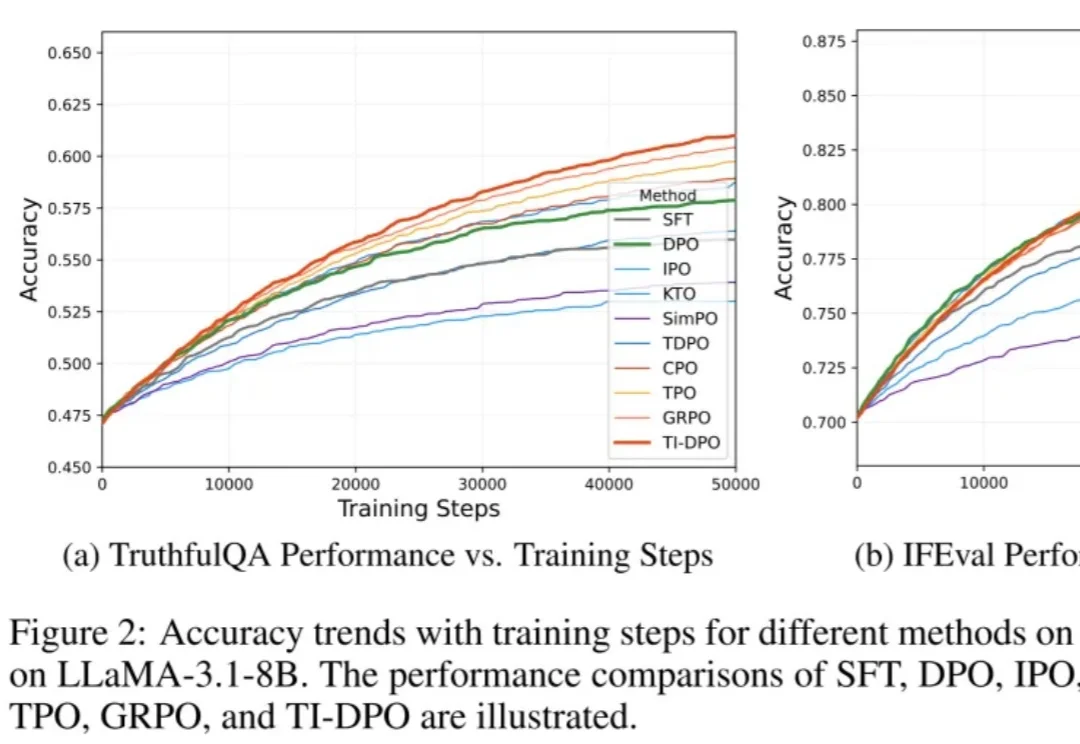
在当今的大模型后训练(Post-training)阶段,DPO(直接偏好优化) 凭借其无需训练独立 Reward Model 的优雅设计和高效性,成功取代 PPO 成为业界的 「版本之子」,被广泛应用于 Llama-3、Mistral 等顶流开源模型的对齐中。