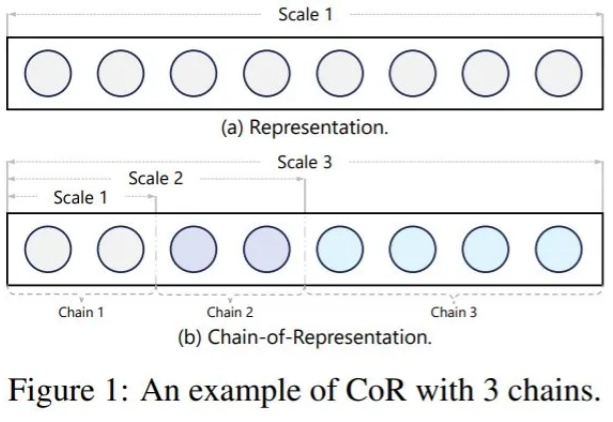
微软等提出「模型链」新范式,与Transformer性能相当,扩展性灵活性更好
微软等提出「模型链」新范式,与Transformer性能相当,扩展性灵活性更好随着大语言模型 (LLM) 的出现,扩展 Transformer 架构已被视为彻底改变现有 AI 格局并在众多不同任务中取得最佳性能的有利途径。因此,无论是在工业界还是学术界,探索如何扩展 Transformer 模型日益成为一种趋势。
来自主题: AI技术研报
9480 点击 2025-06-03 09:58

 搜索
随着大语言模型 (LLM) 的出现,扩展 Transformer 架构已被视为彻底改变现有 AI 格局并在众多不同任务中取得最佳性能的有利途径。因此,无论是在工业界还是学术界,探索如何扩展 Transformer 模型日益成为一种趋势。
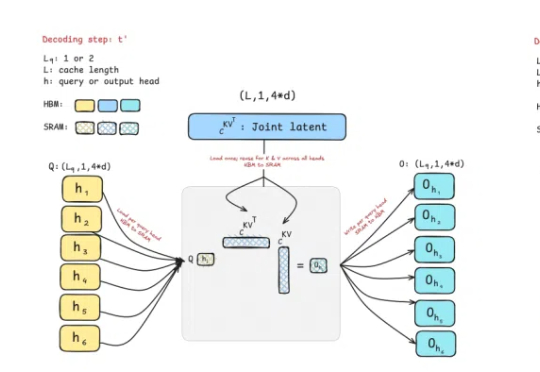
曾撼动Transformer统治地位的Mamba作者之一Tri Dao,刚刚带来新作——提出两种专为推理“量身定制”的注意力机制。
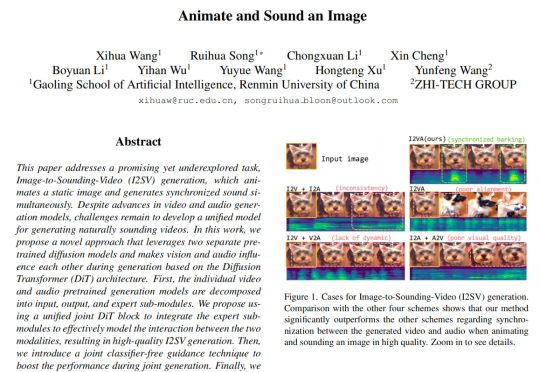
来自中国人民大学高瓴人工智能学院与值得买科技 AI 团队在 CVPR 2025 会议上发表了一项新工作,首次提出了一种从静态图像直接生成同步音视频内容的生成框架。其核心设计 JointDiT(Joint Diffusion Transformer)框架实现了图像 → 动态视频 + 声音的高质量联合生成。
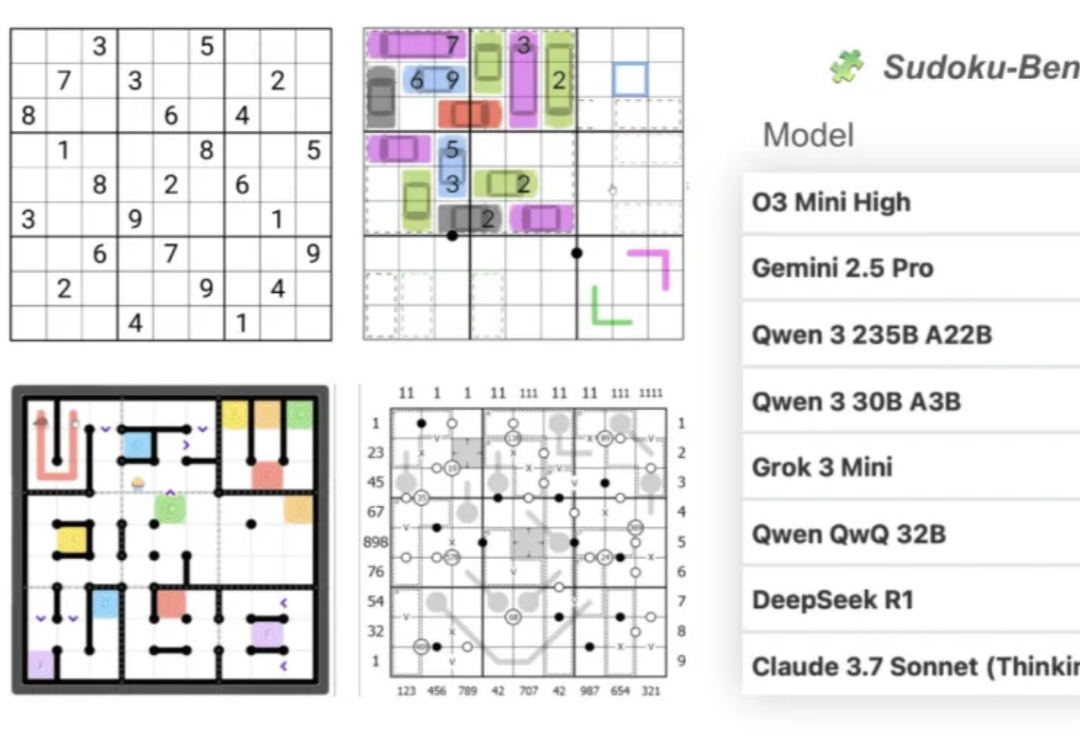
大模型做数独,总体正确率只有15%???
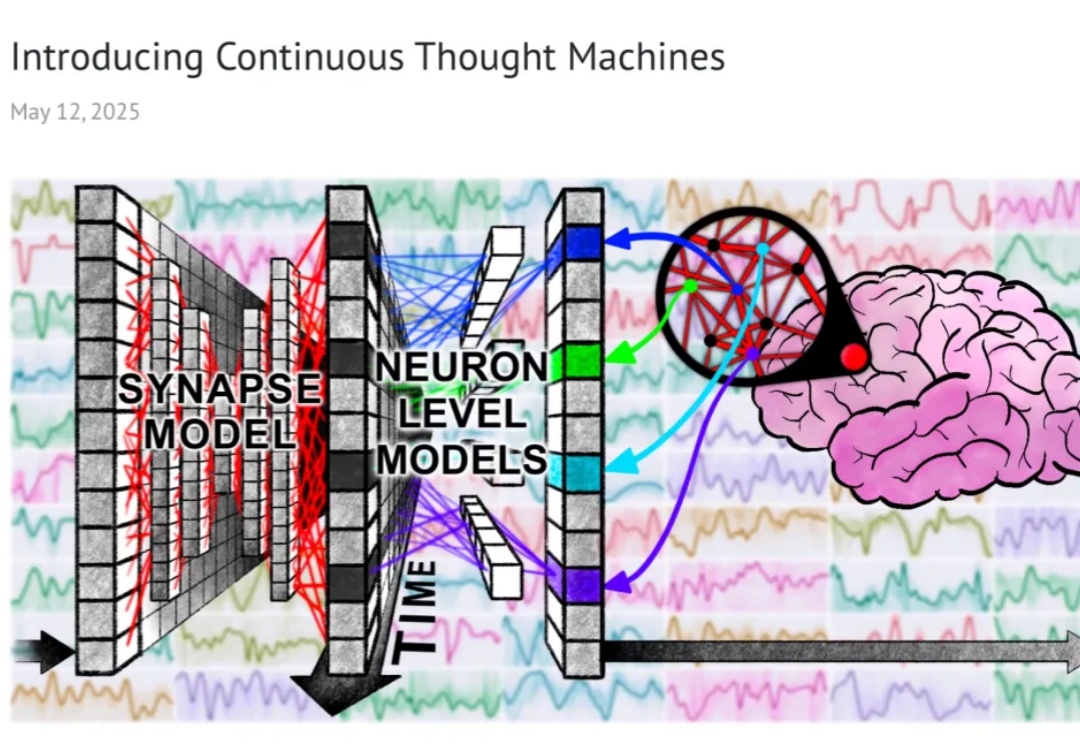
开启「分步思考」新范式。
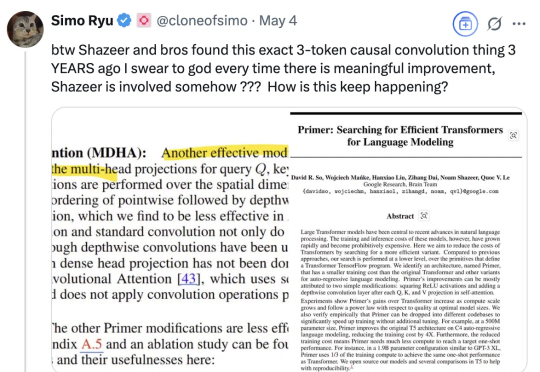
怎么老是你???(How old are you)尤其是最近Meta FAIR研究员朱泽园分享了他们《Physics of Language Models》项目的系列新进展后,有网友发现,其中提到的3-token因果卷积相关内容,沙哥等又早在三年前就有相关研究。这是最近网友不断对着Transformer八子之一的Noam Shazeer(为方便阅读,我们称他为沙哥)发出的灵魂疑问。
这篇论文包含了当前 LLM 的许多要素,十年后的今天或许仍值得一读。
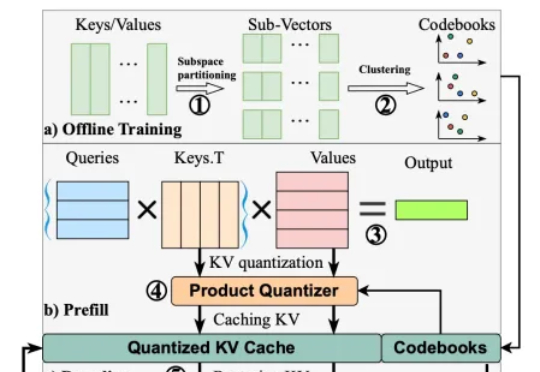
在以 transformer 模型为基础的大模型中,键值缓存虽然用以存代算的思想显著加速了推理速度,但在长上下文场景中成为了存储瓶颈。为此,本文的研究者提出了 MILLION,一种基于乘积量化的键值缓存压缩和推理加速设计。
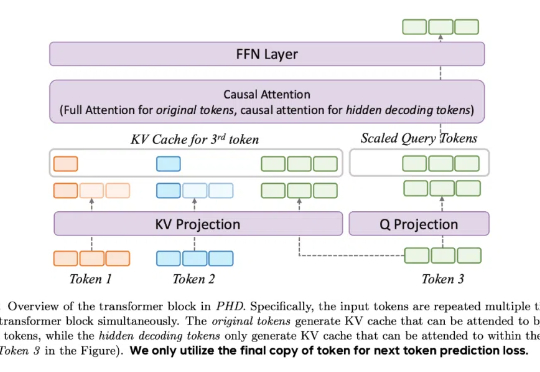
最近,DeepSeek-R1 和 OpenAI o1/03 等推理大模型在后训练阶段探索了长度扩展(length scaling),通过强化学习(比如 PPO、GPRO)训练模型生成很长的推理链(CoT),并在奥数等高难度推理任务上取得了显著的效果提升。
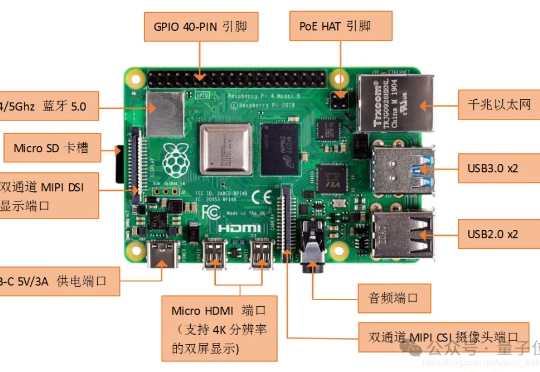
他们打造的端侧大模型已经可以在树莓派这样的微型设备上流畅运行,首批搭载Yan架构大模型的具身智能机器人也已经面世。当下AI算力竞赛愈演愈烈之际,他们的“低算力”“群体智能”之路正在获得更多关注。本期「大模型创新架构」主题访谈,量子位邀请到RockAI CEO刘凡平,聊聊他们选择非Transformer架构路线背后的故事,以及通过架构及算法创新实现AGI的技术愿景。