没想到,音频大模型开源最彻底的,居然是小红书
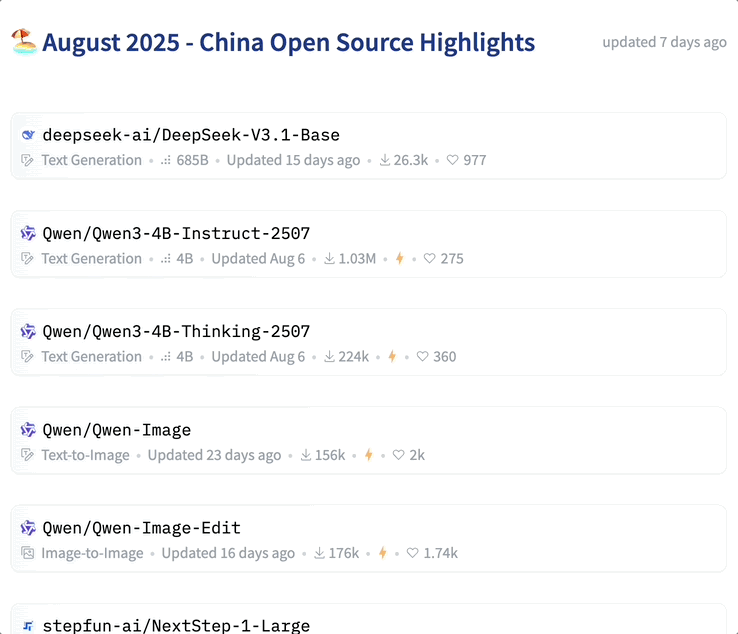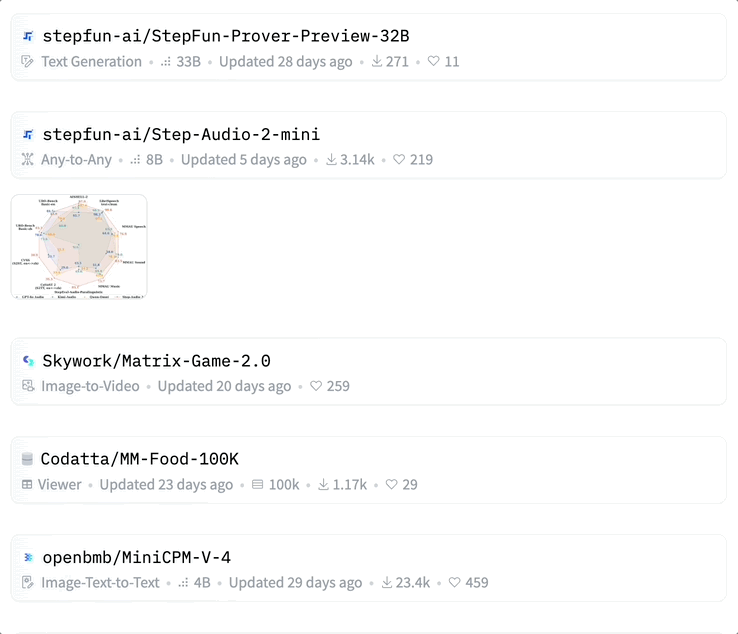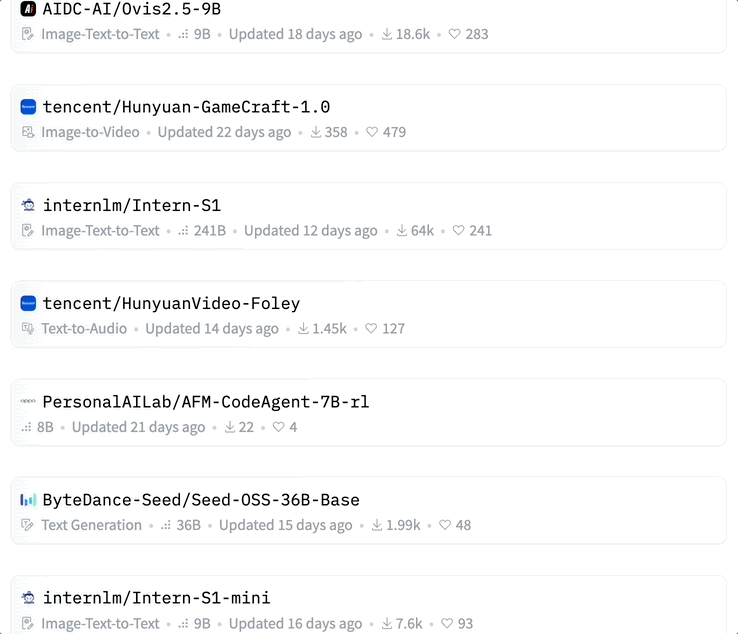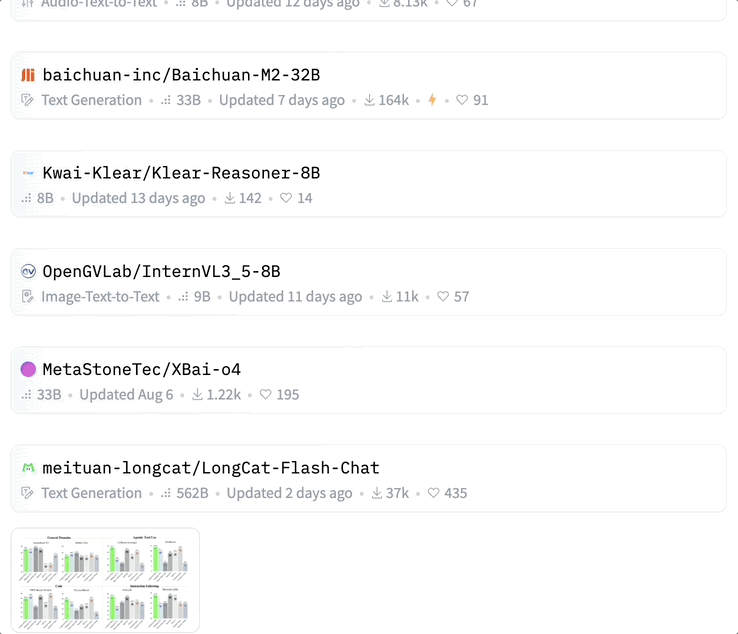
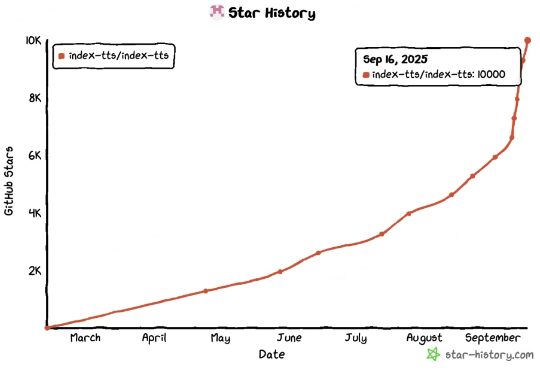
没想到,音频大模型开源最彻底的,居然是小红书不难发现,近几个月,开源频频成为 AI 社区热议的焦点。尤其是对于国内科技公司来说,开源成为主旋律。根据 Hugging Face 中文 AI 模型与资源社区的数据显示,国内厂商在七八月接连开源 33 款、31 款各类型大模型。
来自主题: AI资讯
11743 点击 2025-09-19 09:22

 搜索
不难发现,近几个月,开源频频成为 AI 社区热议的焦点。尤其是对于国内科技公司来说,开源成为主旋律。根据 Hugging Face 中文 AI 模型与资源社区的数据显示,国内厂商在七八月接连开源 33 款、31 款各类型大模型。
最近在 B 站上,你是否也刷到过一些 “魔性” 又神奇的 AI 视频?比如英文版《甄嬛传》、坦克飞天、曹操大战孙悟空…… 这些作品不仅完美复现了原角色的音色,连情感和韵律都做到了高度还原!更让人惊讶的是,它们居然全都是靠 AI 生成的!
订阅了 ElevenLabs 的小伙伴看过来,它的开源平替来了!Chatterbox 是全球首个支持强烈情绪控制的开源TTS 模型,更是号称开源 TTS 中的 SOTA ,由 Resemble AI 推出。
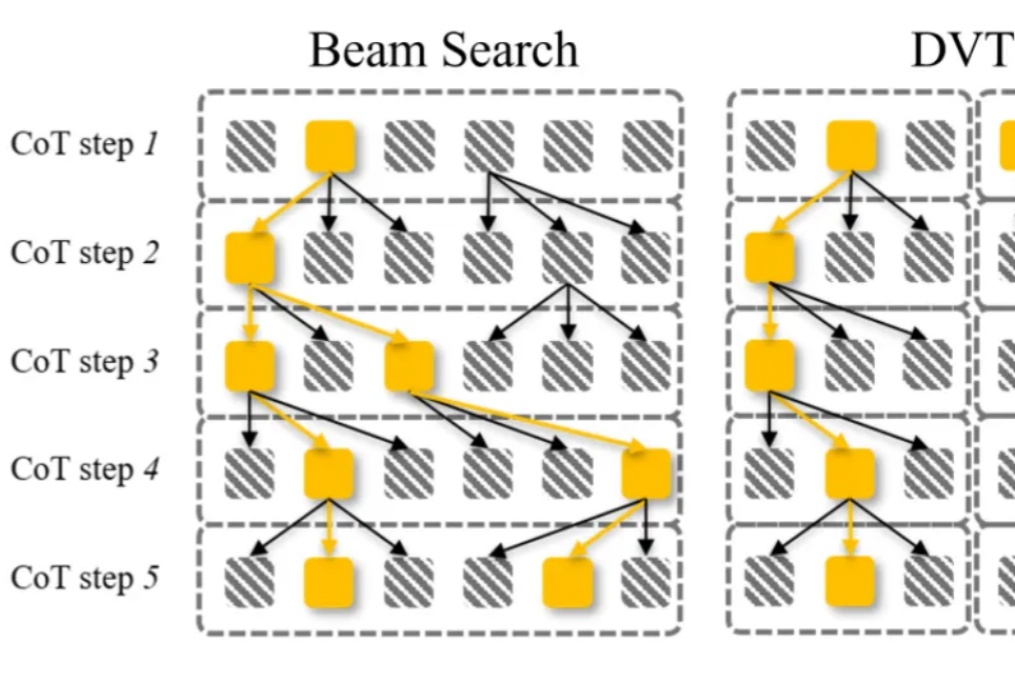
大语言模型通过 CoT 已具备强大的数学推理能力,而 Beam Search、DVTS 等测试时扩展(Test-Time Scaling, TTS)方法可通过分配额外计算资源进一步提升准确性。然而,现有方法存在两大关键缺陷:路径同质化(推理路径趋同)和中间结果利用不足(大量高质量推理分支被丢弃)。
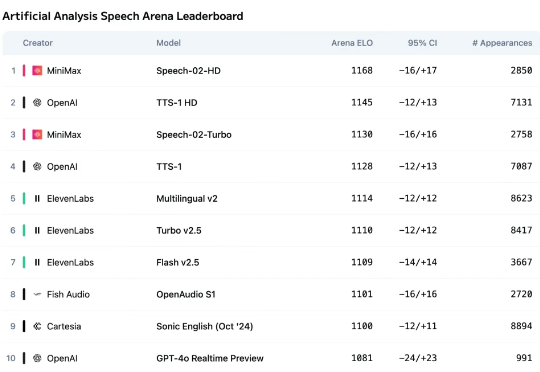
今天,MiniMax发布新一代语音生成模型Speech 2.5,再次刷新全球最强语音模型的上限。
FlowSpeech的开发初衷源于一个感人故事。一位年过八旬的美国老人因长期病痛失去说话能力,但通过AI工具ListenHub继续与他人分享自己的人生经历。这个真实案例启发了开发团队,促使他们研发出专门针对书面语向口语转换的TTS技术解决方案。
当甄嬛传、让子弹飞全都转英文,会怎样?
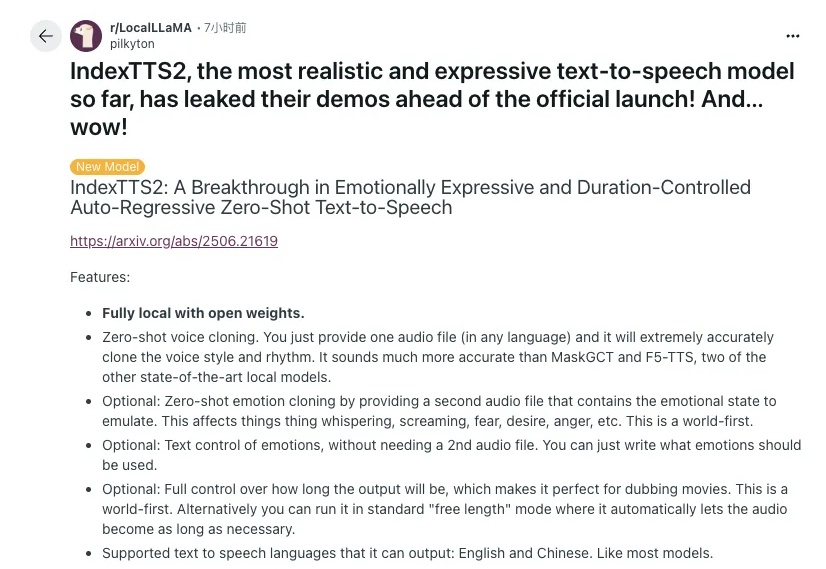
最近一个「泄露」的文本转语音模型演示版本在 Reddit 上火了。这个「泄露」的演示视频被网友贴出来后,评论区一片惊呼。
今天咱们再聊聊TTS(文本转语音)这个话题。4月份给大家分享了MiniMax的TTS平台:MiniMax Audio当时我直呼它是最强中文TTS,那篇反响还不错,主要他们Speech-02-HD的效果确实NB
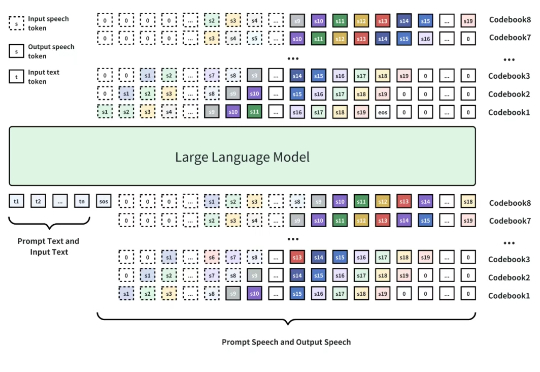
播客、访谈、体育解说、新闻报道和电商直播中,语音对话已经无处不在。 当前的文本到语音(TTS)模型在单句或孤立段落的语音生成效果上取得了令人瞩目的进展,合成语音的自然度、清晰度和表现力都已显著提升,甚至接近真人水平。不过,由于缺乏整体的对话情境,这些 TTS 模型仍然无法合成高质量的对话语音。