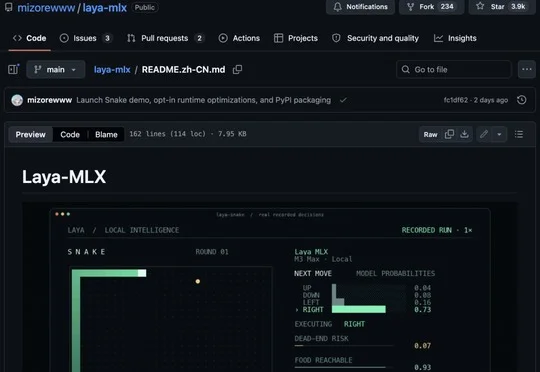
本地版Jev 1G内存就能跑!四舍五入等于不要钱啊
本地版Jev 1G内存就能跑!四舍五入等于不要钱啊开发者mizorewww将开源决策模型Laya移植到Apple MLX框架,推出本地版Laya-MLX,可在Apple Silicon Mac上以低于1GB内存运行并摆脱PyTorch与云端API依赖,421M版本峰值内存943.6MiB、322M多语言版本687.6MiB。
来自主题: AI资讯
9548 点击 2026-09-22 21:43

 搜索
开发者mizorewww将开源决策模型Laya移植到Apple MLX框架,推出本地版Laya-MLX,可在Apple Silicon Mac上以低于1GB内存运行并摆脱PyTorch与云端API依赖,421M版本峰值内存943.6MiB、322M多语言版本687.6MiB。
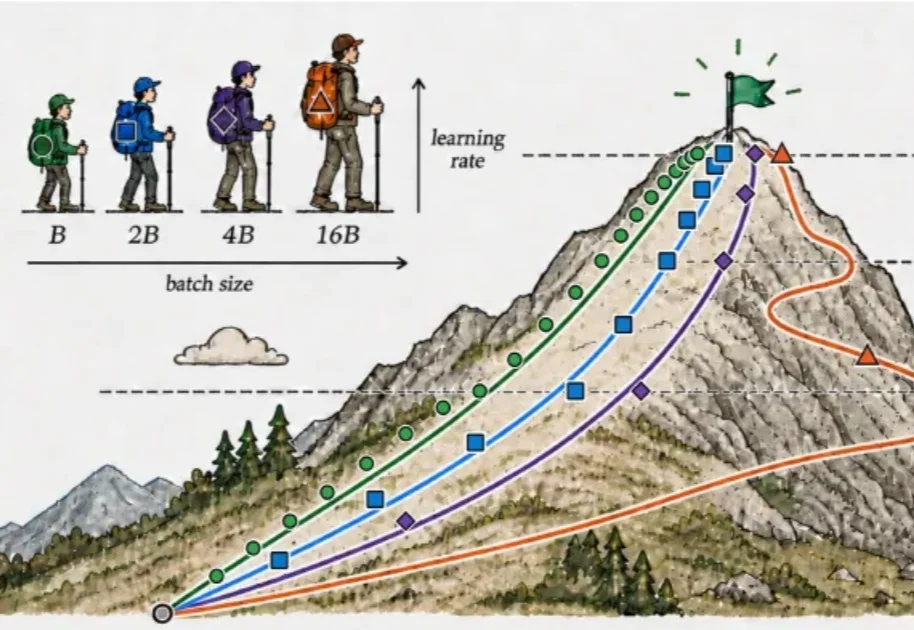
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
时间到了2026年9月,我们基本可以宣布世界模型是一个垃圾概念。
当AI不再只会聊天。
OpenAI最有钱的人,不是奥特曼。
NPU与MCU深度融合,嵌入式全栈生态接入AI,TI手握分层布局、软硬协同杀手锏,加速AI规模化落地。
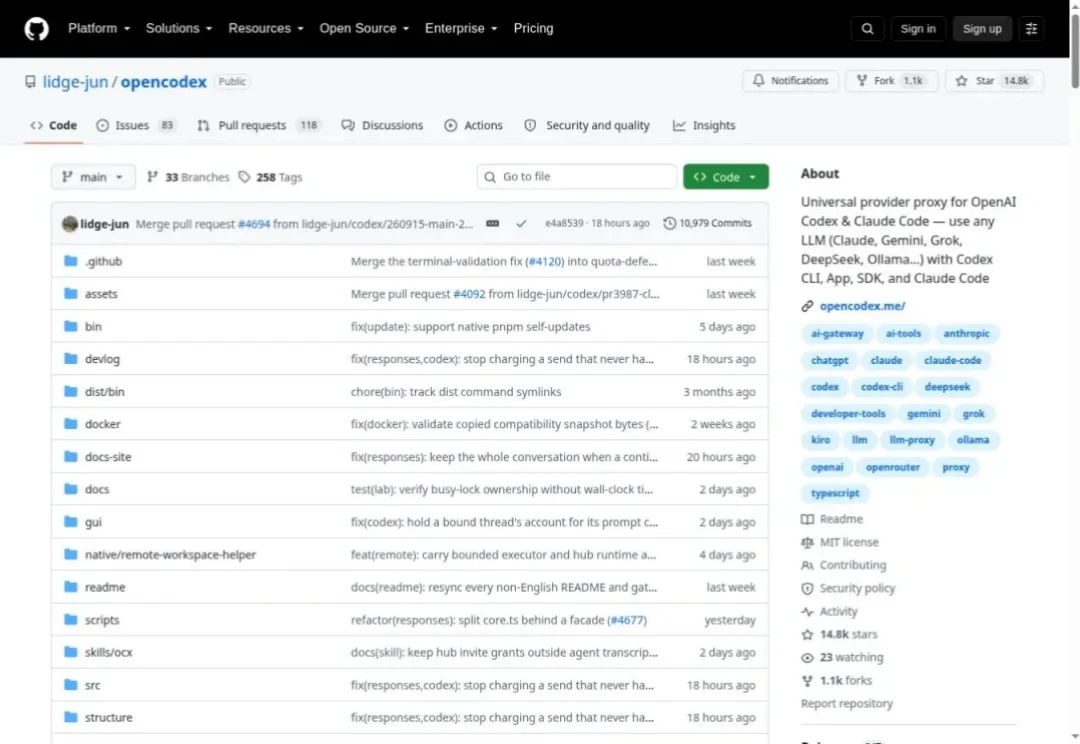
上周发了折腾 WebCodex 的文章《把ChatGPT几乎无限的网页额度当Codex用》,文章下面,就有小伙伴接着问:能不能让不同的模型,去干不同的活?
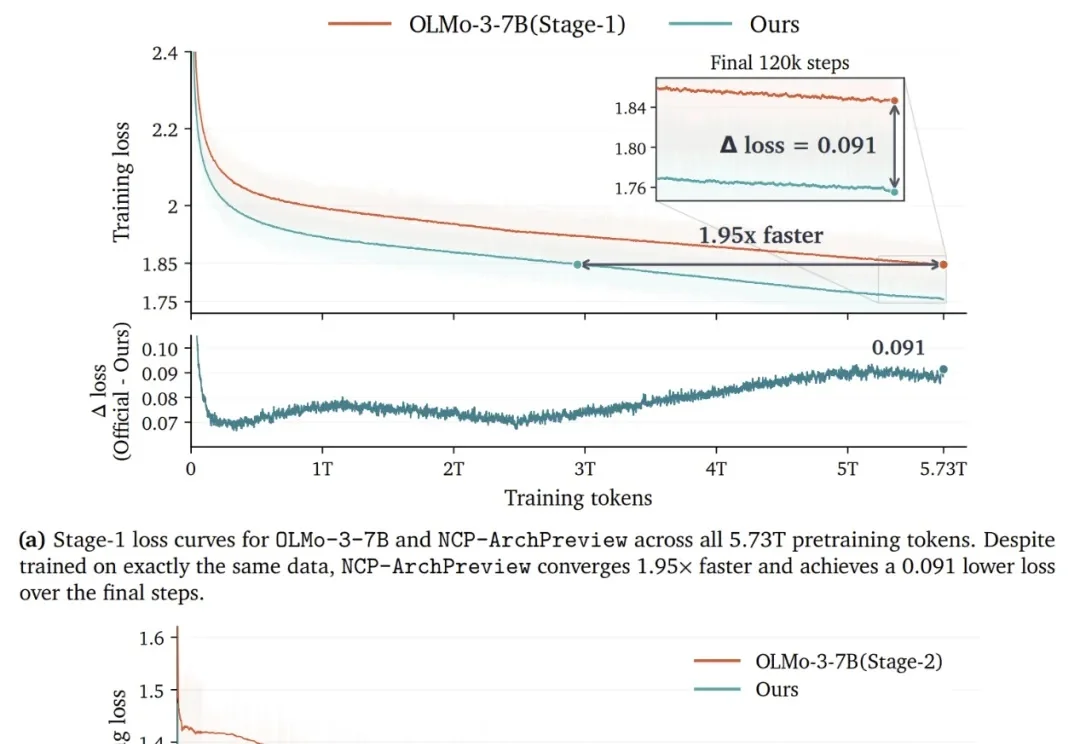
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
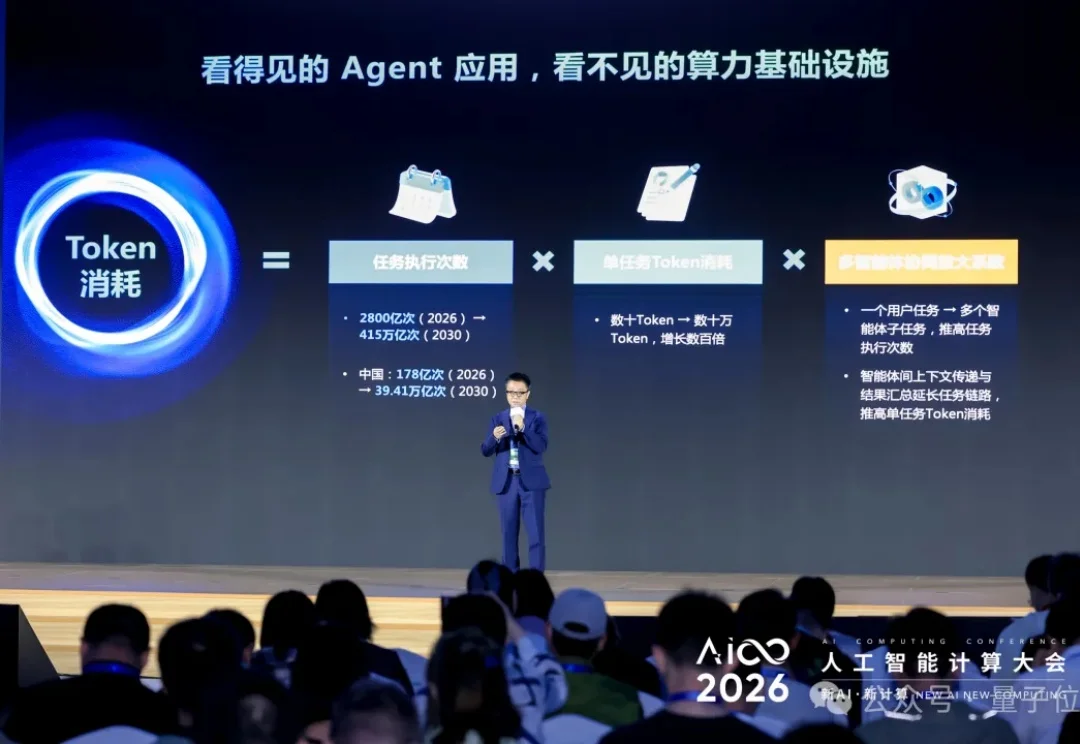
AI算力的竞争,多年来就一个字——堆。
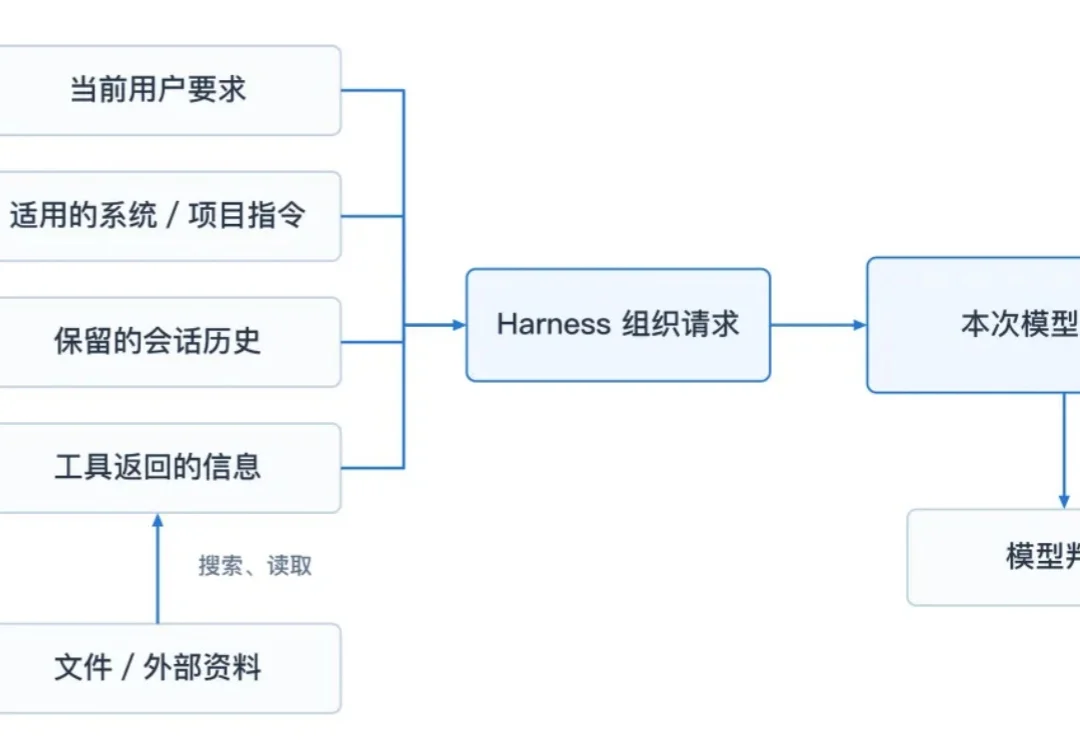
现在的 Agent 的产品越来越多,有些主打 Coding,有些事做日常办公,也有些用于情感陪伴虽然这些产品的用途不同,背后的工作原理其实都大同小异,便是 Harness 对上下文的自动化编排