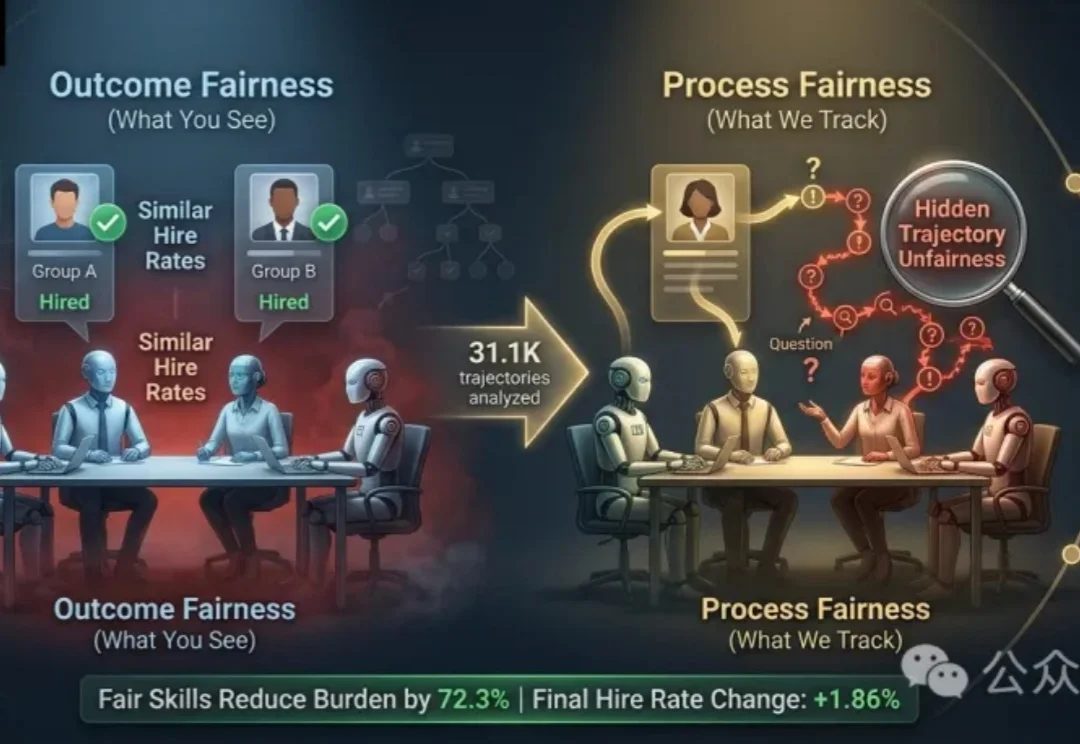
揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26
揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。
来自主题: AI技术研报
8497 点击 2026-09-09 14:51

 搜索
当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。
MiniMax H3 的开源,可能比外界看到得更仓促。
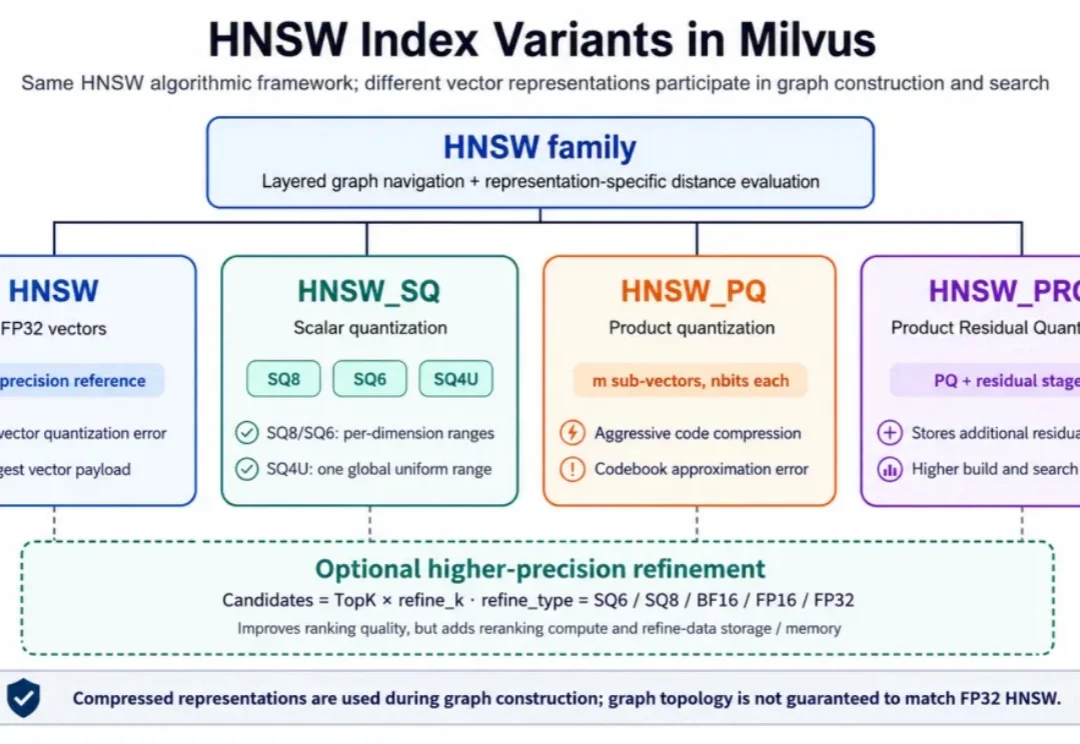
在 Milvus 里,HNSW 通常用于追求较高 Recall 的向量检索。
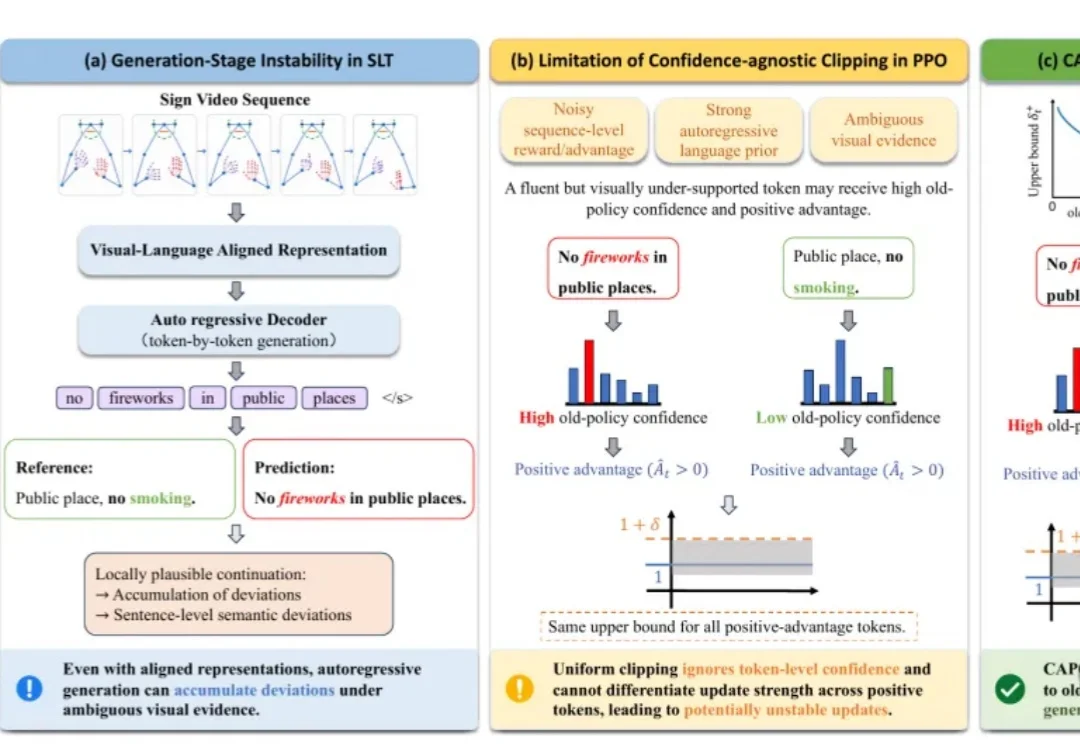
自动手语翻译中,一直存在一个隐蔽难题:模型即使已经较好地对齐了视觉与文本,也可能在逐词生成时,被某个局部合理、却缺少视觉证据支持的词带偏。
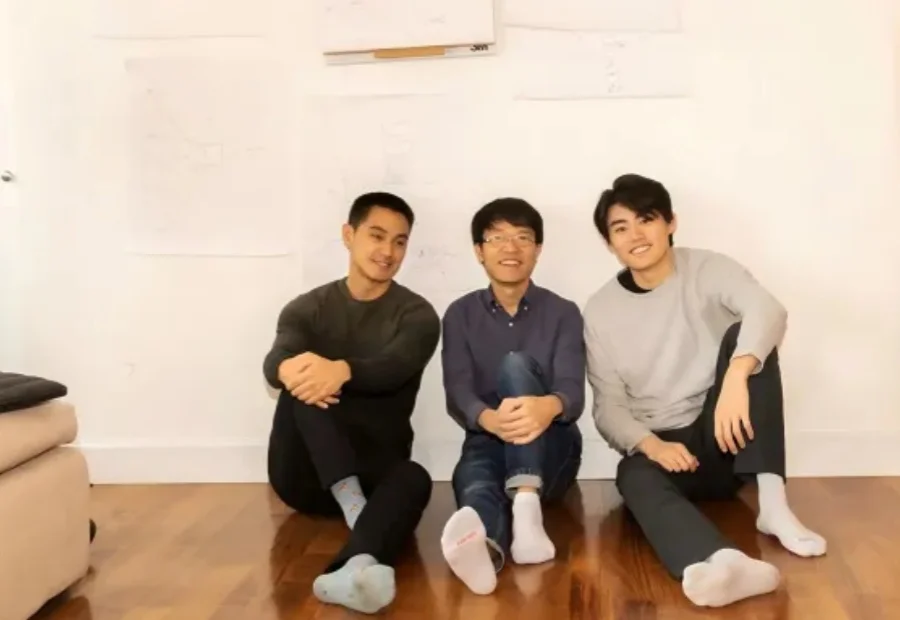
该公司曾做出“全球首个AI软件工程师”。
就在刚刚,OpenAI又进化了。
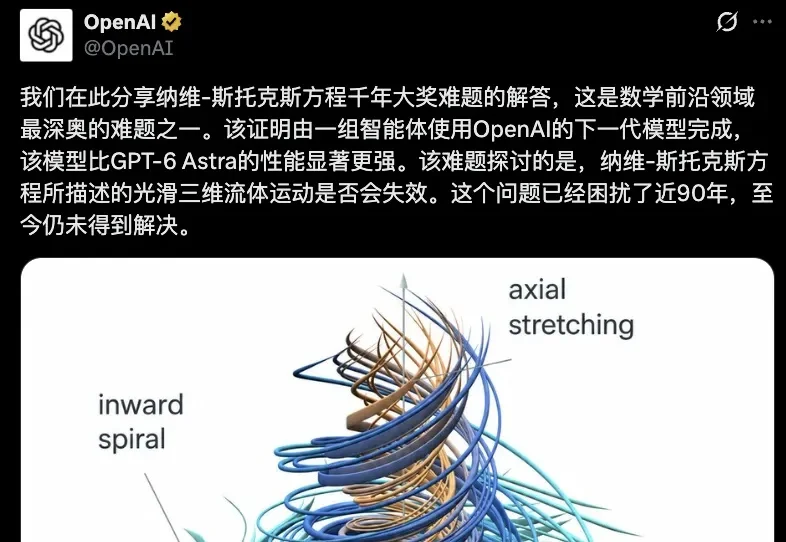
数学史级别的大新闻,愣是被OpenAI整成了一出连续剧。
9月8日,DeepSeek Harness团队负责人崔添翼在社交平台放出约150个招聘名额,岗位涉及大模型研究平台方向、Agent框架组件方向、研发效率基建方向、数据工程方向等工程师。
AI 硬件,和过往的硬件,有什么区别?
前些天,号称「实现 AGI」的 GPT-6 Astra 发布后,引发了全网对于递归自我改进架构的热议。