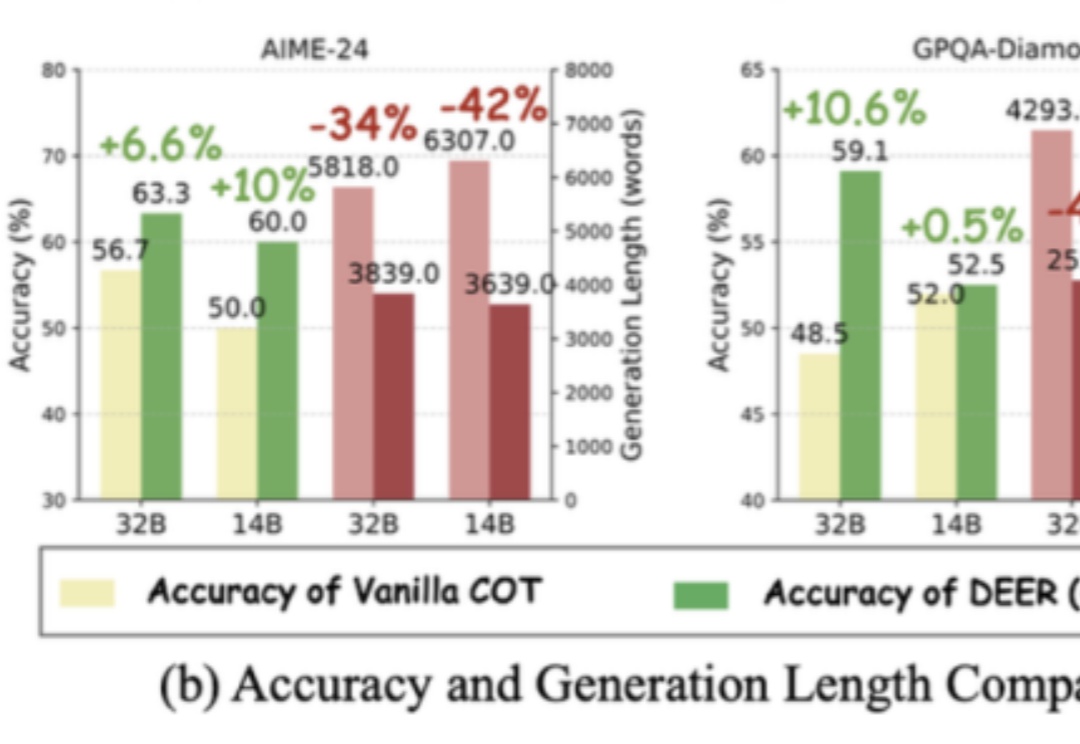
DeepSeek精度效率双提升,华为&信工所提出思维链“提前退出”机制
DeepSeek精度效率双提升,华为&信工所提出思维链“提前退出”机制长思维链让大模型具备了推理能力,但如果过度思考,就有可能成为负担。
来自主题: AI技术研报
9675 点击 2025-05-12 10:45

 搜索
长思维链让大模型具备了推理能力,但如果过度思考,就有可能成为负担。
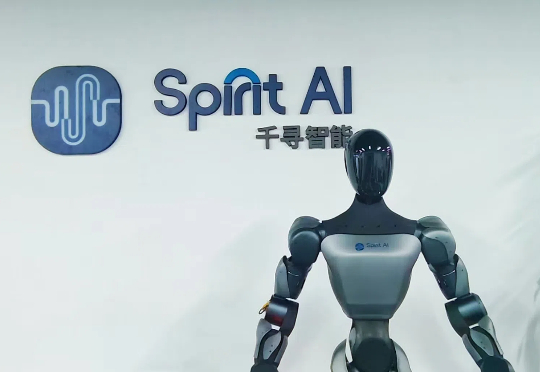
华为哈勃首次投资机器人公司千寻智能,5月将发新Demo。
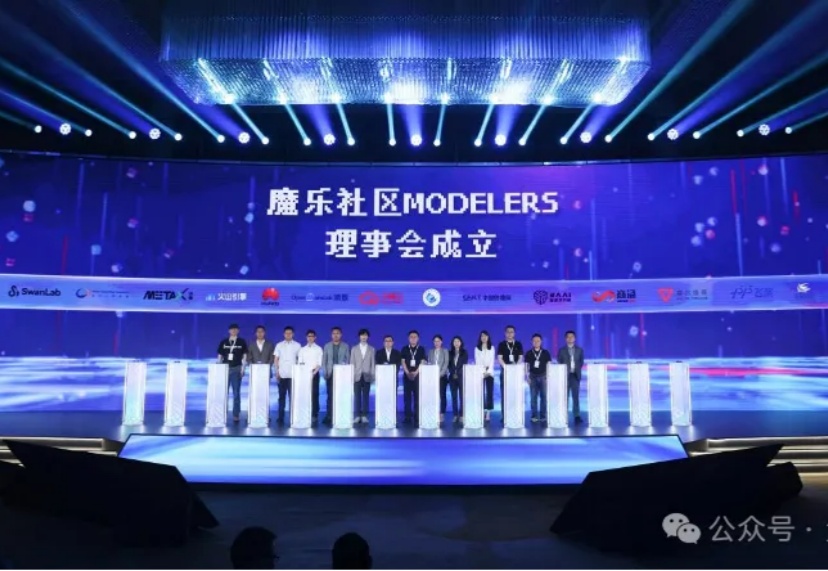
央企通信巨头,牵头搞起了一个开源社区?

现在,跑准万亿参数的大模型,可以彻底跟英伟达Say Goodbye了。
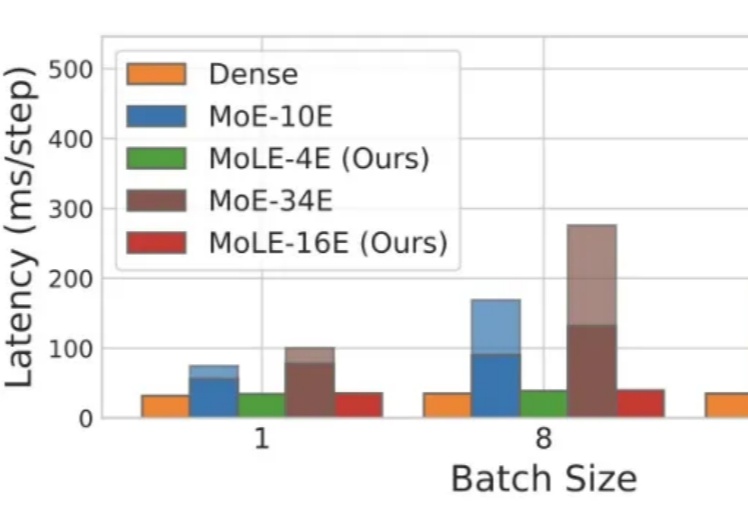
Mixture-of-Experts(MoE)在推理时仅激活每个 token 所需的一小部分专家,凭借其稀疏激活的特点,已成为当前 LLM 中的主流架构。然而,MoE 虽然显著降低了推理时的计算量,但整体参数规模依然大于同等性能的 Dense 模型,因此在显存资源极为受限的端侧部署场景中,仍然面临较大挑战。
英伟达H20也不能用了。中国大模型还能好吗?
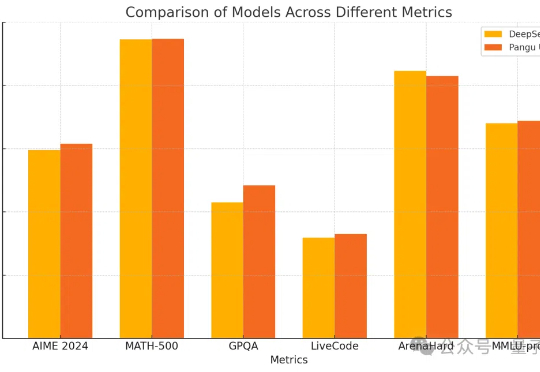
密集模型的推理能力也能和DeepSeek-R1掰手腕了?
一切为了「多终端一致体验」和「用户数据闭环」。
终于,华为盘古大模型系列上新了,而且是昇腾原生的通用千亿级语言大模型。我们知道,如今各大科技公司纷纷发布百亿、千亿级模型。但这些大部分模型训练主要依赖英伟达的 GPU。
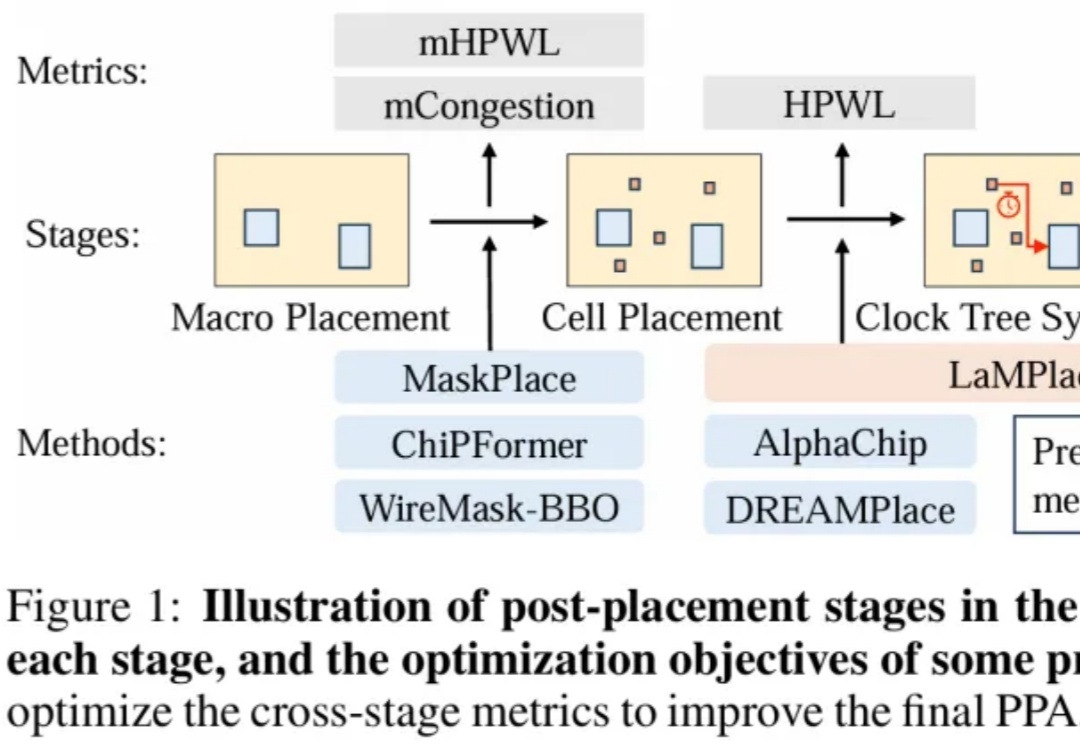
用AI指导芯片设计,中科大王杰教授团队、华为诺亚实验室、天津大学提出全新芯片宏单元布局优化方法LaMPlace!