a16z对话Nano Banana团队:2亿次编辑背后的"工作流革命"
a16z对话Nano Banana团队:2亿次编辑背后的"工作流革命"创意工作流的“奇点”已经到来。曾经耗费团队数周的角色设计、风格探索和分镜绘制,如今在Nano Banana中被压缩到几分钟。高度一致的角色、一键迁移的风格、拖拽完成的复杂编辑。
来自主题: AI资讯
8381 点击 2025-11-12 15:15

 搜索
创意工作流的“奇点”已经到来。曾经耗费团队数周的角色设计、风格探索和分镜绘制,如今在Nano Banana中被压缩到几分钟。高度一致的角色、一键迁移的风格、拖拽完成的复杂编辑。

两人小团队,仅用两周就复刻了之前被硅谷夸疯的DeepSeek-OCR?? 复刻版名叫DeepOCR,还原了原版低token高压缩的核心优势,还在关键任务上追上了原版的表现。完全开源,而且无需依赖大规模的算力集群,在两张H200上就能完成训练。
大模型一个token一个token生成,效率太低怎么办?
Meta首席执行官马克·扎克伯格近日批准了一项涉及约600名员工的AI部门裁员计划,这是Meta今年在人工智能领域规模最大的一次调整,主要波及公司核心研发机构。在此消息公布后,田渊栋首次公开露面,接受了腾讯科技特约作者「课代表立正」的独家深度访谈。
近期,DeepSeek-OCR提出了“Vision as Context Compression”的新思路,然而它主要研究的是通过模型的OCR能力,用图片压缩文档。
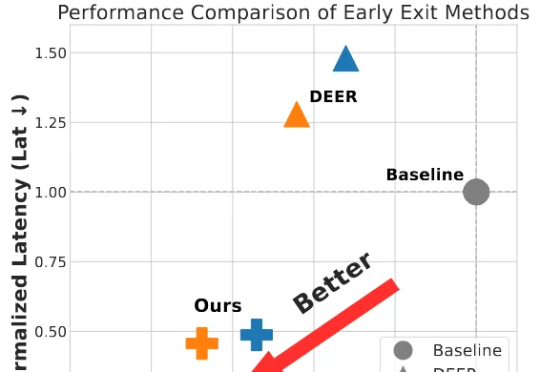
为破解大模型长思维链的效率难题,并且为了更好的端到端加速落地,我们将思考早停与投机采样无缝融合,提出了 SpecExit 方法,利用轻量级草稿模型预测 “退出信号”,在避免额外探测开销的同时将思维链长度缩短 66%,vLLM 上推理端到端加速 2.5 倍。
DeepSeek最新开源的模型,已经被硅谷夸疯了!
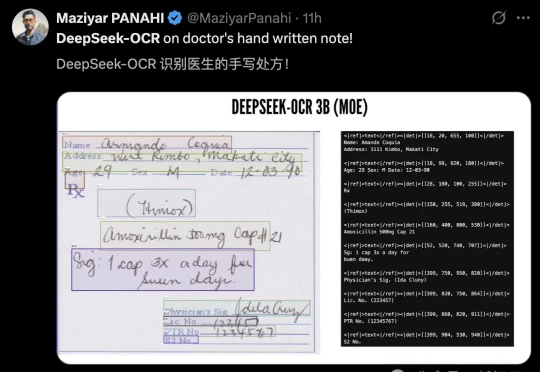
AI新突破!DeepSeek-OCR以像素处理文本,压缩率小于1/10,基准测试领跑。开源一夜4.4k星,Karpathy技痒难耐,展望视觉输入的通用性。
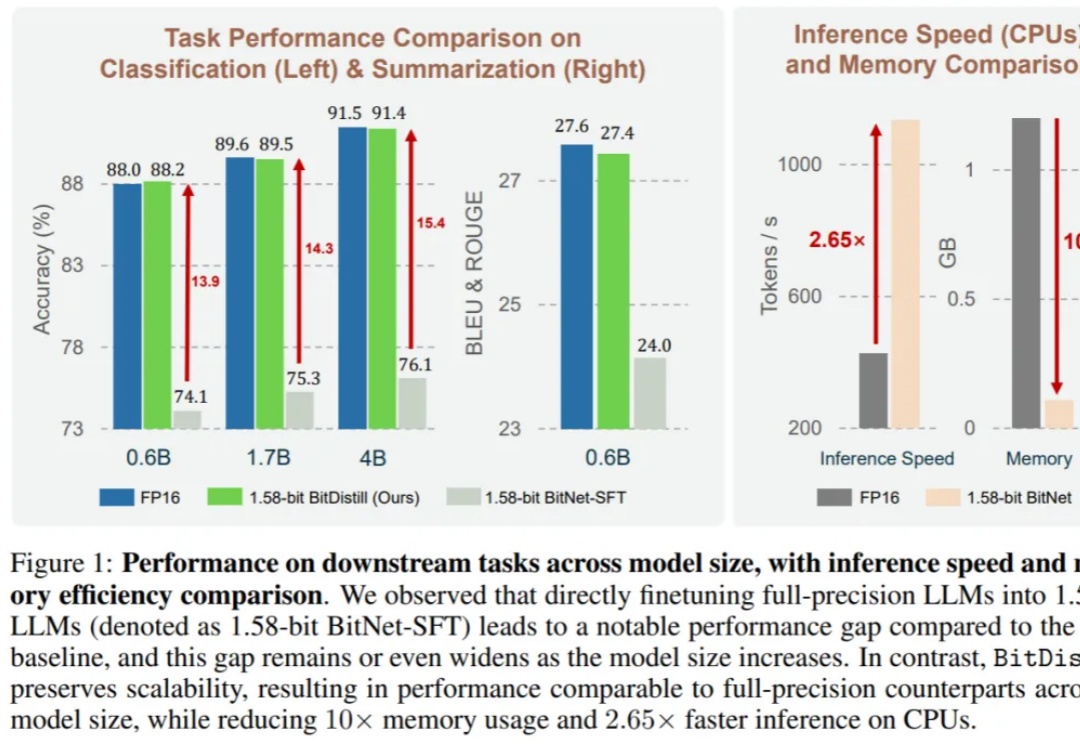
大语言模型(LLM)不仅在推动通用自然语言处理方面发挥了关键作用,更重要的是,它们已成为支撑多种下游应用如推荐、分类和检索的核心引擎。尽管 LLM 具有广泛的适用性,但在下游任务中高效部署仍面临重大挑战。
刚刚,DeepSeek 推出了全新的视觉文本压缩模型 DeepSeek-OCR。 该模型最大的突破在于极高的压缩效率: 20 个节点每天可处理 3300 万页数据,硬件要求仅为 A100-40G。