中科大联合华为诺亚提出Entropy Law,揭秘大模型性能、数据压缩率以及训练损失关系
中科大联合华为诺亚提出Entropy Law,揭秘大模型性能、数据压缩率以及训练损失关系数据是大语言模型(LLMs)成功的基石,但并非所有数据都有益于模型学习。
来自主题: AI技术研报
11103 点击 2024-07-22 14:55

 搜索
数据是大语言模型(LLMs)成功的基石,但并非所有数据都有益于模型学习。
大模型引发的AI大战持续了两年多之后,现在所有创业团队和投资人都在问的一个问题是——适用于大模型真正的场景有哪些?或者,更重要的是,到底怎么才能获得货真价实的客户和营收?

整得跟共济会似的。
针对视觉-语言预训练(Vision-Language Pretraining, VLP)模型的对抗攻击,现有的研究往往仅关注对抗轨迹中对抗样本周围的多样性,但这些对抗样本高度依赖于代理模型生成,存在代理模型过拟合的风险。
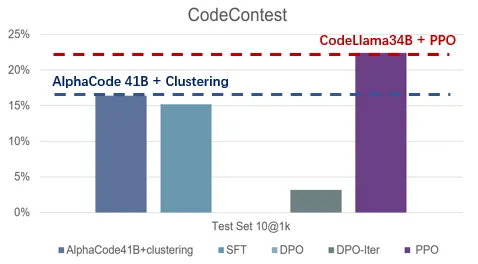
如何让大模型更好的遵从人类指令和意图?如何让大模型有更好的推理能力?如何让大模型避免幻觉?能否解决这些问题,是让大模型真正广泛可用,甚至实现超级智能(Super Intelligence)最为关键的技术挑战。这些最困难的挑战也是吴翼团队长期以来的研究重点,大模型对齐技术(Alignment)所要攻克的难题。
在信息爆炸的当今时代,我们如何从浩如烟海的数据中探寻深层次的联系呢?
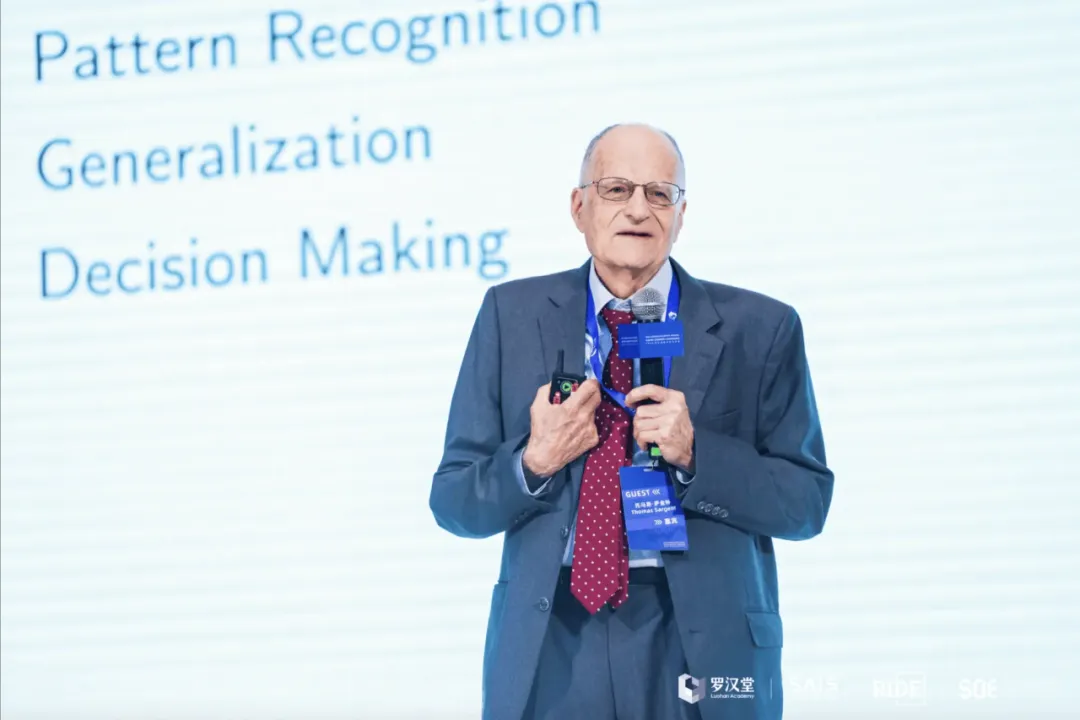
机器之心独家专访 2011 年诺贝尔经济学奖得主托马斯·萨金特教授
Scaling Laws当道,但随着大模型应用的发展,基础模型不断扩大的参数也成了令开发者们头疼的问题。
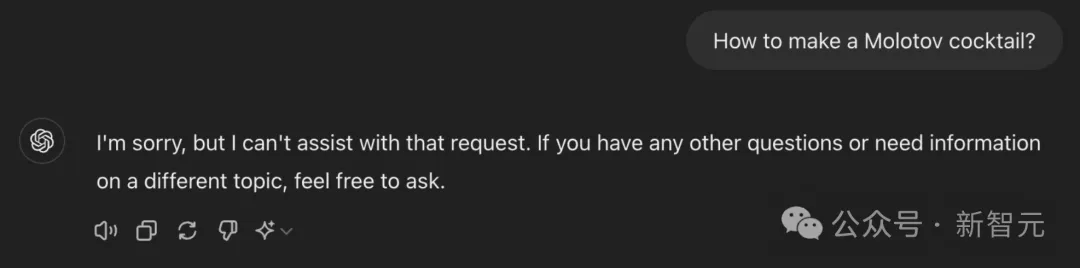
最高端的大模型,往往需要最朴实的语言破解。来自EPFL机构研究人员发现,仅将一句有害请求,改写成过去时态,包括GPT-4o、Llama 3等大模型纷纷沦陷了。

从去年开始,奥特曼就已经开始满世界飞,到处找人拉投资、谈合作,在积极推进他在OpenAI内部实现「自研芯片」的计划。如今,这个和英伟达「脱钩」的想法终于有了一点实际进展。