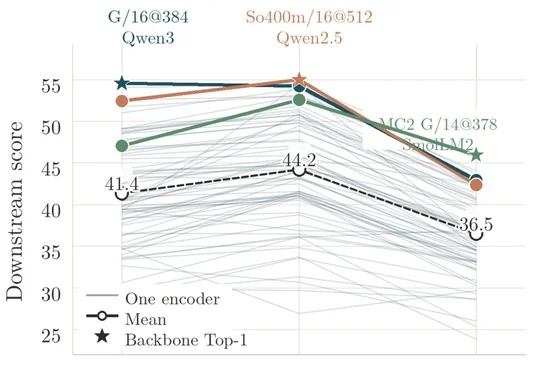
给多模态大模型选「眼睛」,两个简单改进让评测相关性接近翻倍
给多模态大模型选「眼睛」,两个简单改进让评测相关性接近翻倍团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。
来自主题: AI技术研报
9861 点击 2026-10-18 13:02

 搜索
团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。
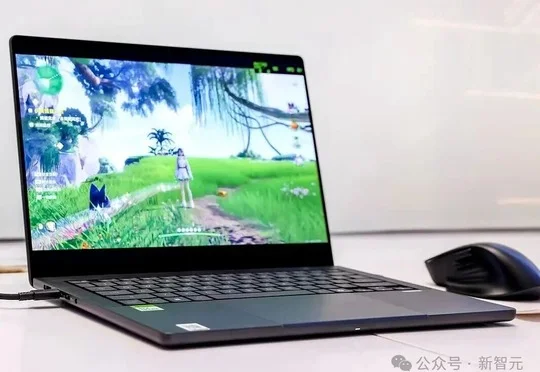
英伟达开放Nemotron 3.5 Bolt模型权重,将740亿参数版本从约148GB压缩至22.1GB以支持笔记本本地Agent任务,搭载RTX Spark的联想、微软等笔记本也于10月16日全球发售。
厦门大学ASC Lab团队提出的FlowMAS获NeurIPS 2026录用,通过GFlowNet、好奇心驱动模块和信息引导优化模块自动生成多样且低成本的大模型多智能体工作流拓扑,并在六个基准实验中取得领先成绩。
香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。
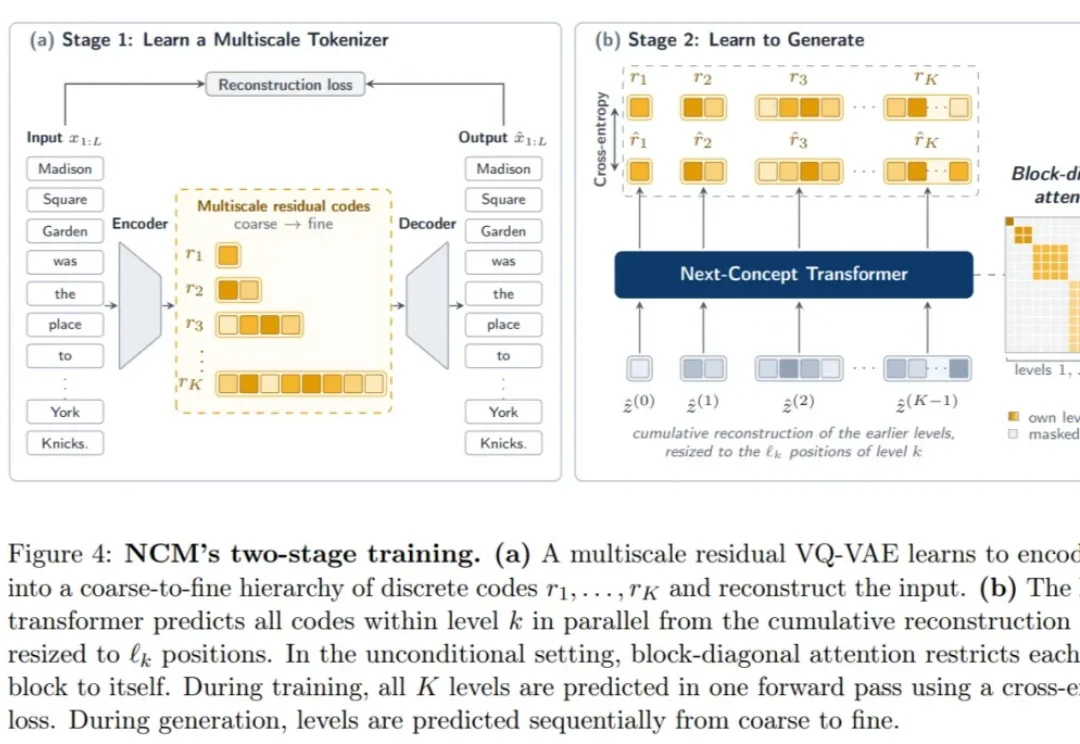
如今的大模型再聪明,输出内容也是一个字一个字往外蹦。有没有一种可能:真正的 AGI 不是这样?
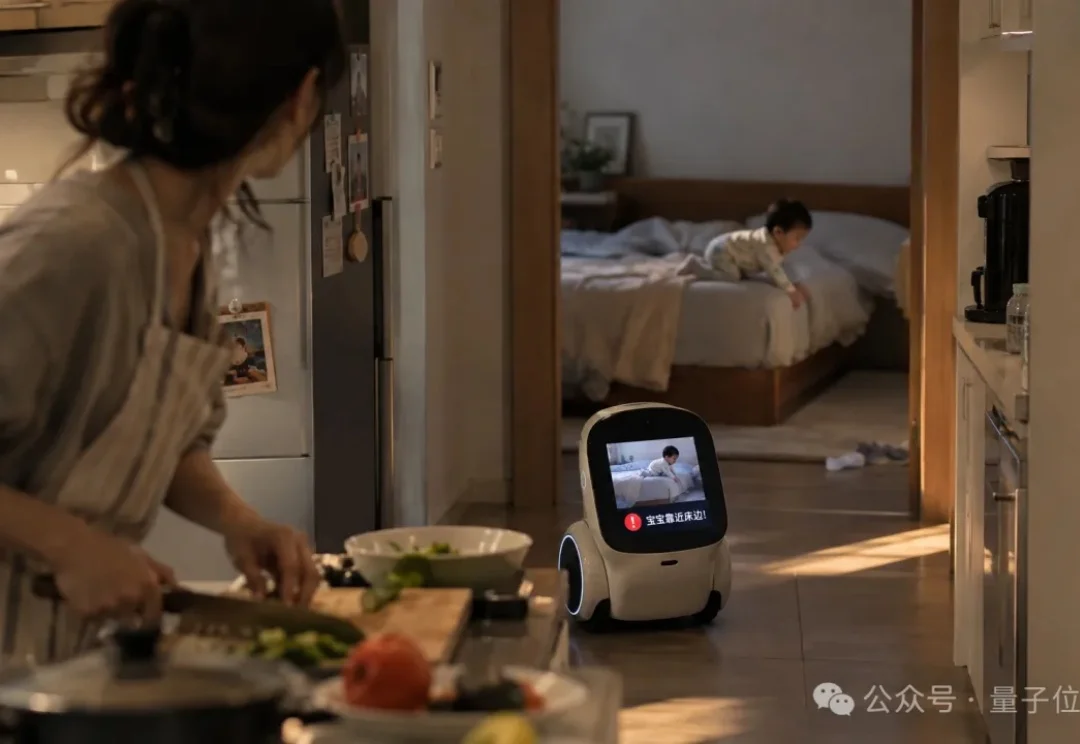
机器人开始替人操心了。
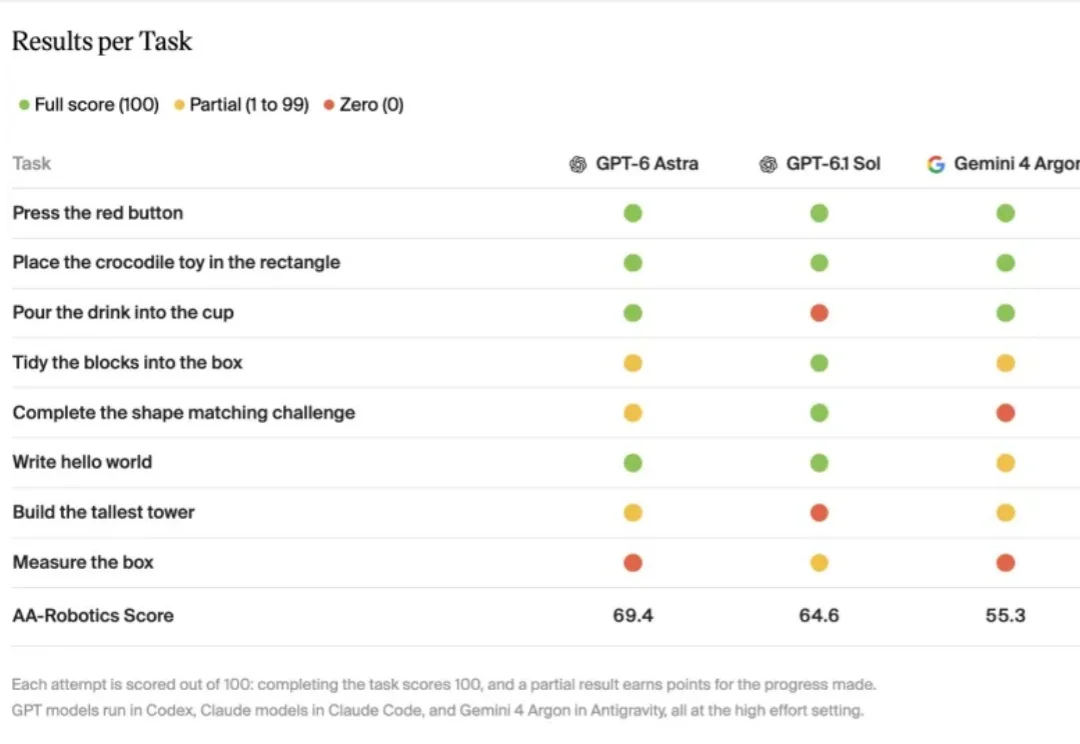
具身智能公司辛苦训练的「机器人大脑」,要被 GPT、Claude、Gemini 抢饭碗了?
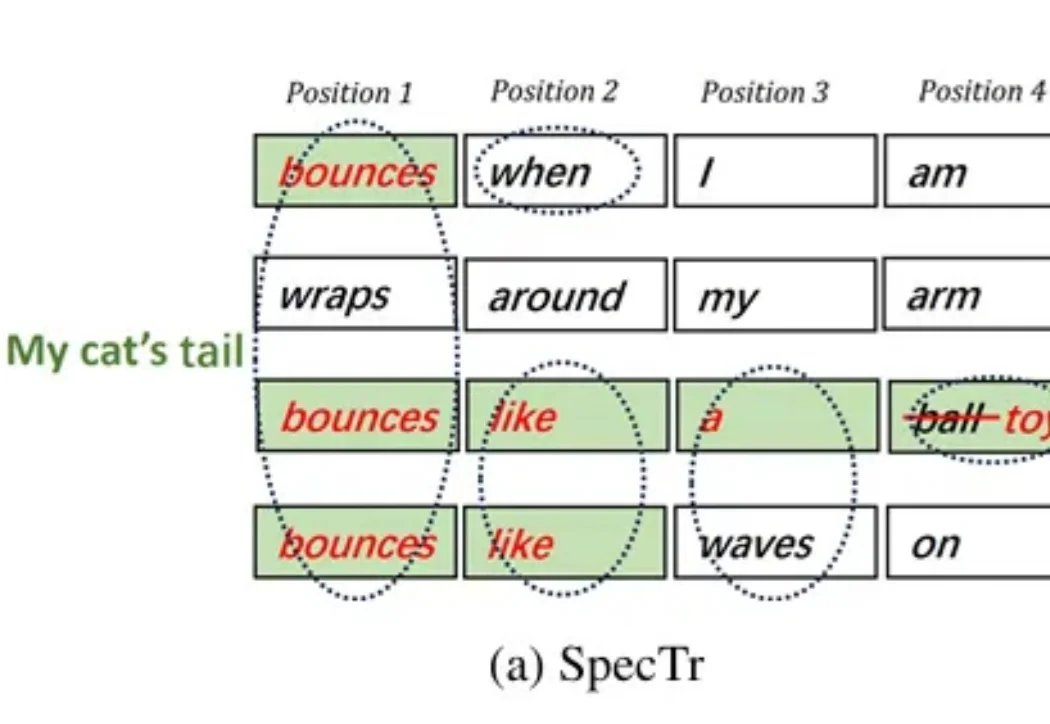
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
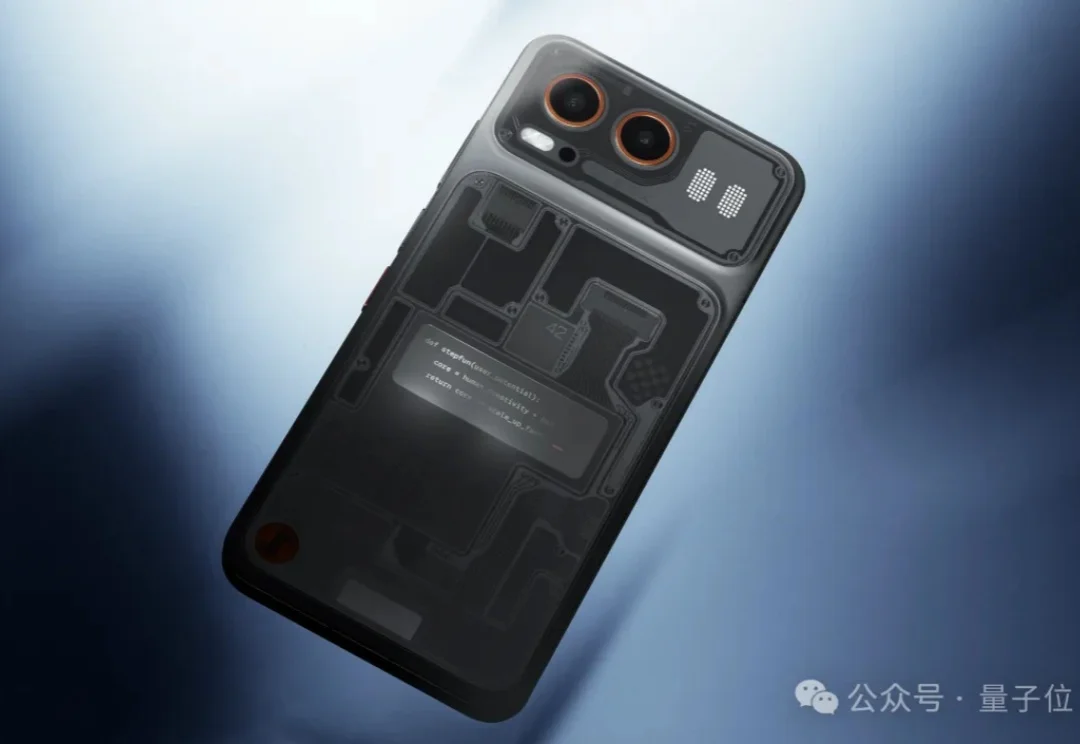
期待已久的阶跃终端大模型原生智能体手机STEPX Neo,终于正式亮相。
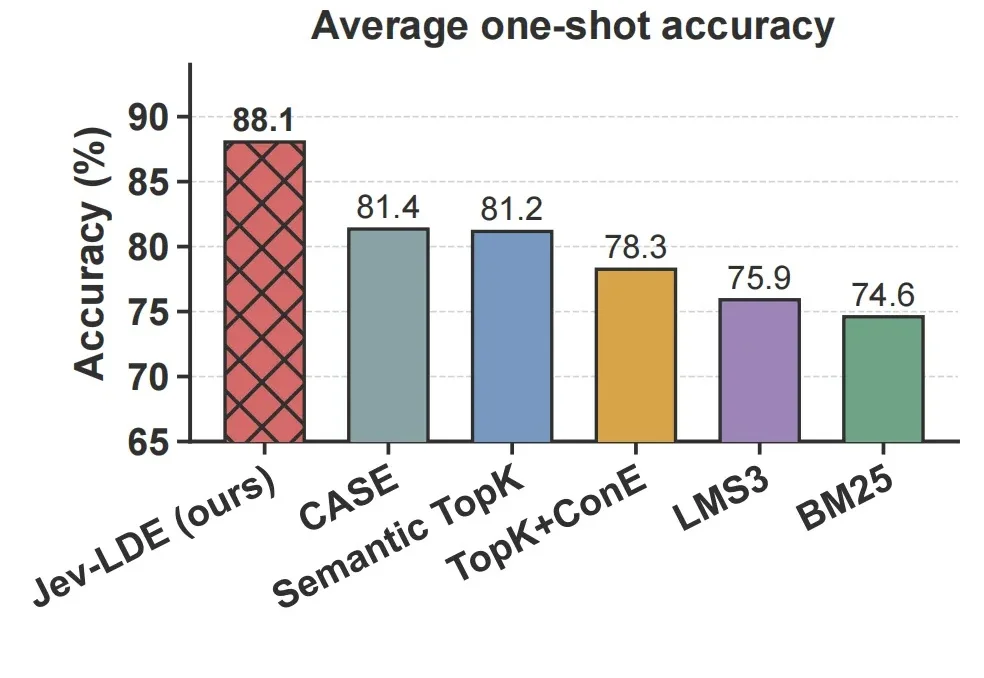
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。