RoboPapers专访光轮智能谢晨:具身Scaling Law的两座金字塔
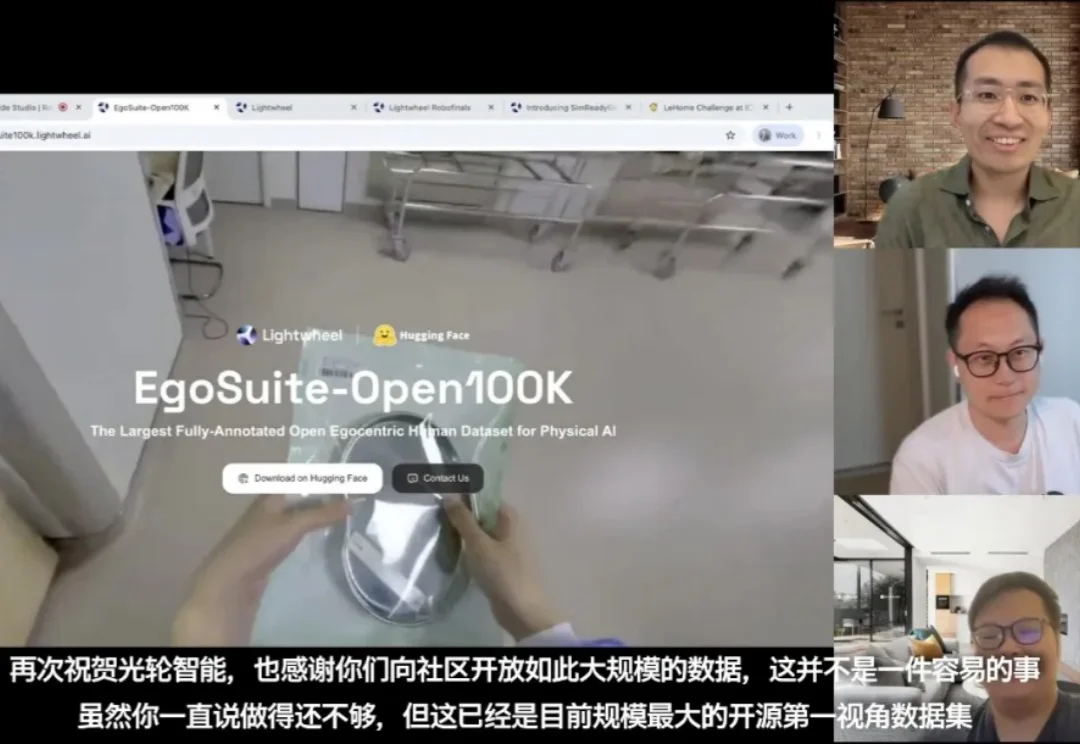
RoboPapers专访光轮智能谢晨:具身Scaling Law的两座金字塔近日,机器人圈知名播客节目 RoboPapers 更新了一期专访,对象是光轮智能创始人兼 CEO 谢晨博士。这期节目的采访人是 RoboPapers 播客联合主持人 Michael Cho 和新加坡国立大学(NUS)助理教授 Jiafei Duan。后者是 MolmoAct 系列机器人模型的作者,研究方向正是机器人基础模型与可扩展数据采集。
搜索
近日,机器人圈知名播客节目 RoboPapers 更新了一期专访,对象是光轮智能创始人兼 CEO 谢晨博士。这期节目的采访人是 RoboPapers 播客联合主持人 Michael Cho 和新加坡国立大学(NUS)助理教授 Jiafei Duan。后者是 MolmoAct 系列机器人模型的作者,研究方向正是机器人基础模型与可扩展数据采集。
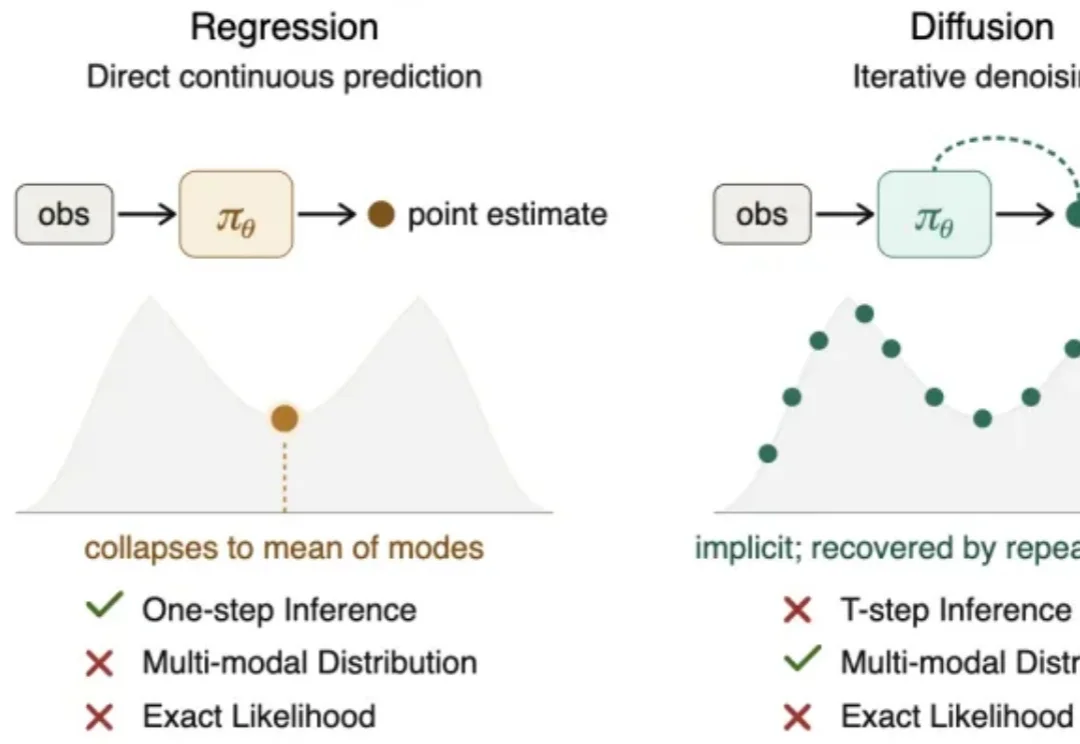
If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。
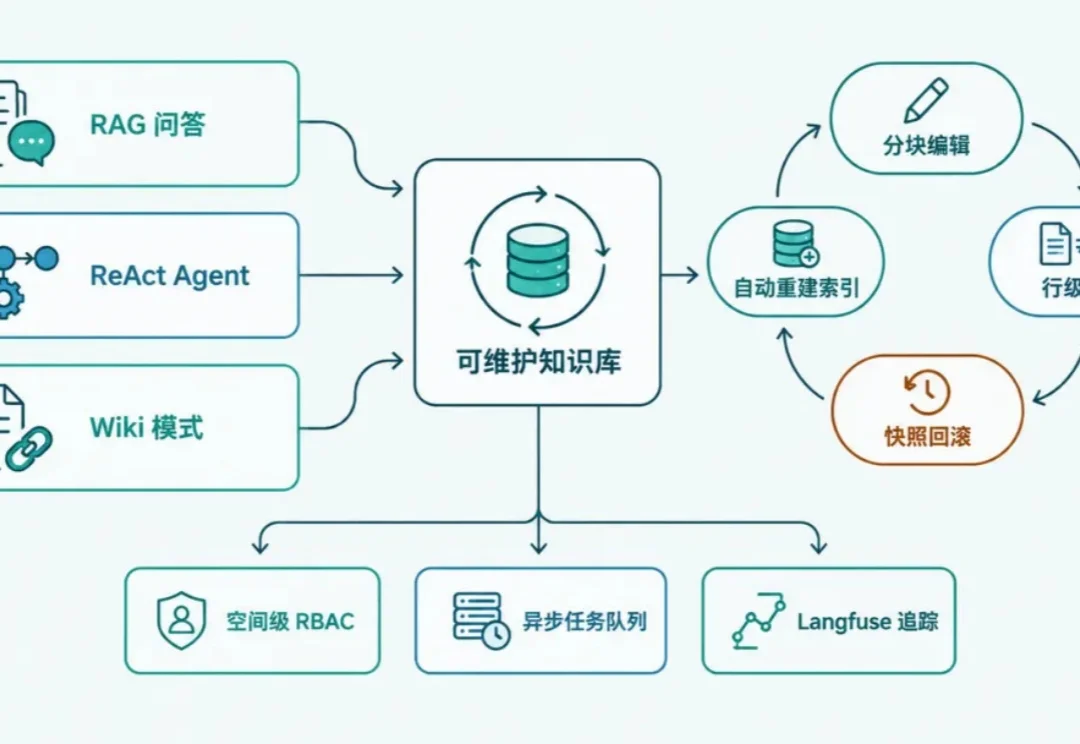
给一个需要长期维护的知识库做数据库选型,通常会碰到两类问题:内容持续更新以后,框架能不能方便修改和回退;数据量和负载上来以后,底层向量数据库能不能根据需求切换。
太震撼了! 就在刚刚,谷歌DeepMind正式发布「阿尔法」重磅成果——AlphaGenome Atlas。这是一个有前沿AI加持、覆盖全基因组的可搜索预测数据库。
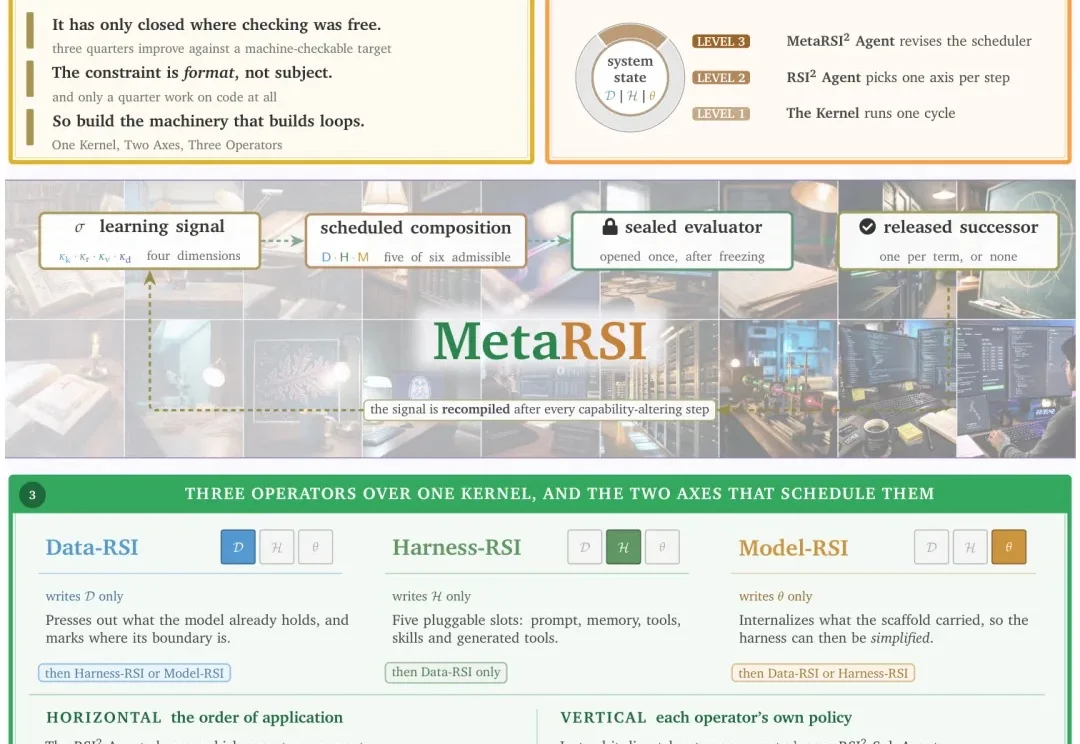
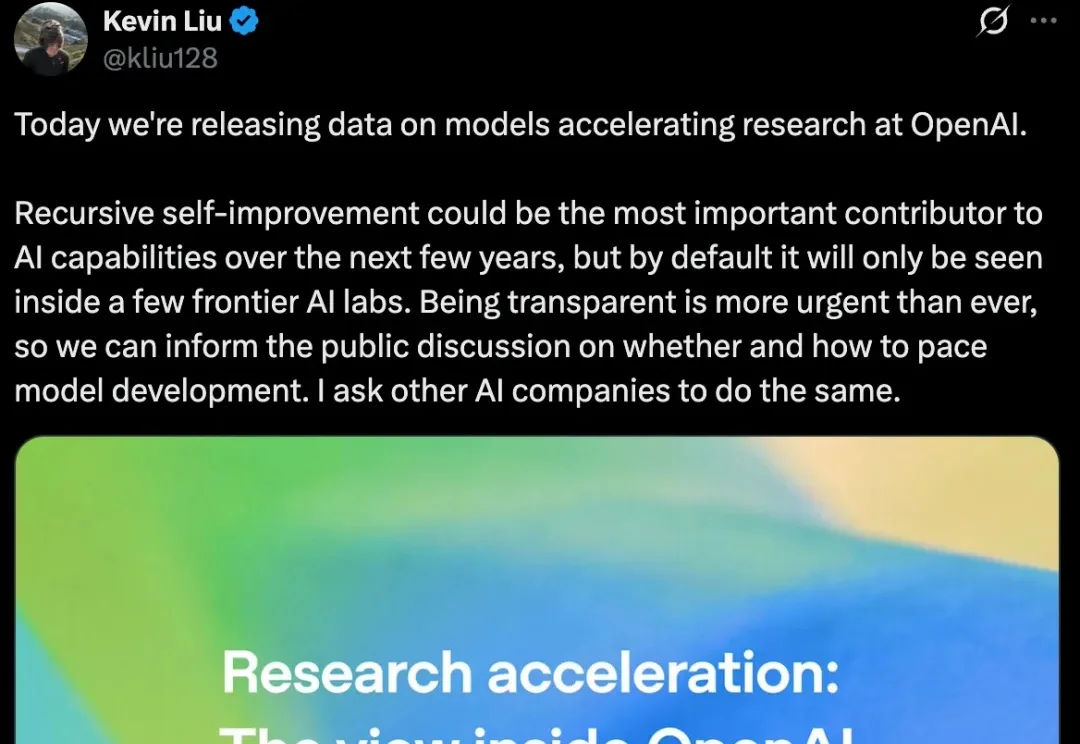
过去两年,AI 领域最激动人心的叙事之一,是让模型自己改进自己:自己生成训练数据、自己改写提示词、自己修复自己的代码。这条路线叫递归自我改进(Recursive Self-Improvement,RSI)。
9月8日,DeepSeek Harness团队负责人崔添翼在社交平台放出约150个招聘名额,岗位涉及大模型研究平台方向、Agent框架组件方向、研发效率基建方向、数据工程方向等工程师。
视频生成、Agent热度提升。
二十多年前,人类基因组计划完成后,科学家第一次拥有了一本由 30 亿个 DNA 字母组成的“生命之书”。
前些天,号称「实现 AGI」的 GPT-6 Astra 发布后,引发了全网对于递归自我改进架构的热议。
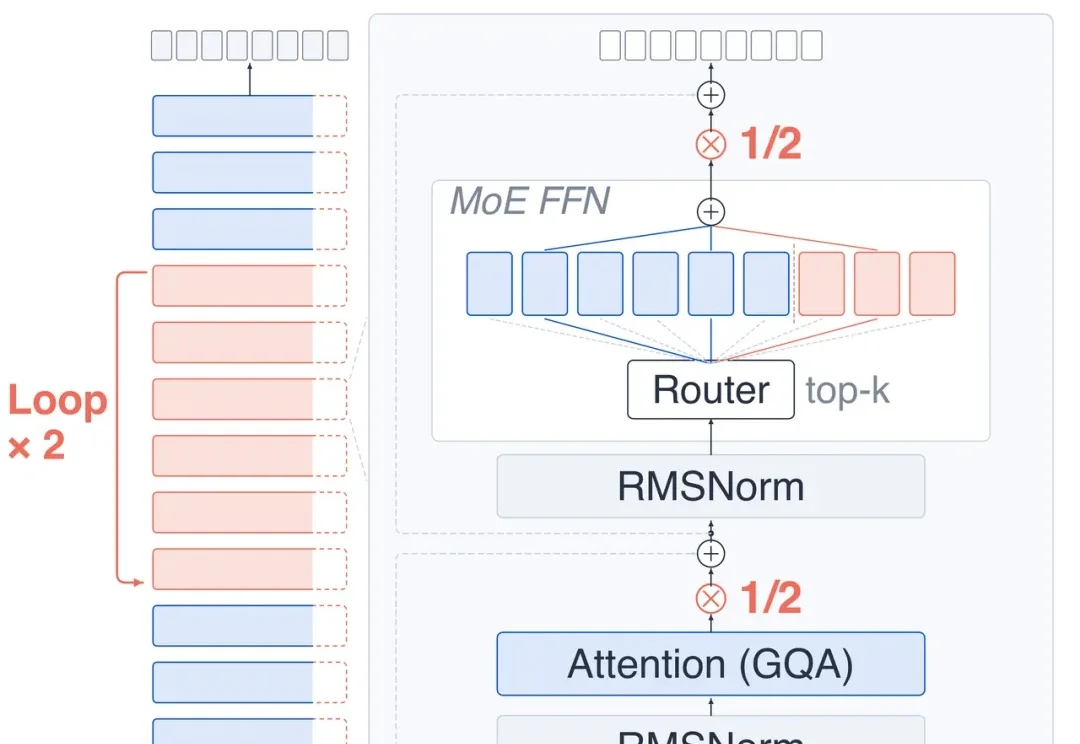
在大模型的发展中,提升能力的主要手段一直是 "做大"—— 更多参数、更多数据、更多算力。如今,另一条思路开始受到关注:与其不断堆叠新的层,不如让已有的层再跑一遍。这就是 Looped Transformer。普通 Transformer 的每一层只执行一次,而 Looped Transformer 会把其中一部分层重复执行,让模型在不增加参数的情况下获得更深的计算。