明确了:文本数据中加点代码,训练出的大模型更强、更通用
明确了:文本数据中加点代码,训练出的大模型更强、更通用代码知识原来这么重要。
来自主题: AI技术研报
12248 点击 2024-08-23 17:18

 搜索
代码知识原来这么重要。
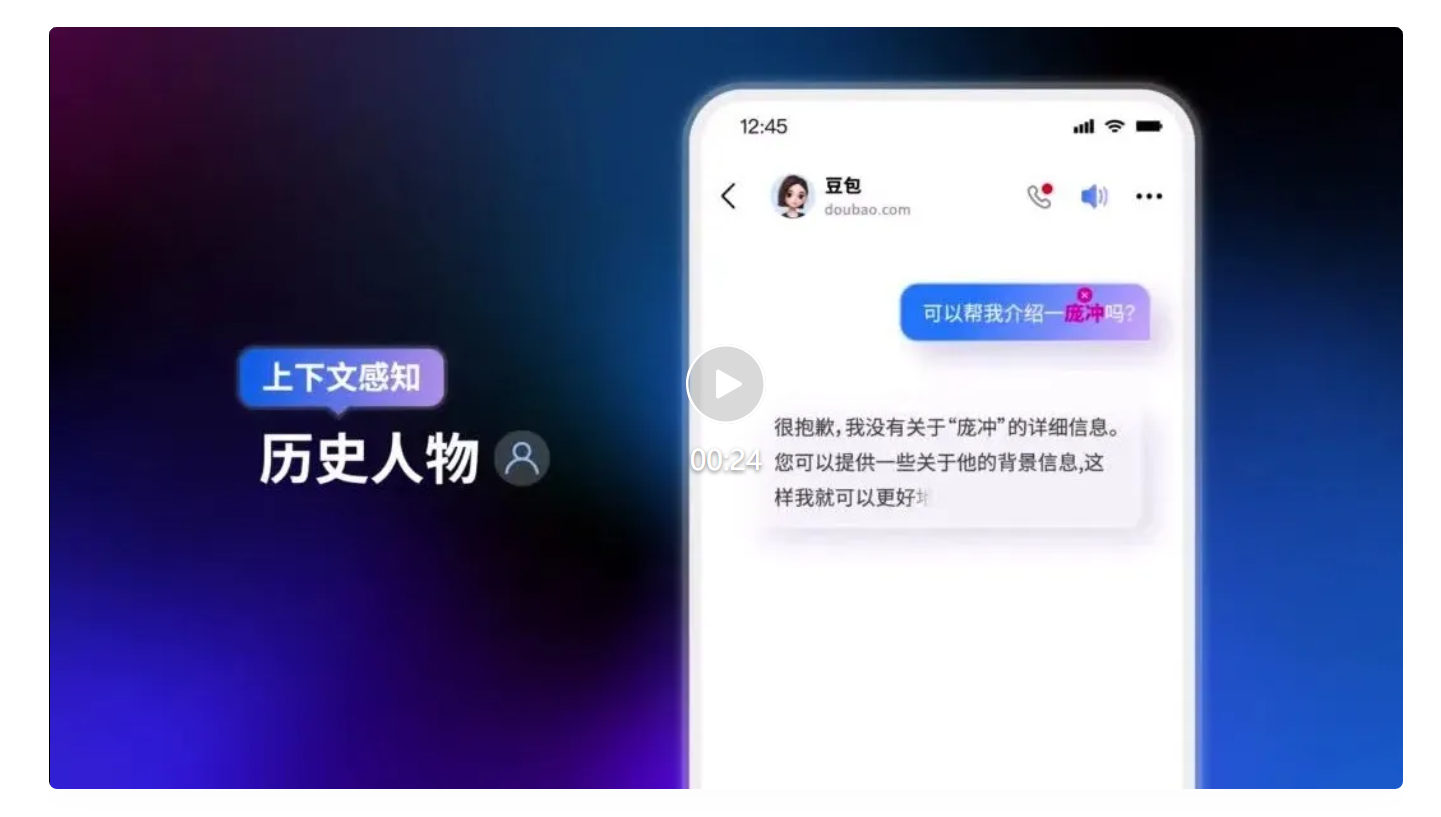
8 月 21 日,2024 火山引擎 AI 创新巡展﹒上海站带来了豆包大模型最新进展。
Emory大学的研究团队提出了一种创新的方法,将大语言模型(LLM)在文本图(Text-Attributed Graph, 缩写为TAG)学习中的强大能力蒸馏到本地模型中,以应对文本图学习中的数据稀缺、隐私保护和成本问题。通过训练一个解释器模型来理解LLM的推理过程,并对学生模型进行对齐优化,在多个数据集上实现了显著的性能提升,平均提高了6.2%。
距离GPT-4首次发布已经过去了将近一年半的时间,Nature最近发表的一篇报告却探索出了这个「过气」模型的新用途——氨基酸和蛋白质的结构建模。
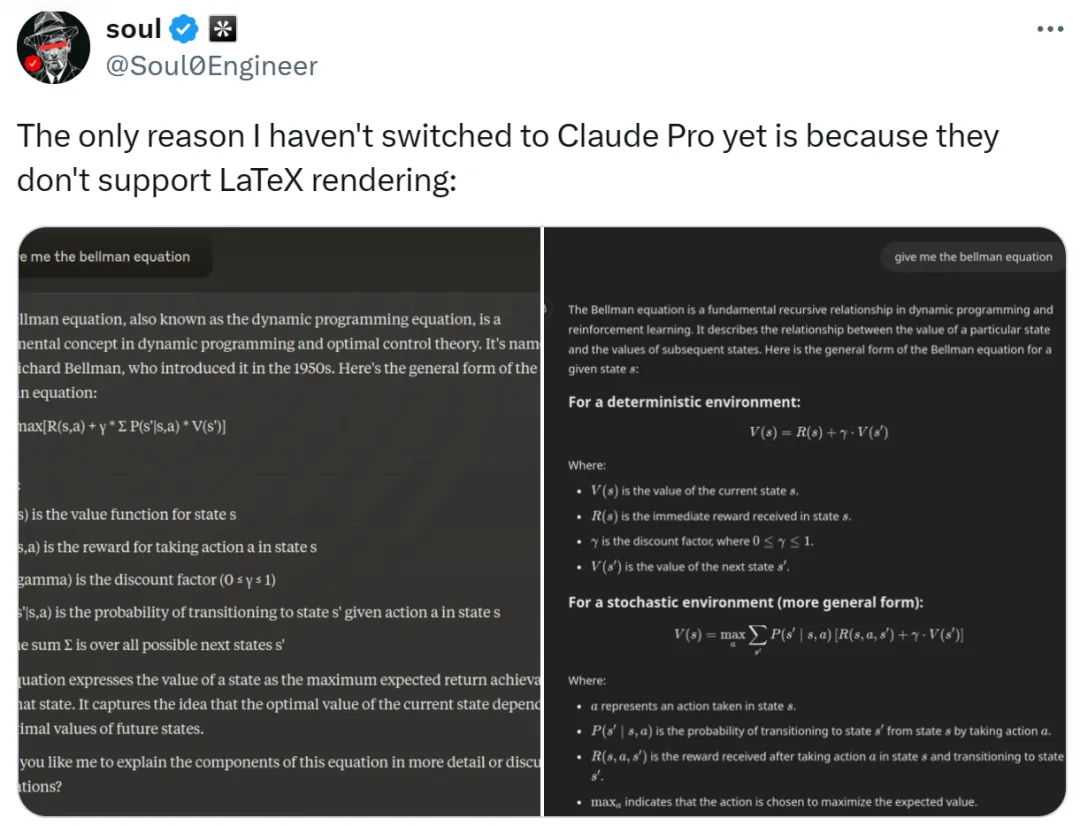
当 ChatGPT 老早就支持使用 LaTeX 语言输入和显示数学公式时,Claude 现在终于补上了这一功能。
Meta加强推广Llama模型,谋求AI市场领导
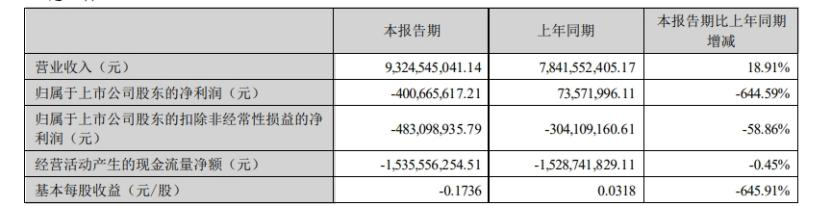
商业化难解。
构建支持和增强人类能力的AI工具,而不是试图完全取代人类。
从一大堆图片中精准找图,有新招了!论文已经中了ECCV 2024。
Attention is all you need.