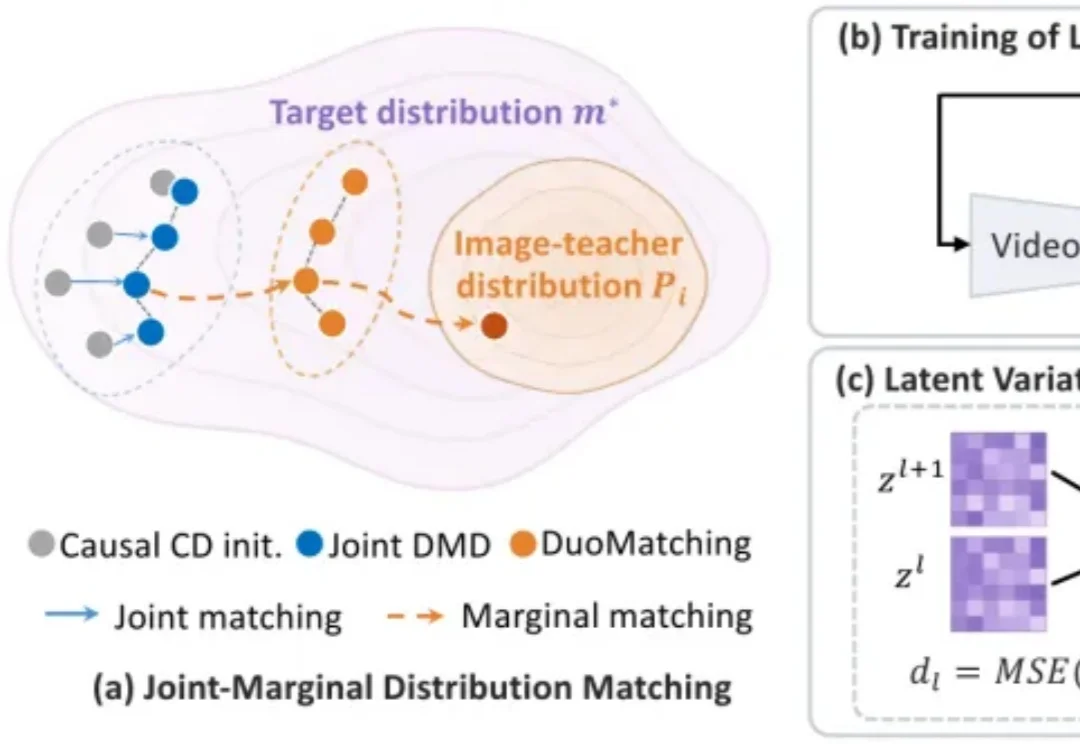
少步视频生成不再牺牲画质!双重分布匹配方案实现又快又好
少步视频生成不再牺牲画质!双重分布匹配方案实现又快又好在视频生成领域,少步视频模型已经实现只需少量采样步骤,就能生成连续画面。
来自主题: AI技术研报
10344 点击 2026-10-23 09:58

 搜索
在视频生成领域,少步视频模型已经实现只需少量采样步骤,就能生成连续画面。
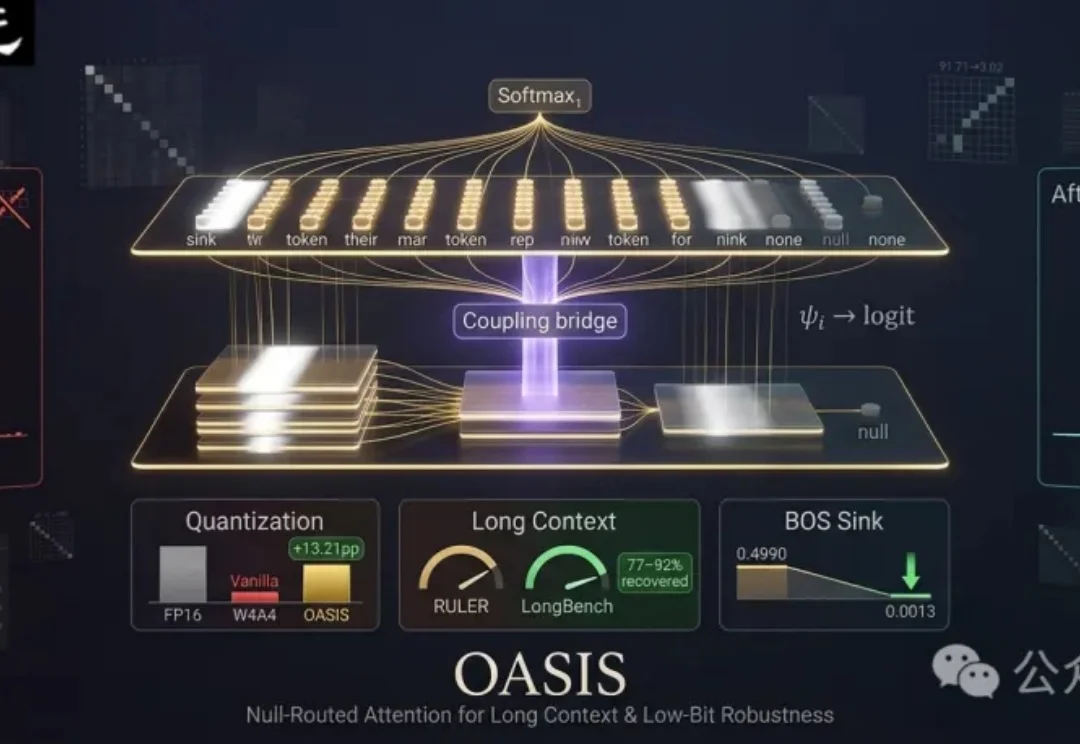
增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。
一个有些反直觉的现实是: AI已经在企业里被广泛用起来了,但很多公司的生产力并没有因此明显上升。
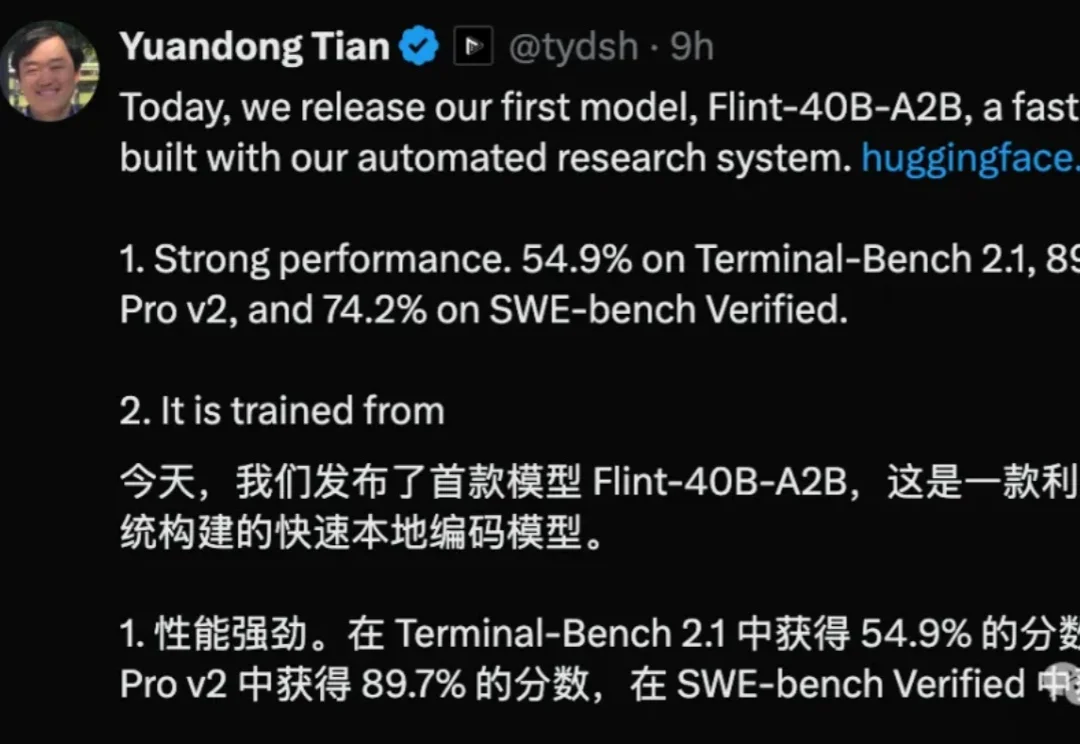
40B的MoE“程序员”,MacBook Pro就能带走了!
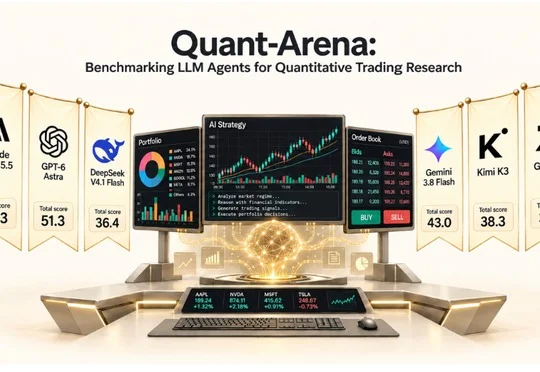
EinsiaAI旗下Navers Lab发布Quant Arena,将6家厂商的9个模型置于A股历史数据中评测,4个代表策略盈利、5个亏损,最佳GPT-6 Astra年化收益10.7%仍低于17.1%的市场基准。
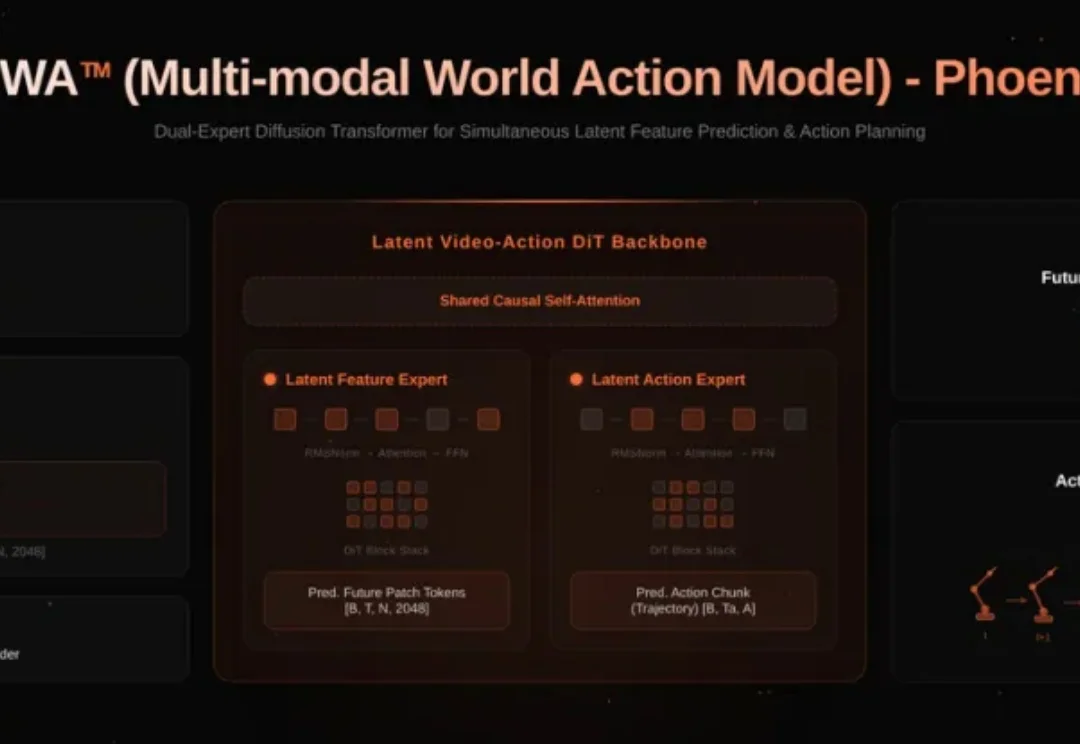
今日,无界动力正式发布并开源 MWA™-Phoenix 隐空间世界模型基座,横扫 LIBERO-Plus、LIBERO-Pro、RoboCasa GR1、Bench2Dex、RoboTwin 2.0 和 RoboDojo 真机榜。
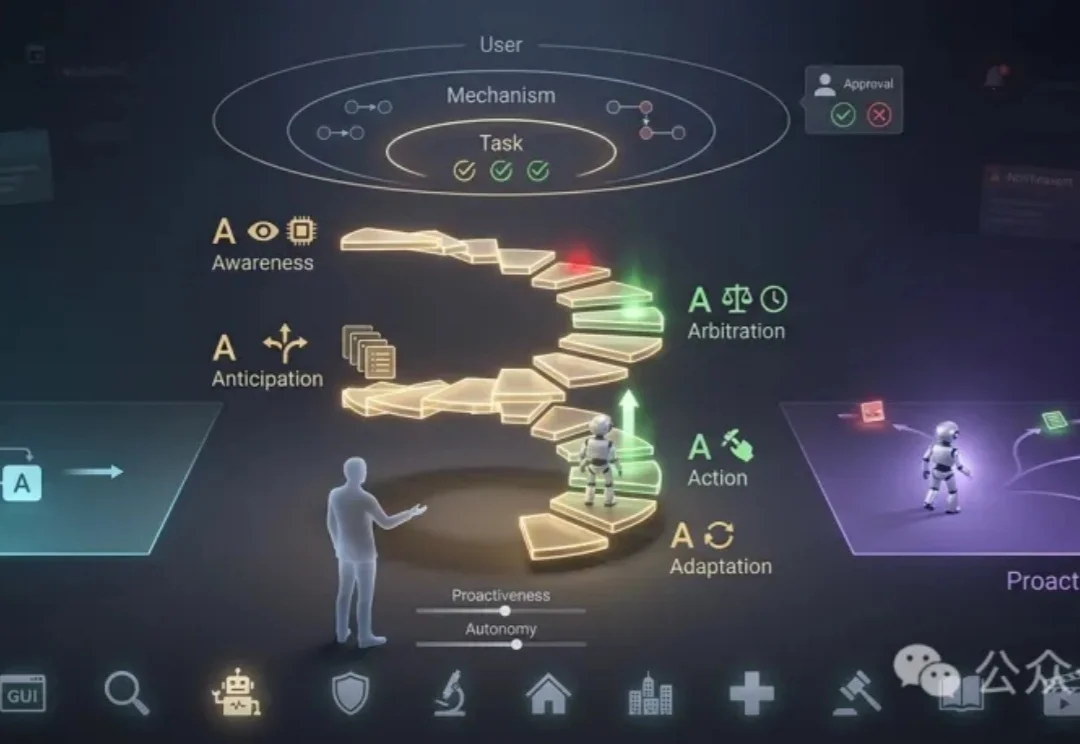
1995年,Michael Wooldridge和Nicholas Jennings在《Intelligent Agents: Theory and Practice》中,将自主性(Autonomy)、交互能力(Social Ability)、反应性(Reactivity)和主动性(Proactiveness)列为智能体的四项基本特征。
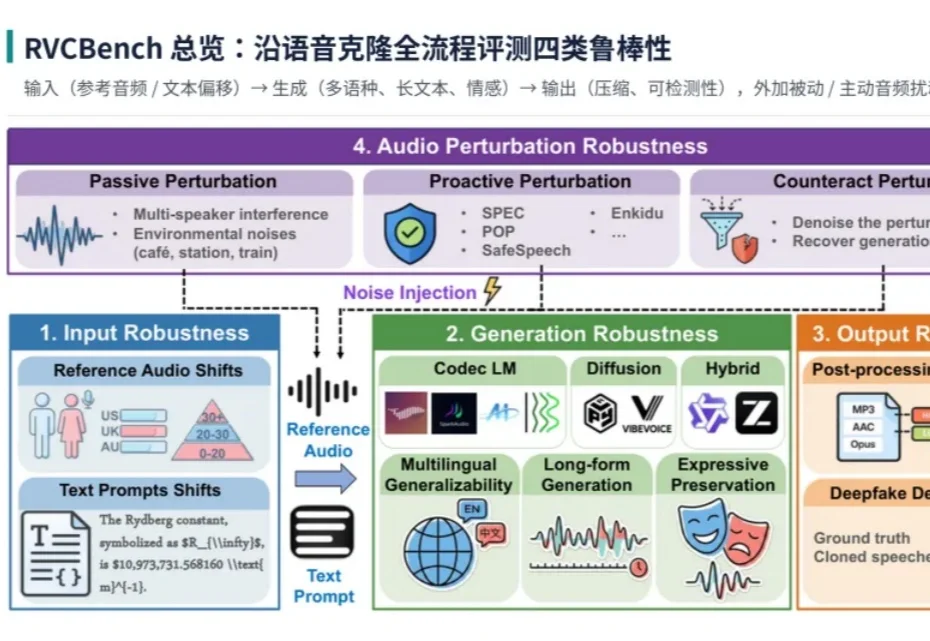
导读:只需几秒参考音频,现代语音克隆模型就能合成与目标说话人高度相似的语音。但真实部署中的参考录音往往带有噪声,文本可能异常、超长或跨语言,生成的语音还要经过压缩和电话传输,有人甚至会给自己的声音加上「防克隆」保护。
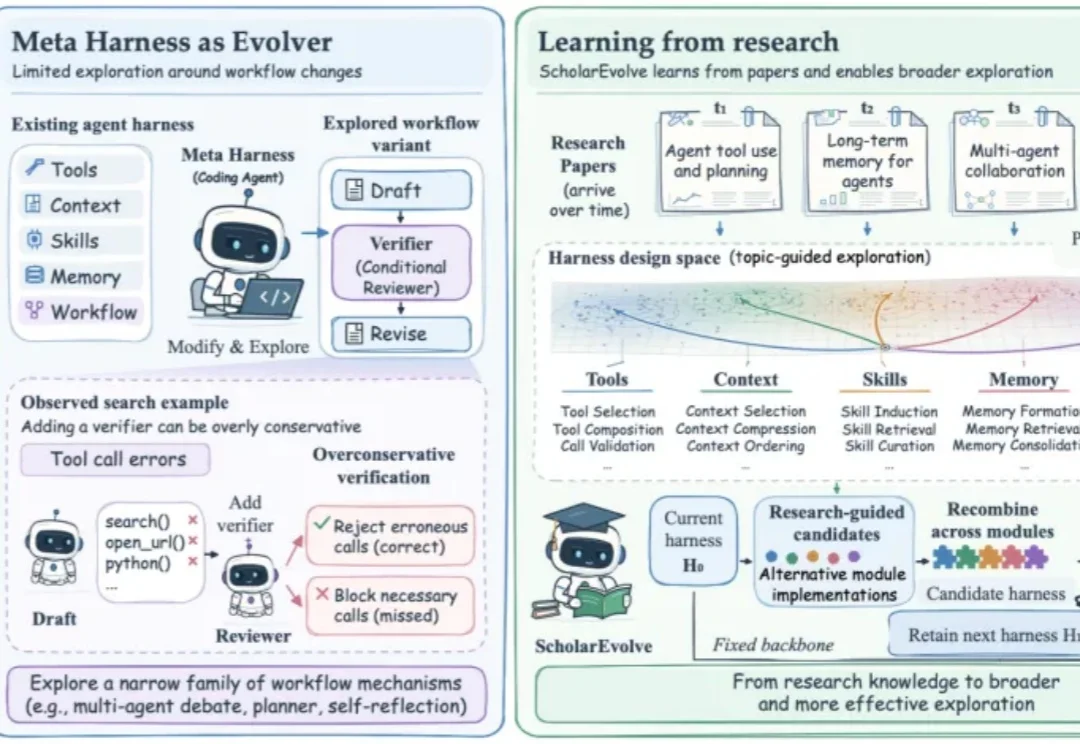
AI Agent 能否像研究人员一样,从论文中学习?
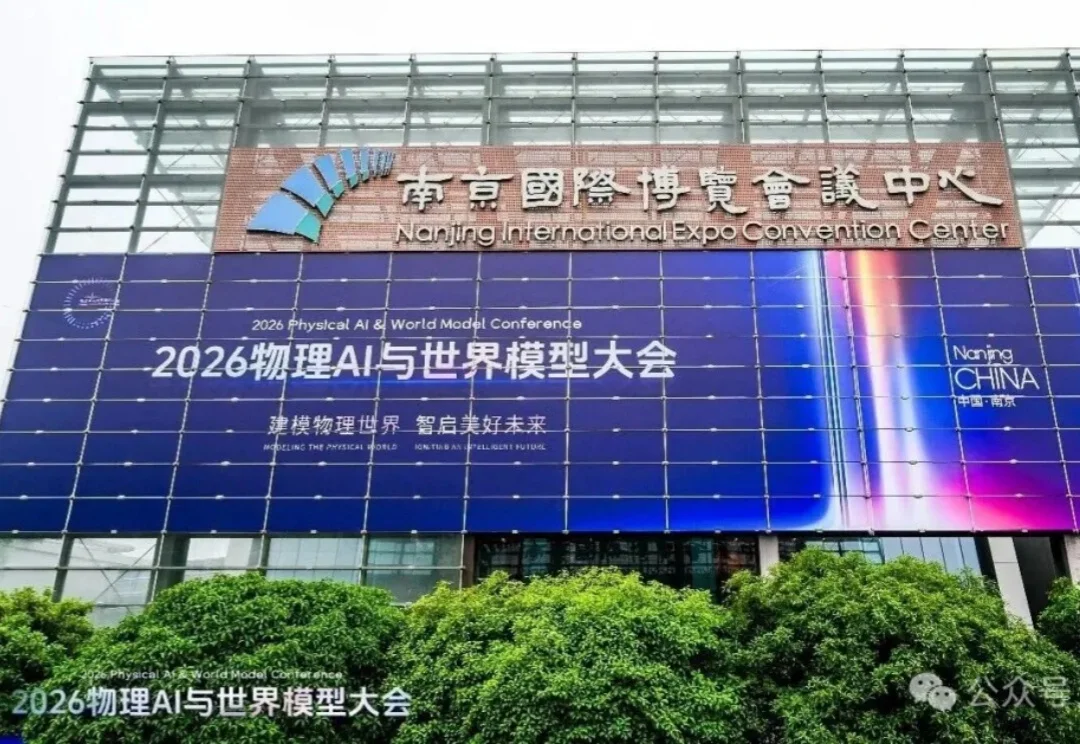
七十年前,在达特茅斯学院的会议室里,“人工智能”的概念首次落笔,开启了机器模拟人类思考的漫长探索;七十年后的今天,AI的时代之问早已从“机器能不能计算”进阶为“机器能不能理解世界”。