科研人的“超级外挂”来了,中科闻歌磐石用ScienceOne打通AI研究全流程
科研人的“超级外挂”来了,中科闻歌磐石用ScienceOne打通AI研究全流程最近,世界人工智能大会上,中科闻歌磐石 ScienceOne 团队一口气亮出两张王牌:专攻科学场景下深入理解、预测与生成的科学多模态统一推理模型 —— S1-Omni;以 S1-Omni 为基座、贯穿整个科研生命周期的智能化服务平台 —— ScienceOne。
搜索
最近,世界人工智能大会上,中科闻歌磐石 ScienceOne 团队一口气亮出两张王牌:专攻科学场景下深入理解、预测与生成的科学多模态统一推理模型 —— S1-Omni;以 S1-Omni 为基座、贯穿整个科研生命周期的智能化服务平台 —— ScienceOne。
7月18日,AI圈忽然被这个消息刷屏了。一个名为「Basalt Labs」的神秘中国AI实验室,忽然空降。没有任何预热、没有任何预告,他们在X上扔出了一枚重磅消息——发布Monolith-1.0模型,登顶世界第一!
世界模型牌桌上,昆仑万维已连出五张牌,一张比一张大。
凌晨两点,城市睡着了,前置仓还醒着。
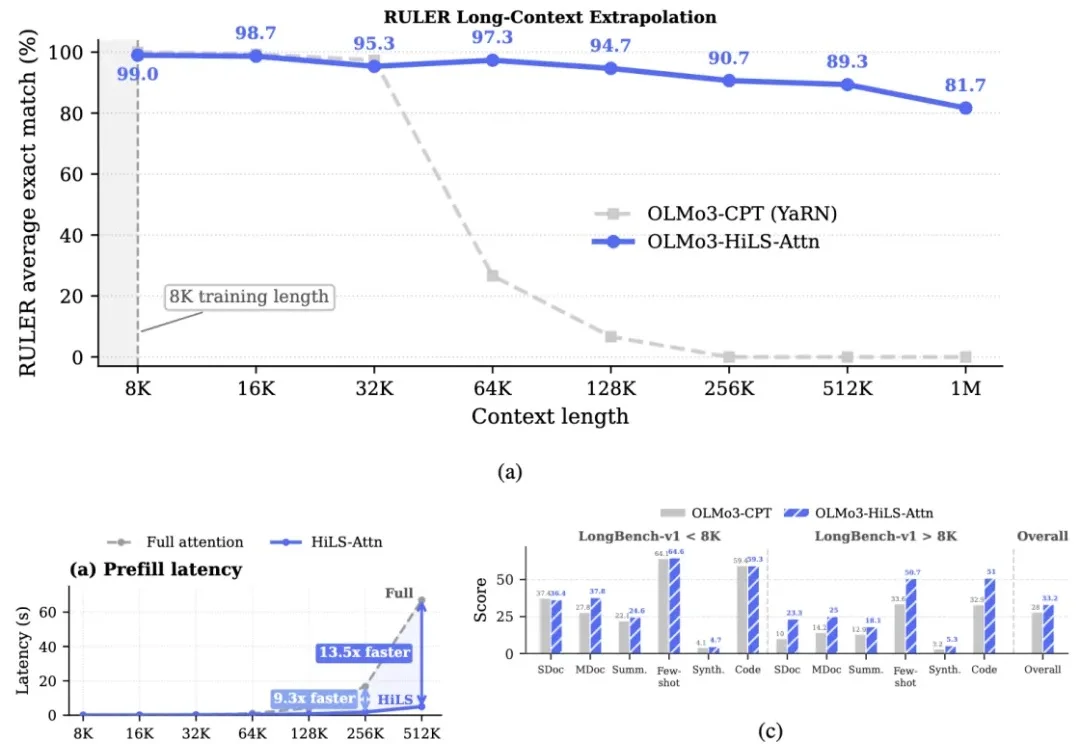
让大模型 "读得更长" 一直是 Agent、深度推理和海量资料整合等场景的刚需,但标准全注意力机制的计算量随序列长度呈平方级增长,始终是横亘在长上下文建模面前的三座大山。
如果你走进2026 WAIC的现场,最直观的感受可能只有一个“卷”字。
在计算历史的绝大部分时间里,编程的本质是一项翻译工作:开发者需要在人类理解的维度上剖析问题,设计抽象方案,随后将其转译为机器能够执行的语法。当前的软件工程领域正在经历自高级编程语言问世以来最为显著的变化。
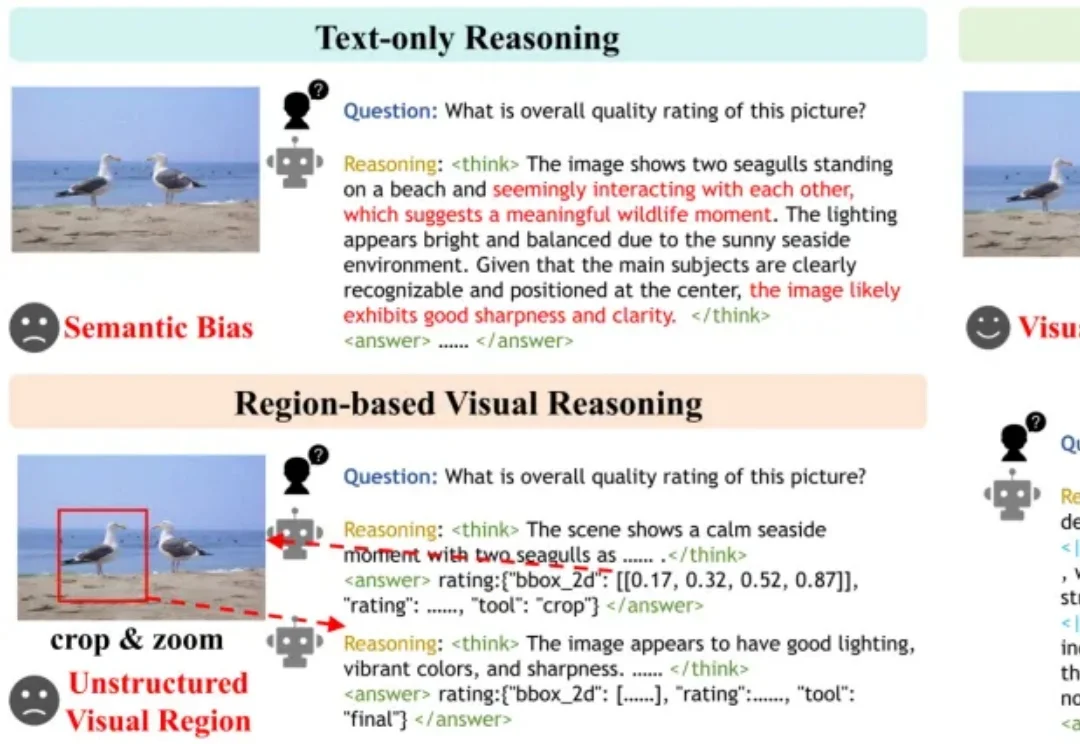
让大模型给一张图片打“质量分”,它其实经常看走眼。
“芯片的定价权越强,模型和应用公司的成本刚性就越难消解。” 当下,仅豆包一家大模型的日均Token调用量就已突破180万亿;国家数据局的统计显示,全国日均调用量在今年3月已超过140万亿——无论从哪个口径衡量,这都是一条两年内从“近乎为零”飙涨超千倍的曲线。
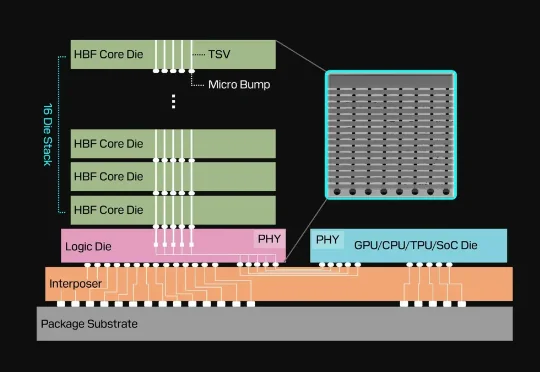
IEEE最新刊发了一条挺反常识的新思路:大模型的内存焦虑,可能要靠U盘里的同款技术来缓解了。没错,就是NAND Flash。但现在,SanDisk和SK海力士正在推动一种新东西:High Bandwidth Flash(高带宽闪存),简称HBF。