DeepSeek惊醒上海,输不起的人工智能之战
DeepSeek惊醒上海,输不起的人工智能之战上海拥有全国1/3的人工智能重点企业、41%的智能芯片产能和日均处理的20PB级城市数据,却在2025年伊始遭遇了尴尬的叩问: 一家总部杭州的初创公司DeepSeek横空出世,其开源大模型的开发者调用量在一周内突破微软亚洲研究院十年累积量,直接促成全球170个国家开发者建立起47万个衍生模型
来自主题: AI资讯
7106 点击 2025-02-10 20:21

 搜索
上海拥有全国1/3的人工智能重点企业、41%的智能芯片产能和日均处理的20PB级城市数据,却在2025年伊始遭遇了尴尬的叩问: 一家总部杭州的初创公司DeepSeek横空出世,其开源大模型的开发者调用量在一周内突破微软亚洲研究院十年累积量,直接促成全球170个国家开发者建立起47万个衍生模型
当我们惊叹于Deepseek的妙语连珠时,是否正目睹硅基系统对人类语言本源的复刻?那在服务器集群中奔流的矩阵运算,与人脑皮层间跳跃的神经电波,究竟共享着怎样的“语言密码”?

DeepSeek的含金量还在上升,一个半个周末过去发生这些大事:国家超算互联网平台上线DeepSeek-R1,最高支持671B的满血版。达摩院玄铁芯片成功适配DeepSeek-R1系列蒸馏模型,在RISC-V架构CPU和端侧平台打开新的应用空间。
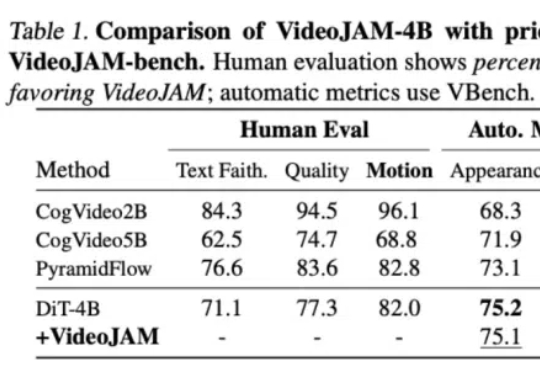
针对视频生成中的运动一致性难题,Meta GenAI团队提出了一个全新框架VideoJAM。VideoJAM基于主流的DiT路线,但和Sora等纯DiT模型相比,动态效果直接拉满:
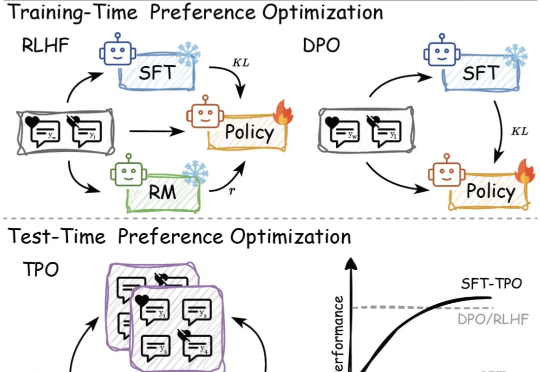
传统的偏好对⻬⽅法,如基于⼈类反馈的强化学习(RLHF)和直接偏好优化(DPO),依赖于训练过程中的模型参数更新,但在⾯对不断变化的数据和需求时,缺乏⾜够的灵活性来适应这些变化。
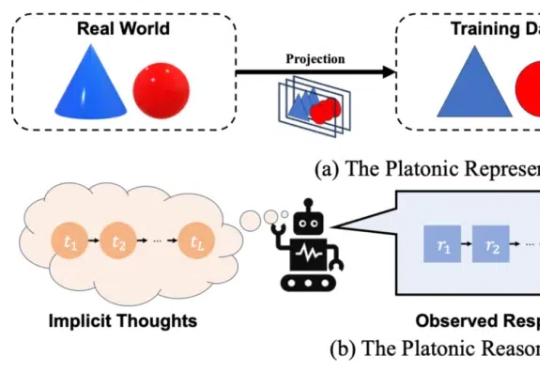
「慢思考」(Slow-Thinking),也被称为测试时扩展(Test-Time Scaling),成为提升 LLM 推理能力的新方向。近年来,OpenAI 的 o1 [4]、DeepSeek 的 R1 [5] 以及 Qwen 的 QwQ [6] 等顶尖推理大模型的发布,进一步印证了推理过程的扩展是优化 LLM 逻辑能力的有效路径。
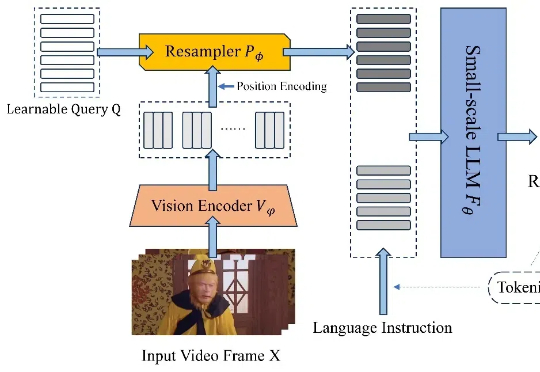
近日,北京航空航天大学的研究团队基于 TinyLLaVA_Factory 的原项目,推出小尺寸简易视频理解框架 TinyLLaVA-Video,其模型,代码以及训练数据全部开源。在计算资源需求显著降低的前提下,训练出的整体参数量不超过 4B 的模型在多个视频理解 benchmark 上优于现有的 7B + 模型。
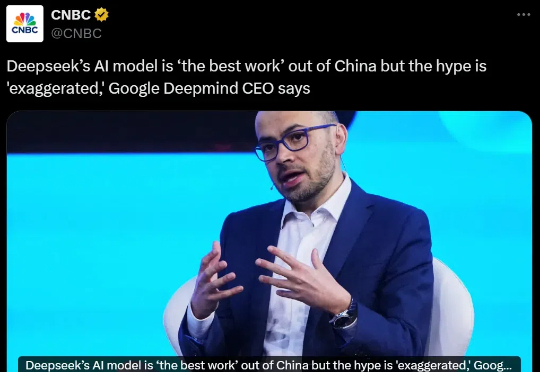
xAI、谷歌DeepMind和Anthropic的CEO们纷纷对DeepSeek的技术创新性提出质疑,认为其并未带来实质性的科学突破。AI大佬纷纷泼冷水,到底是技术讨论还是各怀目的?
DreamTech,由牛津大学、南京大学等顶尖高校研究者组成的AI创业团队,在春节期间公布了他们在3D生成方向上的新工作成果——Neural4D 2.0(初版名为Direct3D),提出了创新性的3D Assembly Generation算法思路及更高效的模型架构
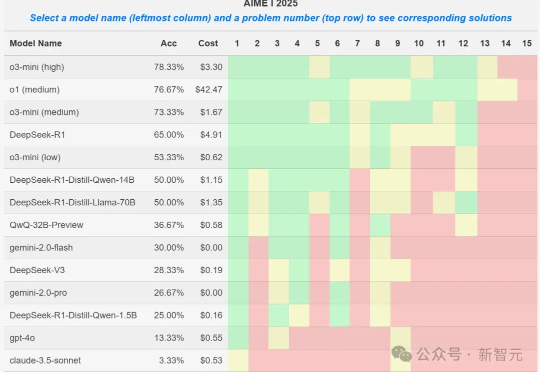
就在刚刚,AIME 2025 I数学竞赛的大模型参赛结果出炉,o3-mini取得78%的最好成绩,DeepSeek R1拿到了65%,取得第四名。然而一位教授却发现,某些1.5B小模型竟也能拿到50%,莫非真的存在数据集污染?