Beidi Chen陈贝迪 独家 | 高效长序列生成之路:CPU & GPU —— 算法、系统与硬件的 co-design
Beidi Chen陈贝迪 独家 | 高效长序列生成之路:CPU & GPU —— 算法、系统与硬件的 co-design本期我们邀请到了 纽约大学计算机科学院博士 童晟邦 带来【多模态大模型:视觉为中心的探索】的主题分享。
来自主题: AI技术研报
13692 点击 2024-08-21 10:39

 搜索
本期我们邀请到了 纽约大学计算机科学院博士 童晟邦 带来【多模态大模型:视觉为中心的探索】的主题分享。
虽然大语言模型(LLM)的能力不断突破,但在长文生成方面却一直存在瓶颈。近日,清华大学和智谱AI联合发布的最新研究成果,为解决这一难题提供了创新方案。这项名为"LongWriter"的技术,成功将AI模型的长文生成能力从约2000字提升至10000字以上,同时保持了高质量输出。这一成果通过创新的数据构建方法、模型训练策略和评估基准,为AI长文创作开辟了新天地。
AI掌握自我设计的权力,将会怎样?最近,来自UBC等机构研究人员提出了「智能体自动化设计」系统,让元智能体使用搜索算法,自动构建强大的同类。

作为基础的视觉语言任务,指代表达理解(referring expression comprehension, REC)根据自然语言描述来定位图中被指代的目标。REC 模型通常由三部分组成:视觉编码器、文本编码器和跨模态交互,分别用于提取视觉特征、文本特征和跨模态特征特征交互与增强。
“乱世”其实早已到来,只不过这次是公开承认了这个现实。
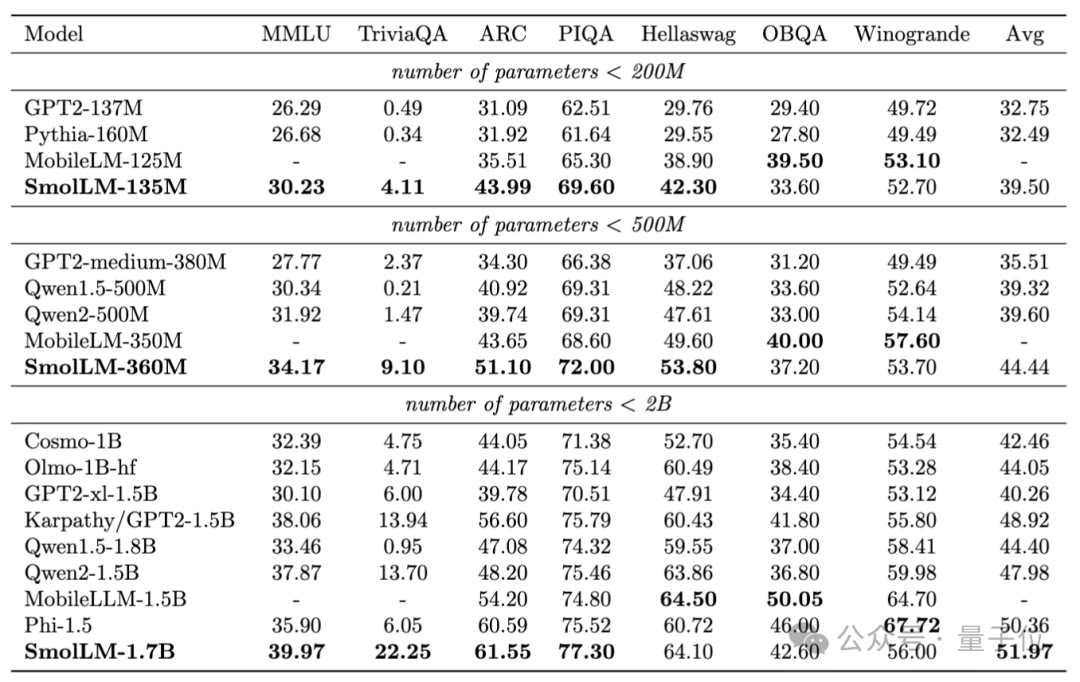
浏览器里直接能跑的SOTA小模型来了,分别在2亿、5亿和20亿级别获胜,抱抱脸出品。

合成数据2.0秘诀曝光了!来自微软的研究人员们提出了智能体框架AgentInstruct,能够自动创建大量、多样化的合成数据。经过合成数据微调后的模型Orca-3,在多项基准上刷新了SOTA。
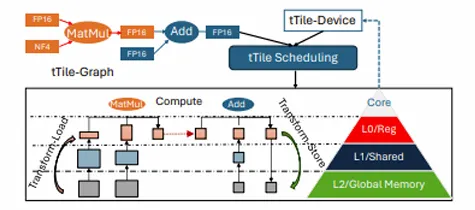
在人工智能领域,模型参数的增多往往意味着性能的提升。但随着模型规模的扩大,其对终端设备的算力与内存需求也日益增加。低比特量化技术,由于可以大幅降低存储和计算成本并提升推理效率,已成为实现大模型在资源受限设备上高效运行的关键技术之一。然而,如果硬件设备不支持低比特量化后的数据模式,那么低比特量化的优势将无法发挥。
越来越多研究发现,后训练对模型性能同样重要。Allen AI的机器学习研究员Nathan Lambert最近发表了一篇技术博文,总结了科技巨头们所使用的模型后训练配方。
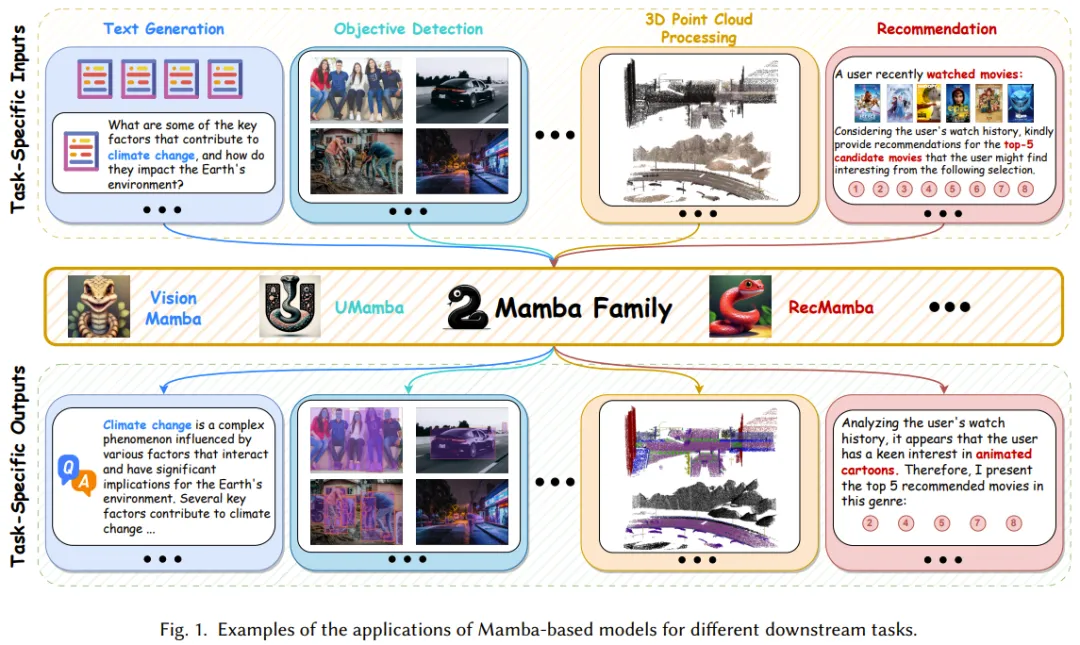
Mamba 虽好,但发展尚早。