1300亿!曝OpenAI花大价钱给英伟达找备胎
1300亿!曝OpenAI花大价钱给英伟达找备胎据外媒The Information报道,OpenAI将在未来三年内支付超200亿美元(约合人民币1364.3亿元)购买美国AI芯片独角兽Cerebras的芯片。作为协议的一部分,OpenAI将获得Cerebras少数股份的认股权证。此外,OpenAI还将向Cerebras提供约10亿美元(约合人民币68.2亿元),用于资助开发运行其AI产品的数据中心。
搜索
据外媒The Information报道,OpenAI将在未来三年内支付超200亿美元(约合人民币1364.3亿元)购买美国AI芯片独角兽Cerebras的芯片。作为协议的一部分,OpenAI将获得Cerebras少数股份的认股权证。此外,OpenAI还将向Cerebras提供约10亿美元(约合人民币68.2亿元),用于资助开发运行其AI产品的数据中心。
“它将成为有史以来产量最高的 AI 芯片之一。”
凌晨,英伟达CEO黄仁勋接受了知名科技主持人Dwarkesh Patel的专访,长达1小时45分钟。
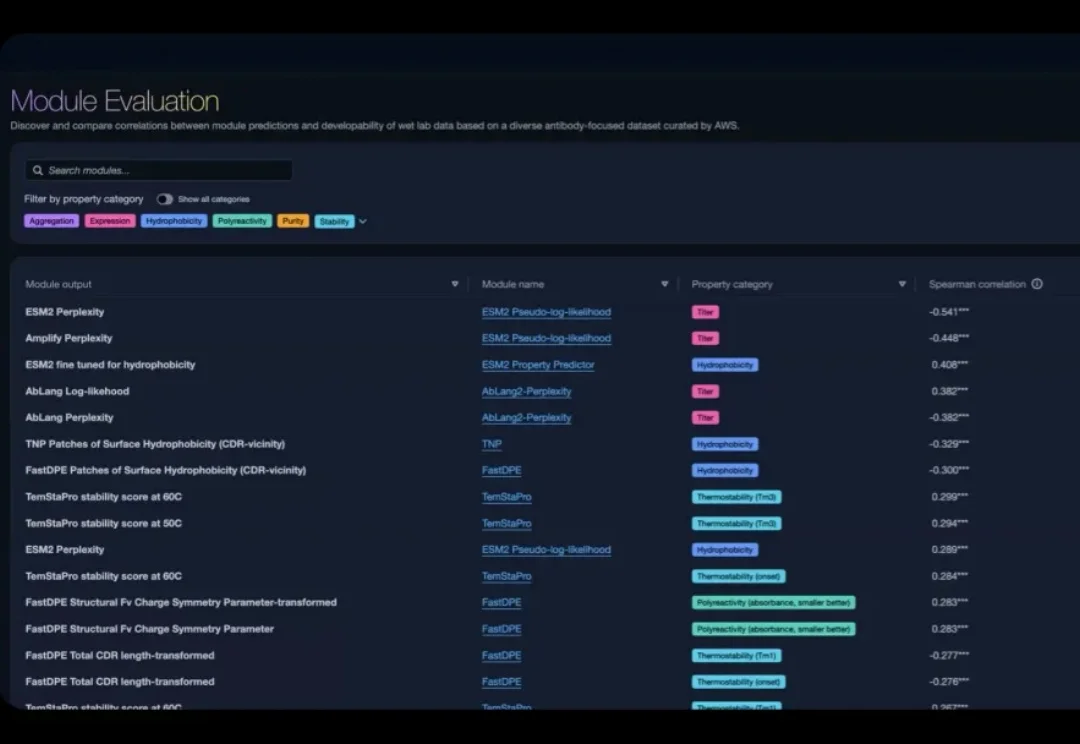
巨头亚马逊,也深度入局生命科学了。
「Ising 改变了一切。」
卡住英伟达Rubin产能的,既不是GPU也不是HBM,竟是一张绝缘薄膜?全球95%以上的供应,握在一家你只听过它味精的日本公司手里。
硅谷「华人地图第一人」入局具身数据赛道。
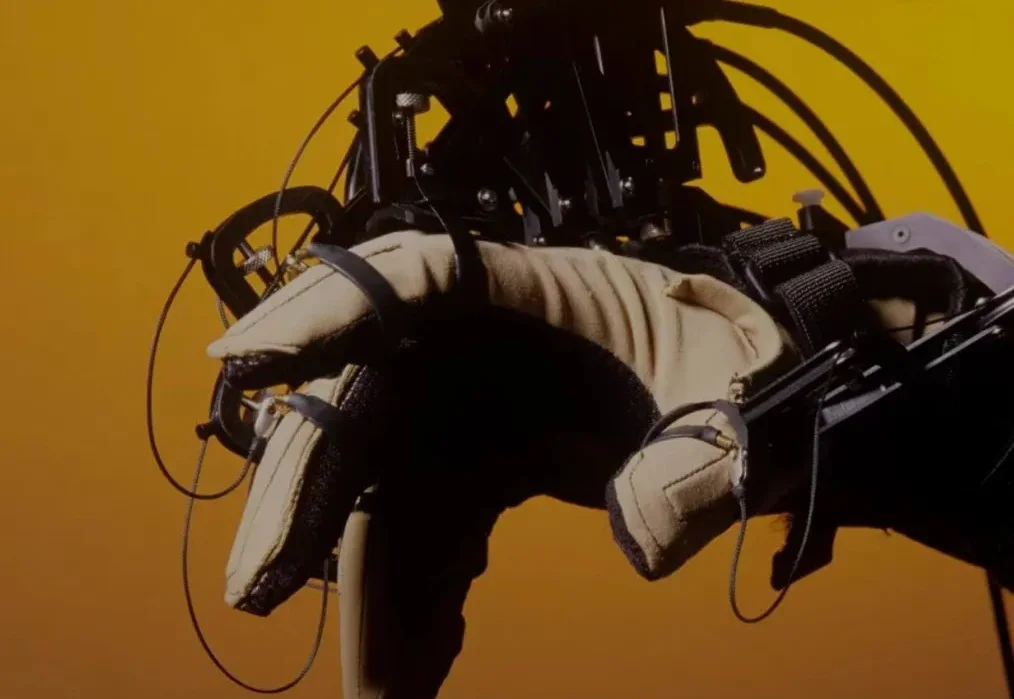
Harness(驾驭)的风,终究还是从大模型,吹到了机器人!
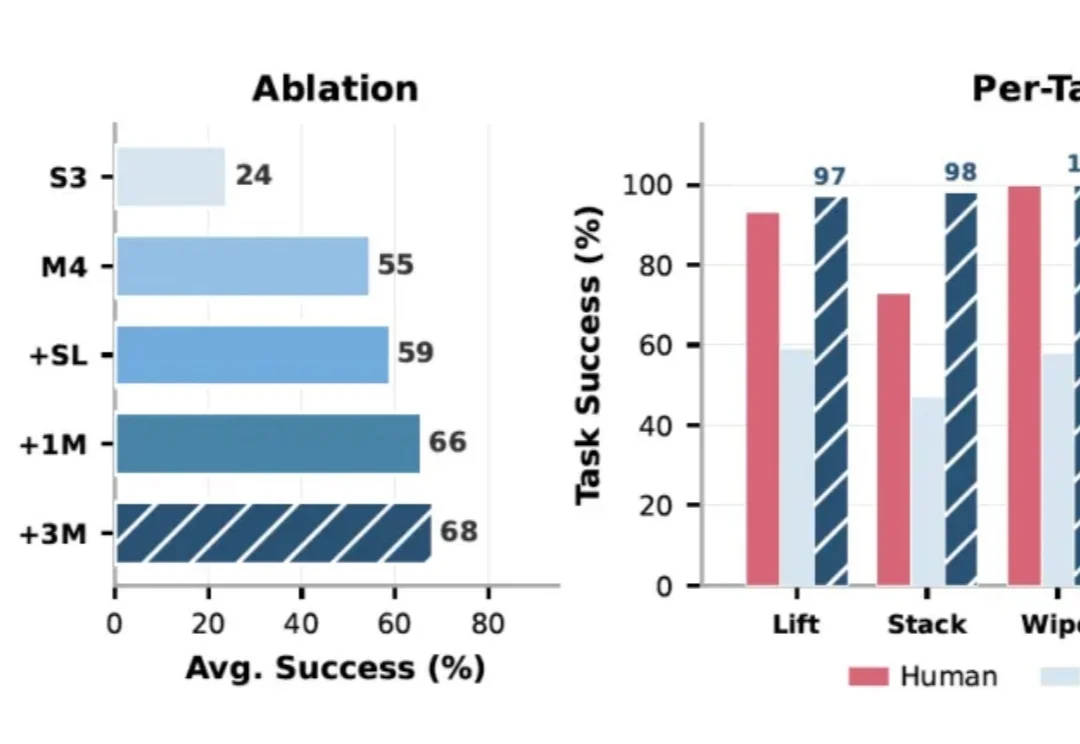
具身数据层的全球竞赛正在迅速升温。NVIDIA Research在2026年发布EgoScale数据与训练框架,在Ego-centric人类操作视频上训练VLA模型,用 20,854小时带动作标注的第一人称人类视频,观察到数据规模和验证损失之间接近对数线性的scaling law。1X收集人类第一视角及家庭行为数据,通过 Sunday项目采集百万小时级家庭场景视频。
在生成式 AI 领域,视觉分词器(Visual Tokenizer)通常采用固定压缩率 —— 无论是单调的监控画面,还是复杂的动作大片,都被切分为等量的 Token。这种 "一刀切" 的做法不仅会造成巨大的计算冗余,也产生了 “信息量” 不同的 Token,不利于下游理解生成任务处理。