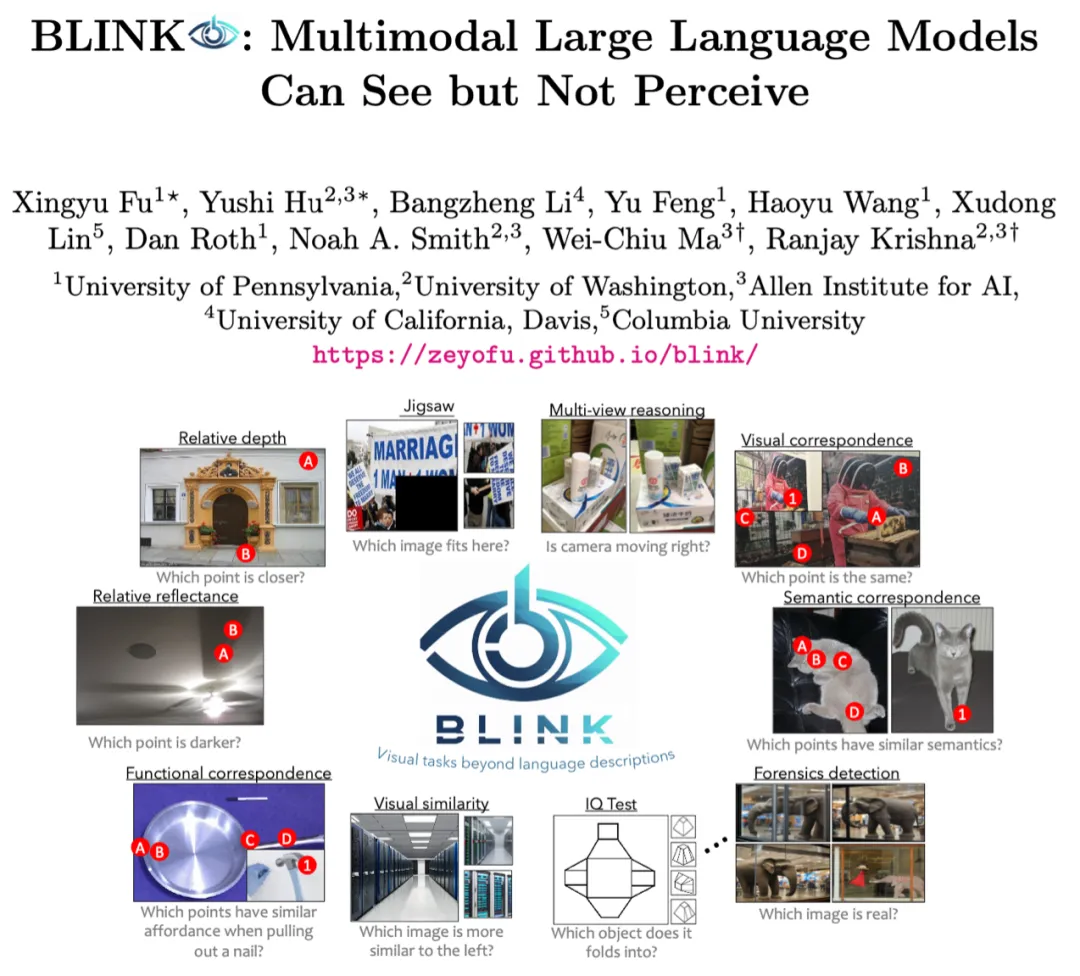
14 项任务测下来,GPT4V、Gemini等多模态大模型竟都没什么视觉感知能力?
14 项任务测下来,GPT4V、Gemini等多模态大模型竟都没什么视觉感知能力?2023-2024年,以 GPT-4V、Gemini、Claude、LLaVA 为代表的多模态大模型(Multimodal LLMs)已经在文本和图像等多模态内容处理方面表现出了空前的能力,成为技术新浪潮。
来自主题: AI技术研报
10438 点击 2024-05-10 23:32

 搜索
2023-2024年,以 GPT-4V、Gemini、Claude、LLaVA 为代表的多模态大模型(Multimodal LLMs)已经在文本和图像等多模态内容处理方面表现出了空前的能力,成为技术新浪潮。