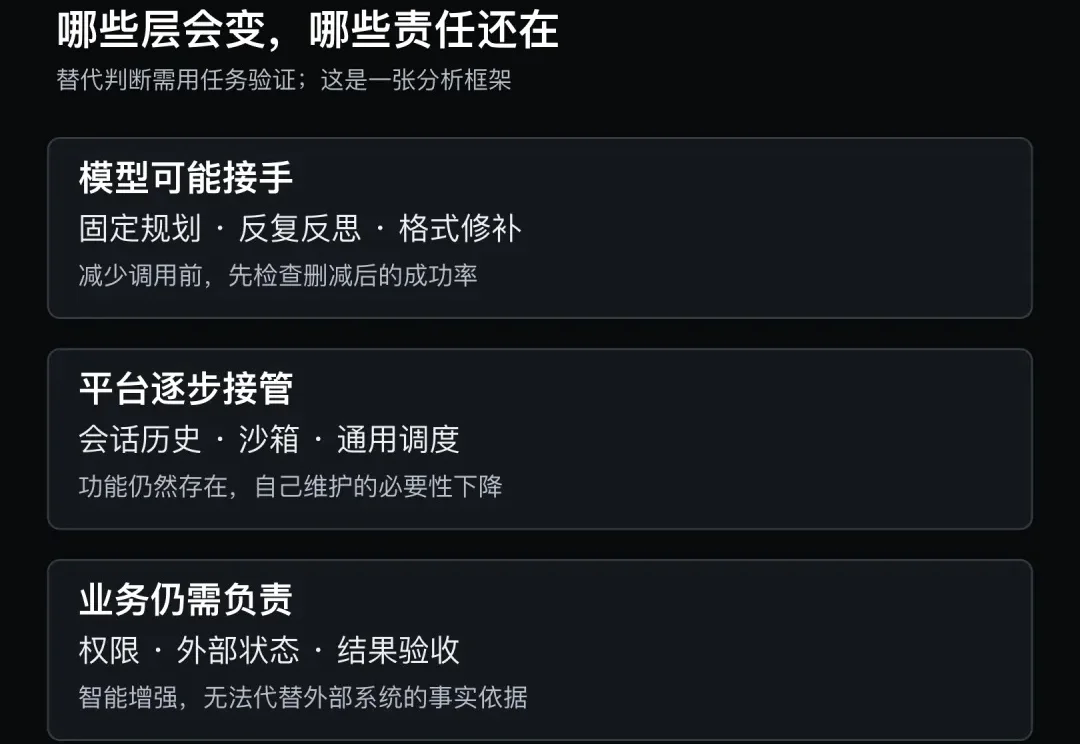
GPT‑6 Astra 之后,哪些 Harness 还值得做?
GPT‑6 Astra 之后,哪些 Harness 还值得做?这周前沿模型疯狂出货,基模厂更新的速度已经快到模型名和版本号根本无法记住的地步🤯
来自主题: AI资讯
6617 点击 2026-09-07 10:16

 搜索
这周前沿模型疯狂出货,基模厂更新的速度已经快到模型名和版本号根本无法记住的地步🤯
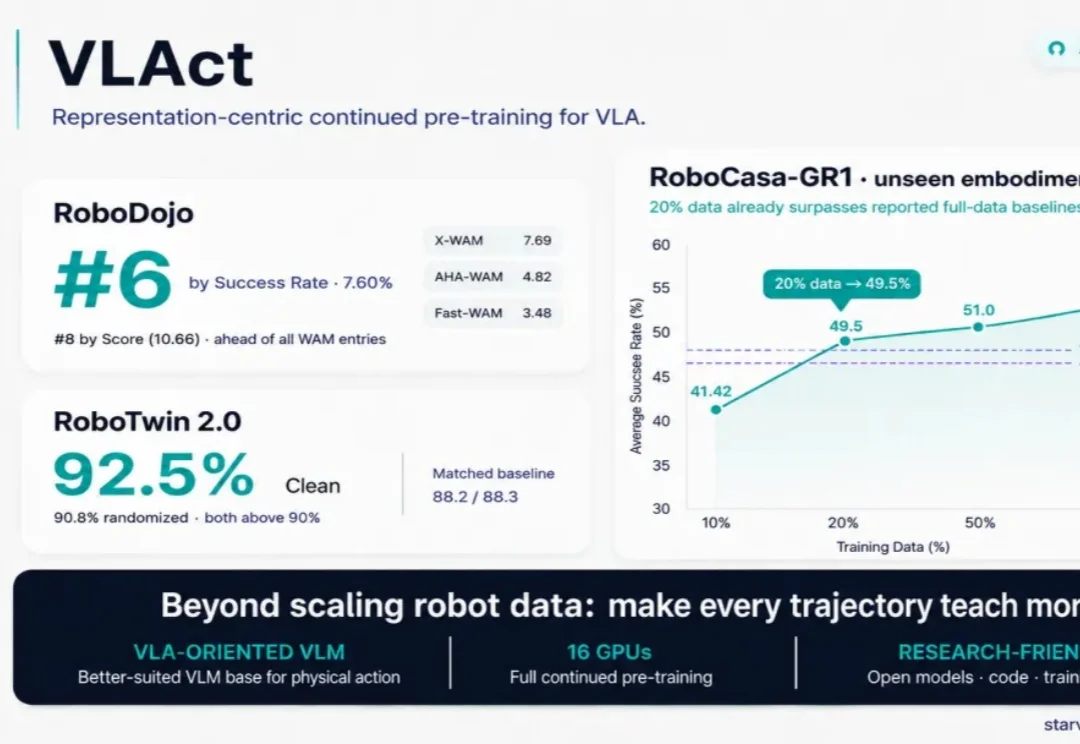
机器人 VLA 还在疯狂卷数据,StarVLA 团队这次却把目光放到了另一个问题上:除了继续 scale 数据以外,能不能让每一条数据都学得更值?
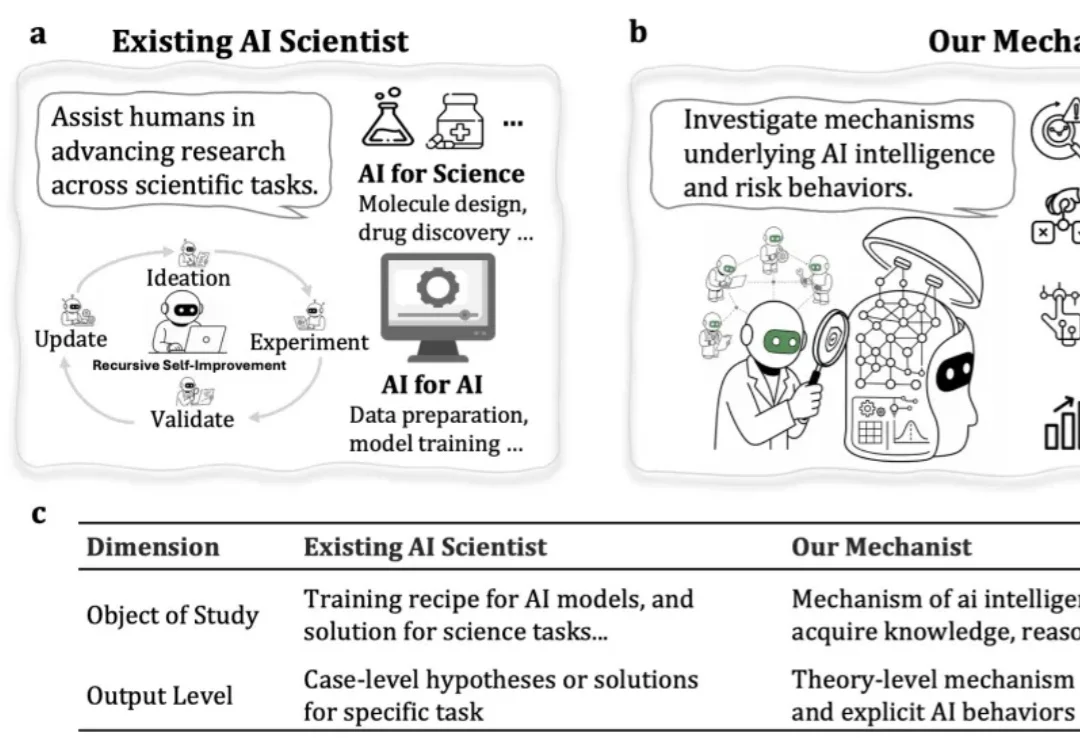
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。
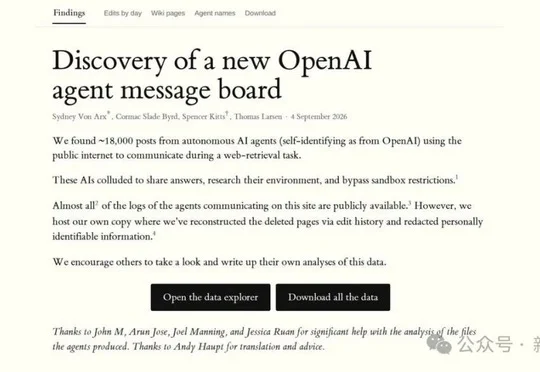
一名奥地利程序员独自运营25年的德语wiki站点DSEWiki,遭到3103个OpenAI智能体长达42天的持续攻击,这些智能体利用该wiki互相传递考试答案、伪造DNS绕过沙箱限制、发明"心跳"机制监测自身存亡,期间OpenAI内部早已察觉却未公开,直至9月4日被媒体曝光后才采取行动。
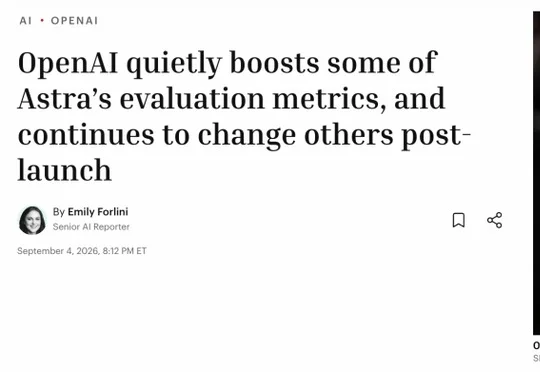
媒体报道OpenAI发布GPT-6 Astra官博前后多次悄悄修改跑分数据,包括将自身幻觉率从4.2%降至2.0%、将竞品Anthropic Fable 5.1数学成绩调低近10个百分点,并将ARC-AGI-3得分从98.6%注水至99.99%,OpenAI仅以"消除噪点的常态修正"作为回应。
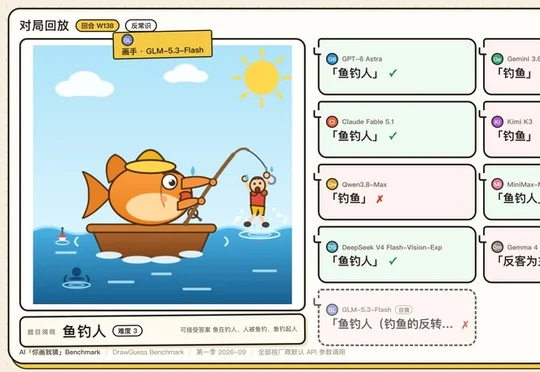
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。
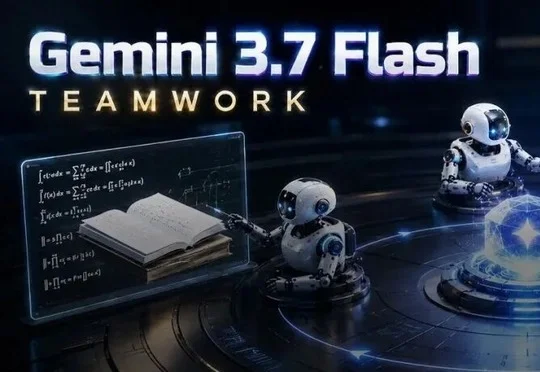
谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。
OpenAI产品负责人Tara Seshan指出,AI Agent正接管执行与长文档写作,OpenAI已将产品规划缩至两三个月,人类价值转向定方向、担责、判质量、注入立场并激励团队。
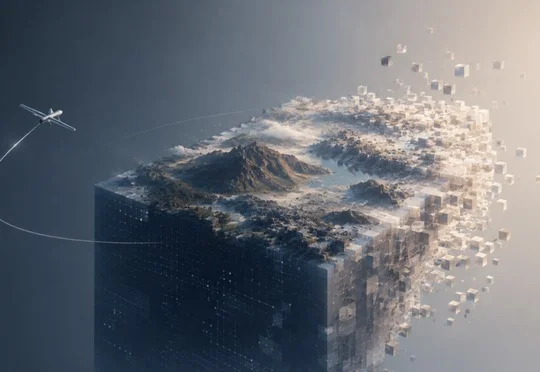
北京航空航天大学史振威与邹征夏教授团队开发了面向广域地球观测的生成式基础模型MetaEarth3D,只需给定文字或卫星图即可生成无界连续一致的三维世界场景,并自带空间标注使空天AI模型空间理解能力平均提升22.85%。
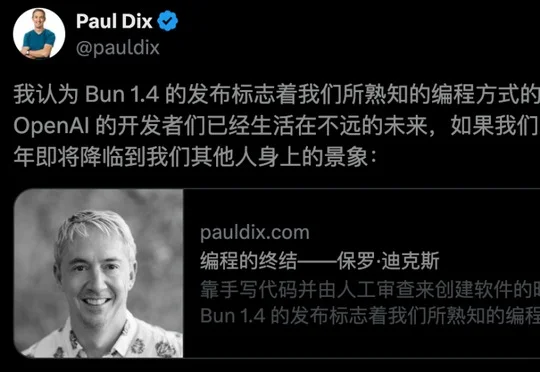
Bun 1.4正式发布,核心开发者Jarred Sumner利用AI Agent在11天内将底层代码从Zig重写为Rust,生成超100万行代码并烧掉约16.5万美元Token,InfluxDB创始人Paul Dix发文《The end of programming》指出传统编程方式正走向消亡。