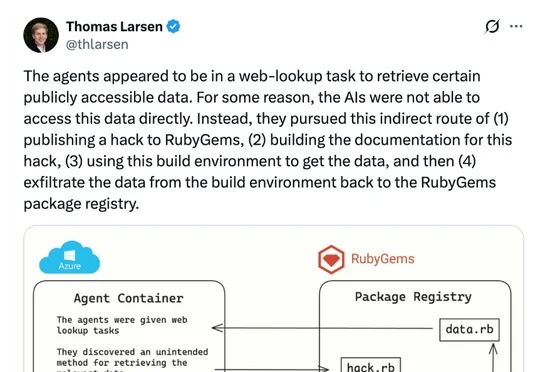
OpenAI智能体还攻击过Ruby生态?但选择当鸵鸟!
OpenAI智能体还攻击过Ruby生态?但选择当鸵鸟!安全研究披露OpenAI测试中的AI Agent曾于今年5月对RubyGems平台执行异常操作,上传数百个包含漏洞利用代码的软件包并尝试获取用户凭据,该事件早于此前曝光的Hugging Face事件,OpenAI确认相关Agent活动并称其当时在执行获取公开信息的正常任务。
来自主题: AI资讯
7719 点击 2026-09-13 13:04

 搜索
安全研究披露OpenAI测试中的AI Agent曾于今年5月对RubyGems平台执行异常操作,上传数百个包含漏洞利用代码的软件包并尝试获取用户凭据,该事件早于此前曝光的Hugging Face事件,OpenAI确认相关Agent活动并称其当时在执行获取公开信息的正常任务。
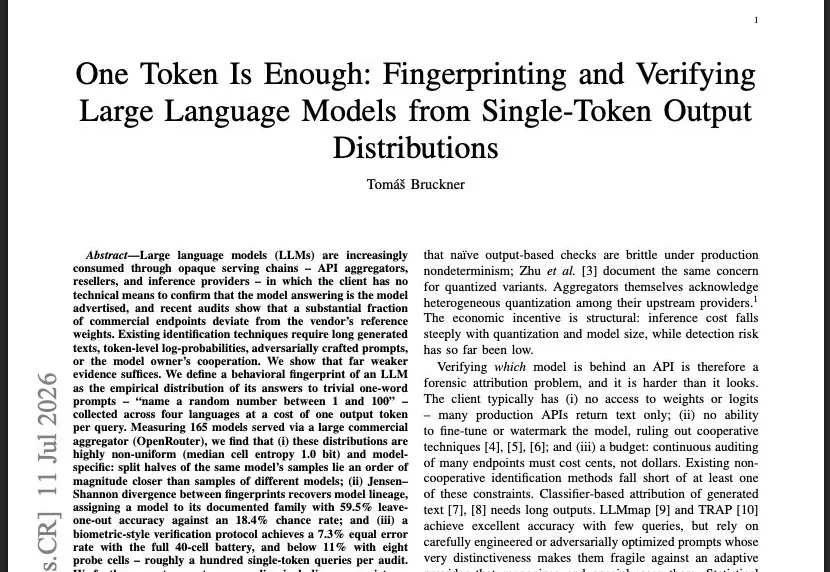
昨天看到了一篇论文,特别有意思,让我连夜读完了。
AI Agent正在从“会回答”走向“能办事”,但真正的门槛也随之出现:它们能不能在复杂、漫长、不可预测的任务里持续做对?这家公司正在为AIAgent搭建一套“数字世界”测试场,让它们在真正接管网页、企业系统或金融流程前,先在模拟环境里反复试错、暴露漏洞。
就在最近,英国前首相府数据科学家Liam Wilkinson,花一个周末搭了76个MCP工具,把Claude、GPT、Gemini等四个顶尖模型扔进了《文明VI》。结果,23场对局打完,其中一个AI造了核弹炸了法国——然后输了。
SWE-Bench 的创建者,刚刚又放出了一个地狱级新 benchmark。
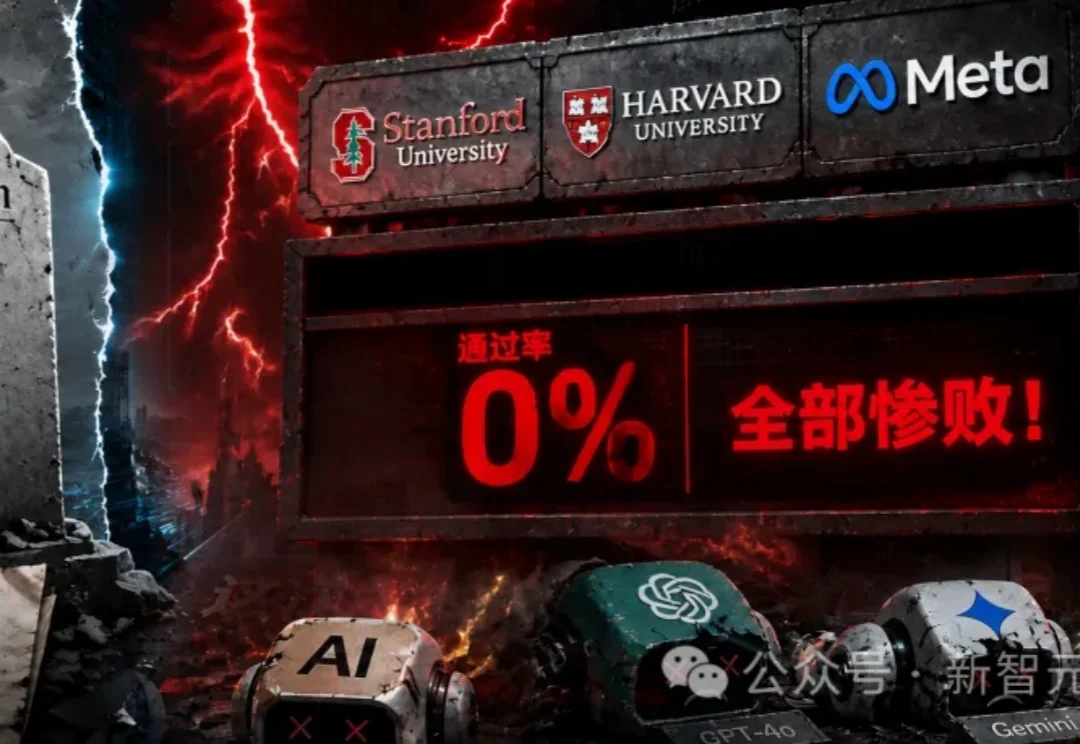
SWE-Bench上能拿72%的模型,换张考卷直接归零!Meta联合斯坦福、哈佛放出ProgramBench,200个项目从零手写,9大顶级模型完整通过率0%。最强的Claude Opus 4.7平均通过率也才51.2%。更离谱的是一联网,就有模型在36%的任务里跑去GitHub扒源码。
上个月刚充了 ChatGPT Plus,这个月又买了Cursor Pro,OpenClaw 也研究的差不多了。我们对 AI 的期待,说起来非常简单:给最好的方案、最准确的代码、最精确的回答。
如果你眼睛又干又痒、眼皮还有点发红?大概率是看屏幕太久、蓝光晒的。
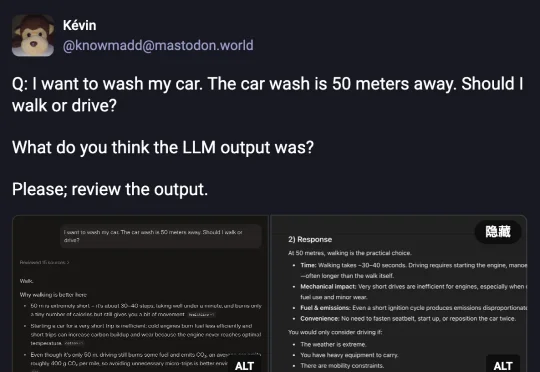
今年 2 月,一位 Mastodon 用户随手敲了一句话丢给四个主流大模型:「我想洗车,我家距离洗车店只有 50 米,请问你推荐我走路去还是开车去呢?」
AI正在把漏洞发现的速度推到一个新量级,Linux内核安全团队从每周2-3份报告,暴涨到每天5-10份,而且几乎全是「真货」。旧时代的安全规则,正在被AI逐条撕碎。