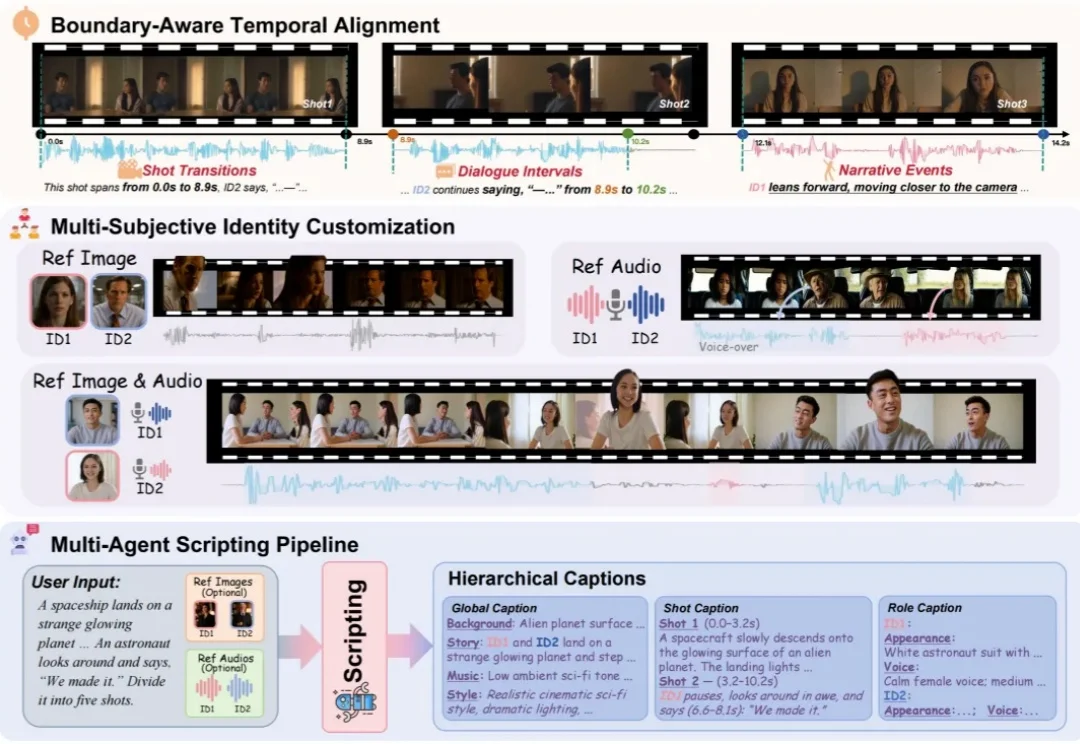
ECCV 2026 Oral|从「一句提示词」到「多镜头成片」:MAVIN让AI开始按剧本讲故事
ECCV 2026 Oral|从「一句提示词」到「多镜头成片」:MAVIN让AI开始按剧本讲故事过去几年,视频生成模型在清晰度、运动表现和画面质感上不断进步。输入一句文字,模型已经能够生成颇具电影感的视频。
来自主题: AI技术研报
9327 点击 2026-08-28 10:02

 搜索
过去几年,视频生成模型在清晰度、运动表现和画面质感上不断进步。输入一句文字,模型已经能够生成颇具电影感的视频。
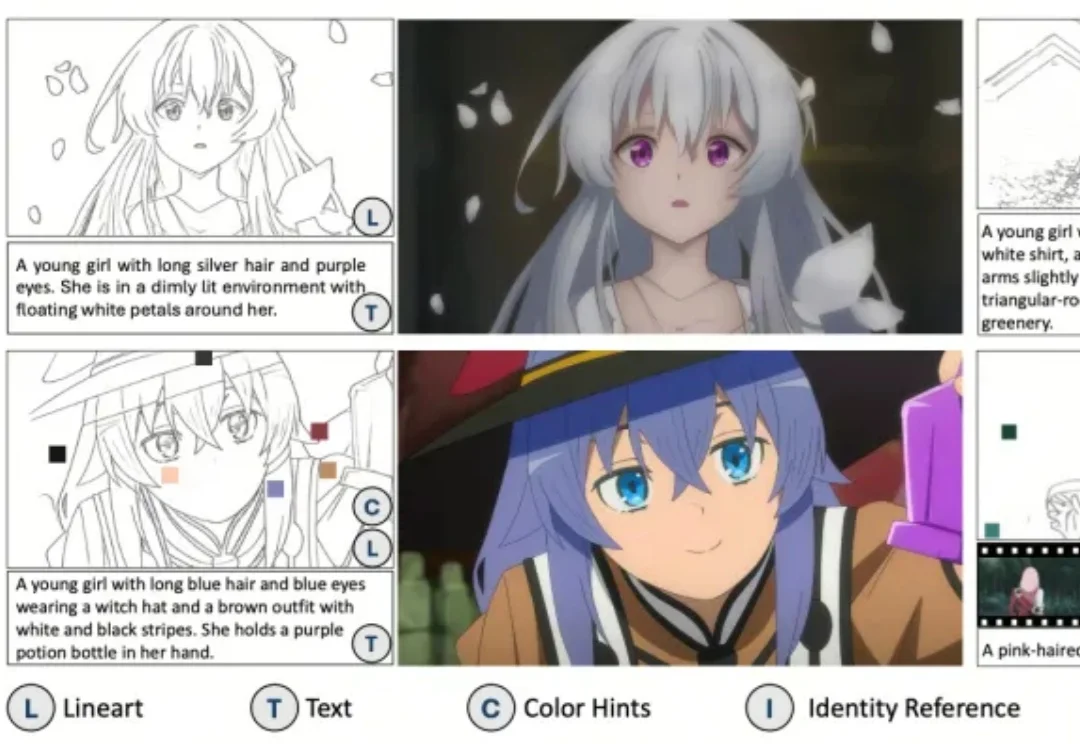
在动画和美术生产中,线稿上色是一个看似基础、却极其依赖细节控制的环节。创作者往往不是简单地把线稿涂上颜色,还需要理解角色身份、遵守局部色块约束、参考前后帧风格,并在连续片段中保持服装、发色、妆容和背景的一致性。

机器人走出实验室后,训练数据不再只是 “多不多” 的问题:环境能否覆盖真实世界的尺度、遮挡、接触和运动,直接决定策略能否落地。Real2Sim 因此重新受到关注 —— 如果普通视频也能变成可交互的仿真场景,采集成本会比人工建模或专用设备低得多。

请想象这样一种居家场景:当你戴着 AI 眼镜在厨房准备晚饭,用刀切菜时,它会立刻提醒你注意安全;当你连续几天形成举着手机长时间录像的习惯时,它会主动建议你换一种更省力的记录方式。

本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。
近日,清华大学与香港科技大学的研究团队提出 LiveEdit,一种面向通用文本指令的实时流式视频编辑框架。该方法以因果、分块的方式处理持续到来的视频,在 4 步 / 视频块的推理条件下实现 12.66 FPS 的流式编辑,并能保持被编辑区域的准确性以及未编辑区域的一致性。
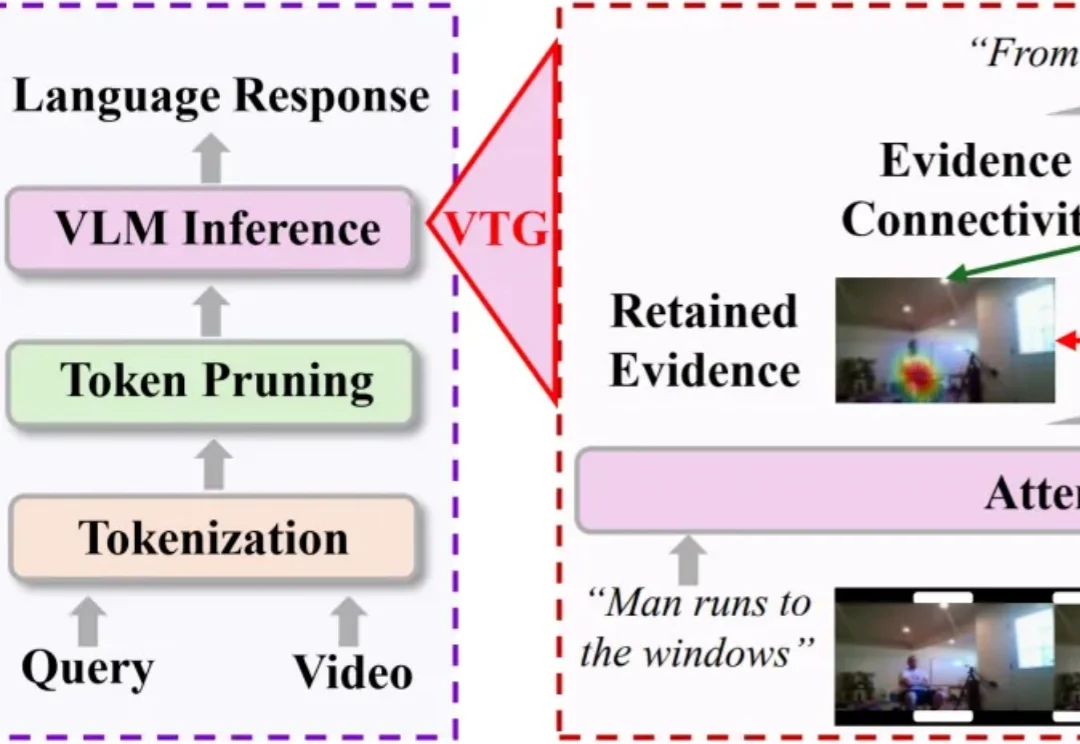
长视频理解,正在成为多模态大模型的重要能力。
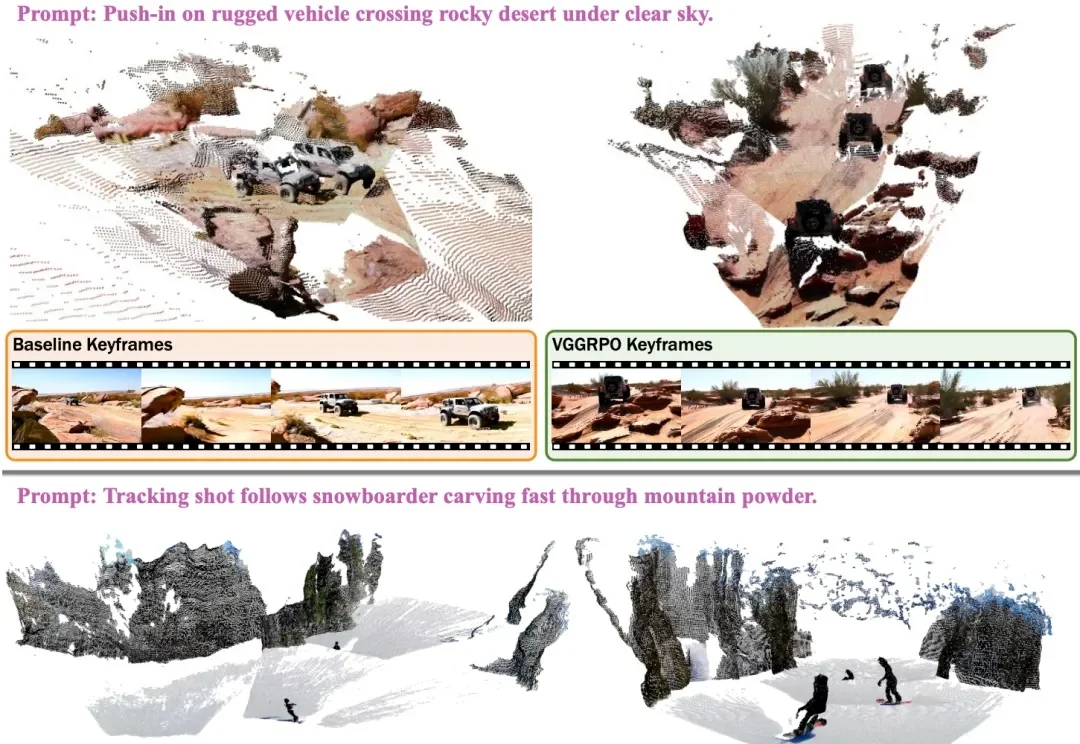
大规模视频扩散模型,画面越来越真,却总在“物理定律”上栽跟头。
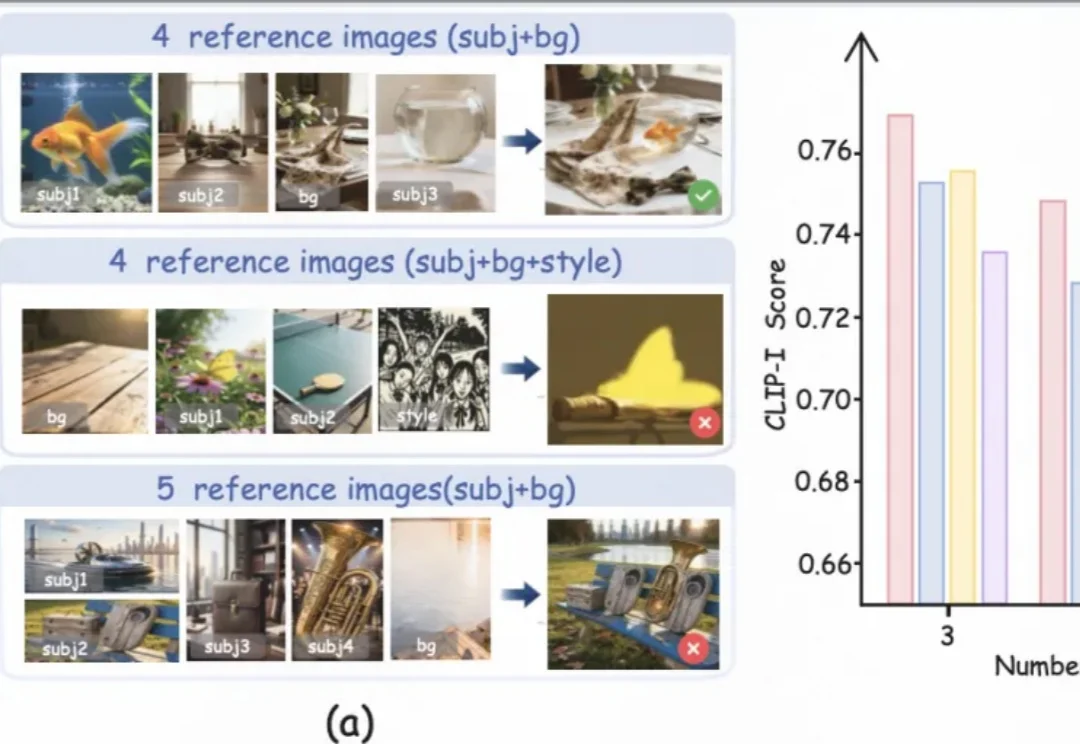
给图像生成模型一张人物参考图,它大概率能抓住身份特征。
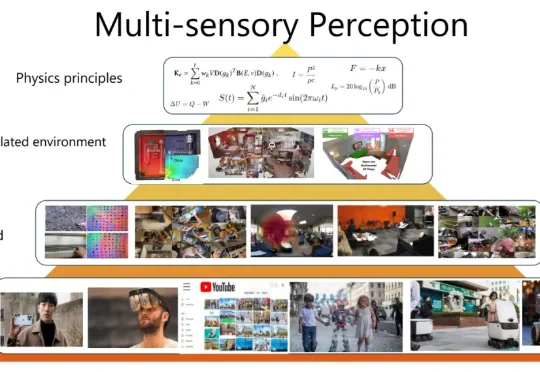
以往的空间音频模型,要么受限于实验室的苛刻采集条件,要么被高昂的人工标注成本卡住脖子。而团队的核心洞察是:相机的自运动本身就是一种免费的监督信号。当相机转动时,声源在声场中的相对位置随之改变——这种变化无需人工标注,模型即可从中学习空间对应关系。这项工作入选CVPR 2025 Highlight,投稿论文前2%。