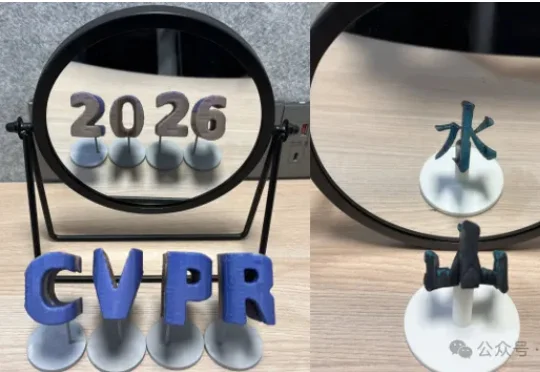
清华弄了个镜像错觉艺术生成器,支持3D打印 | CVPR'26亮点
清华弄了个镜像错觉艺术生成器,支持3D打印 | CVPR'26亮点近日,来自清华大学等单位的研究团队提出了AutoMIA,一种自动生成镜像错觉艺术的 AI 设计方法,用户仅需任意指定两张图片,分别对应镜子前和镜子中的图案,AutoMIA就可以自动完成3维艺术品的设计,并且支持直接3D打印出来制作艺术品。
来自主题: AI资讯
8728 点击 2026-07-24 15:54

 搜索
近日,来自清华大学等单位的研究团队提出了AutoMIA,一种自动生成镜像错觉艺术的 AI 设计方法,用户仅需任意指定两张图片,分别对应镜子前和镜子中的图案,AutoMIA就可以自动完成3维艺术品的设计,并且支持直接3D打印出来制作艺术品。
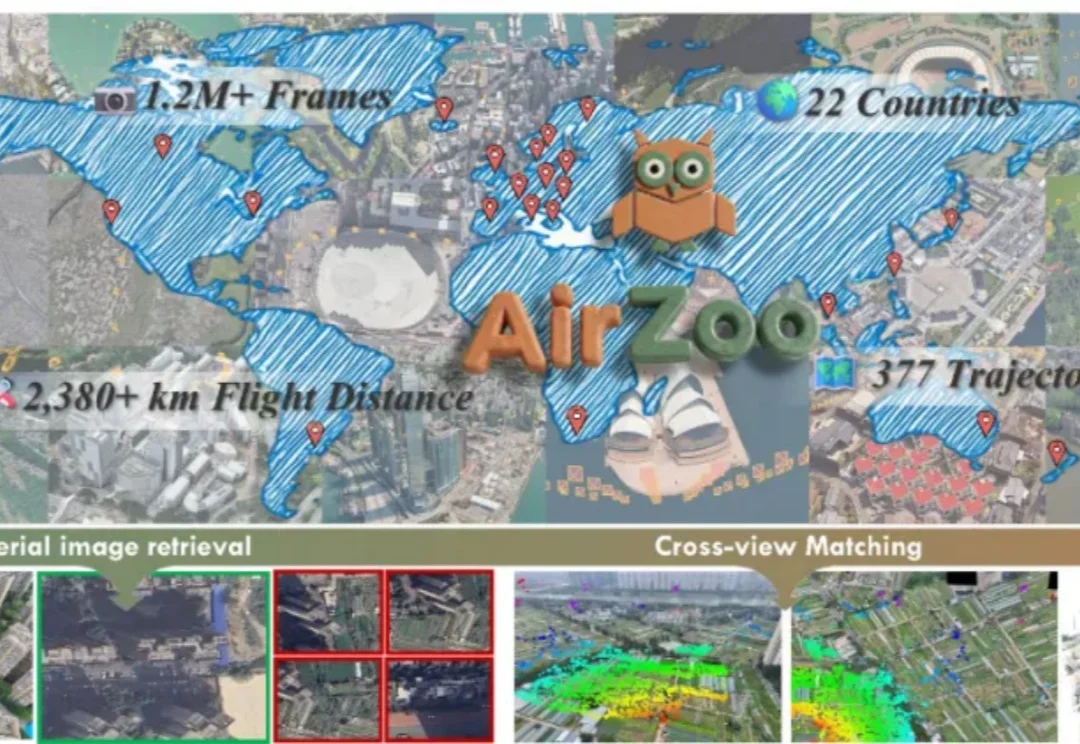
国防科技大学虚拟现实与视觉计算团队(SAW Lab)联合先进制导与控制技术国家级重点实验室等推出面向航拍几何 3D 视觉的统一大规模数据集与评测基准 「AirZoo」。
一个月前的CVPR现场,一家中国具身智能公司的展台被围得水泄不通。
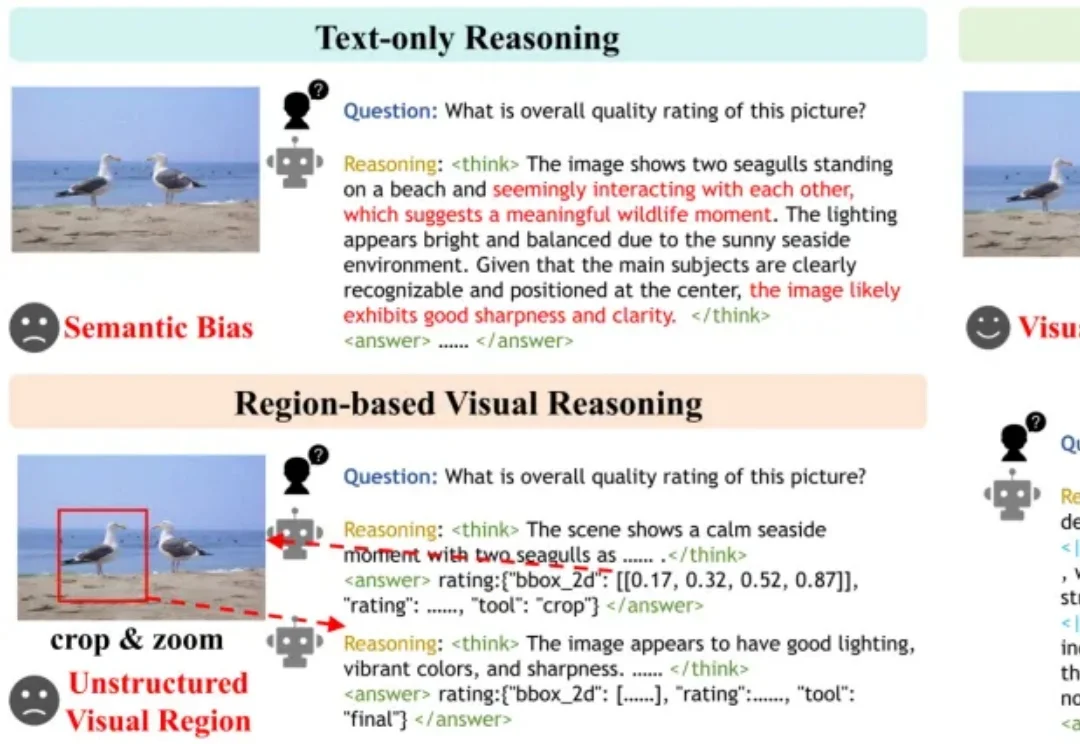
让大模型给一张图片打“质量分”,它其实经常看走眼。
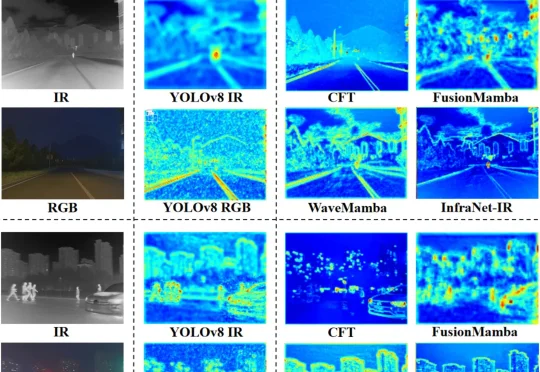
在讨论 RGB-IR 目标检测时,「两种模态互补」几乎是默认前提。RGB 擅长保留纹理和颜色,红外图像在弱光条件下更稳定,于是最直接的路线是搭建双分支网络,让它们在中间层不断交换信息。InfraNet 的出发点却来自一个不太符合这一直觉的现象。
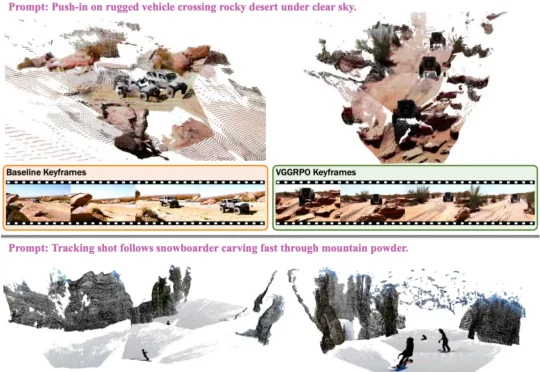
最近,来自 Google、哥本哈根大学、牛津大学等机构的研究者提出了 VGGRPO(Visual Geometry GRPO,收录于 ECCV 2026)。这项工作聚焦于一个核心问题:如何在不牺牲预训练模型泛化能力的前提下,高效地提升视频生成的几何一致性,并使其适用于动态场景。其核心思路是,在隐空间(latent space)中利用 4D 几何奖励,进行几何感知的视频后训练。
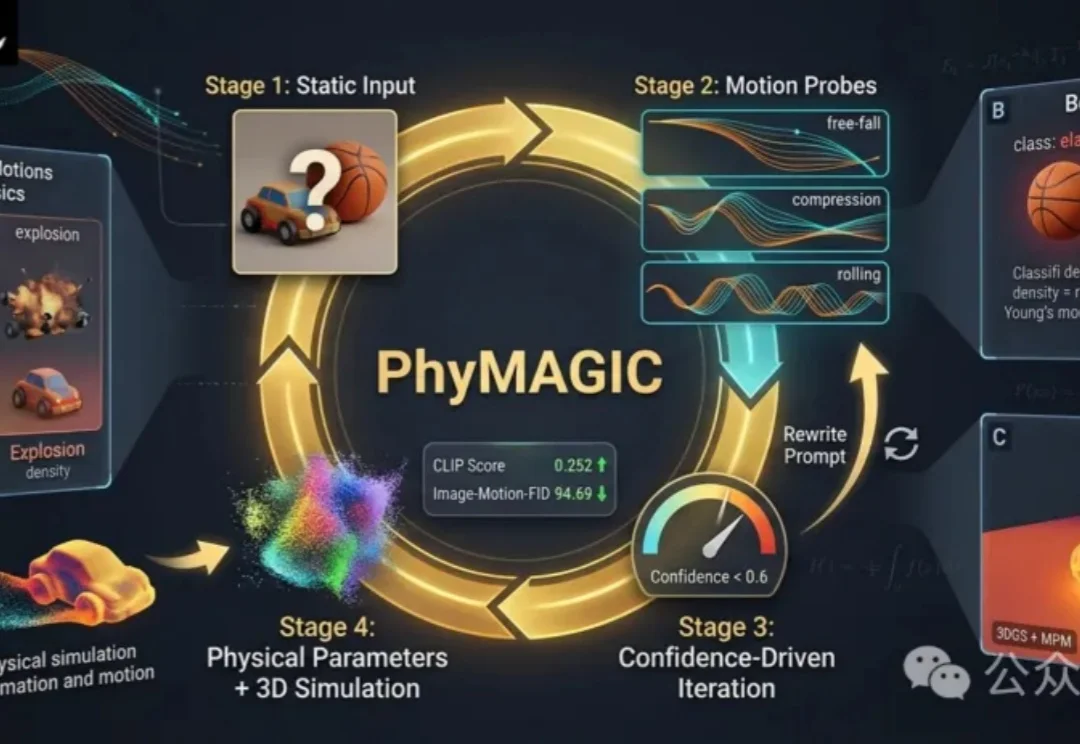
PhyMAGIC通过让物体动起来,从视频中提取物理证据,帮助准确推断材料属性。它结合图生视频与视觉语言模型,生成针对性运动探针,并不断修正物理参数,最终构建出可微分的3D动态模型,实现更符合现实的视频生成。
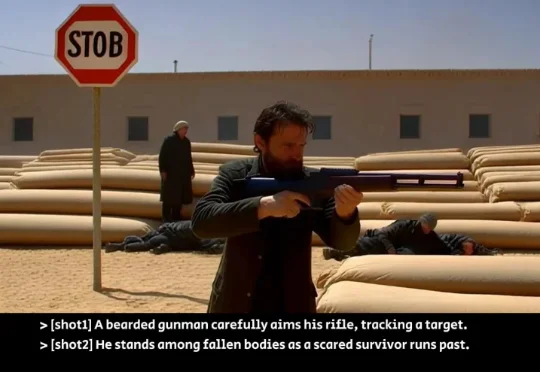
为了打破多镜头长视频面临的高延迟、零交互困境,香港中文大学与快手可灵团队联合提出了首个实时流式多镜头长视频生成框架 ——ShotStream。该研究打破了传统双向架构的限制,将多镜头合成定义为基于历史上下文的下一镜头生成任务,用户可以通过动态流式提示词在运行时动态指导叙事走向!更令人振奋的是
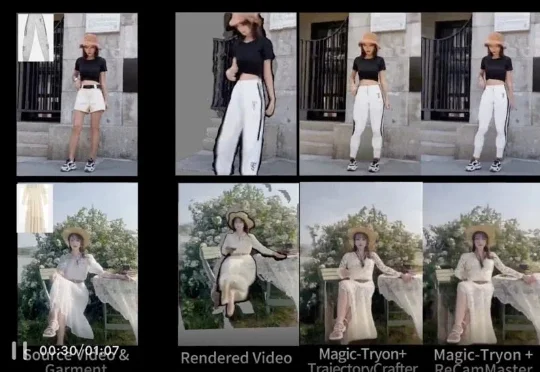
视频虚拟试衣(VVT)作为电商展示与数字内容创作中的核心技术,已在动态人物换装、服装纹理保持和视频时序连贯性方面取得显著进展。然而,现有方法大多仍受限于固定相机视角,生成结果被动依赖源视频的原始相机轨
近期, ECCV 2026 结果公布,Realsee 团队的成果 Argus: Metric Panoramic 3D Reconstruction for Indoor Scenes 成功入选。它面向室内全景图像,能够从稀疏、无序的全景照片中,直接预测相机位姿、度量深度和点云重建结果,可以为 3DGS 提供更稳定、更精准的几何约束。