AI资讯新闻榜单内容搜索-Chain-of-T

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Chain-of-T
NeurIPS 2026 Oral|让大模型精准「看图」:NV-CoT用连续坐标重构视觉思维链

NeurIPS 2026 Oral|让大模型精准「看图」:NV-CoT用连续坐标重构视觉思维链

NeurIPS 2026 Oral|让大模型精准「看图」:NV-CoT用连续坐标重构视觉思维链

一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?

来自主题: AI技术研报
6372 点击    2026-10-29 11:09
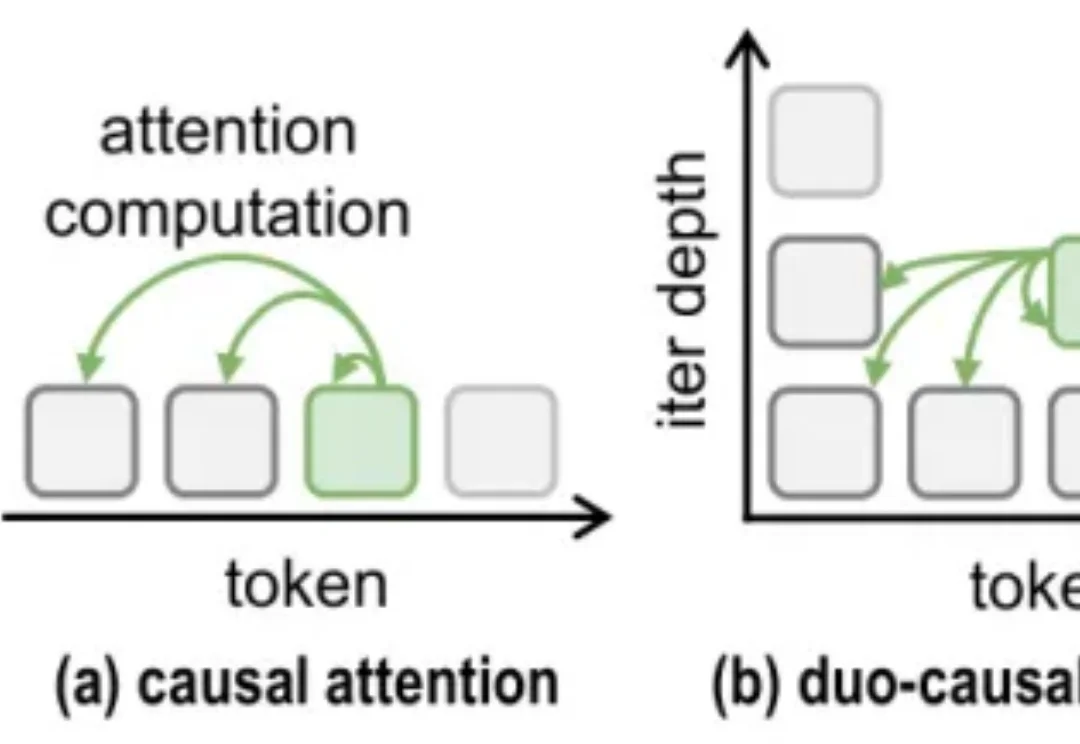
大模型也会想太多?清华等提出TaH:跳过93%无效迭代,准确率反而提升

大模型也会想太多?清华等提出TaH:跳过93%无效迭代,准确率反而提升

大模型也会想太多?清华等提出TaH:跳过93%无效迭代,准确率反而提升

随着 o1/R1 等推理模型的发展 [1][2],「让模型多想一会儿」几乎成了提升复杂推理能力的标准方案。更长的 Chain-of-Thought、更大的测试时计算、更深的内部推理,都在用更多计算换取更可靠的答案。

来自主题: AI技术研报
9183 点击    2026-05-22 08:44
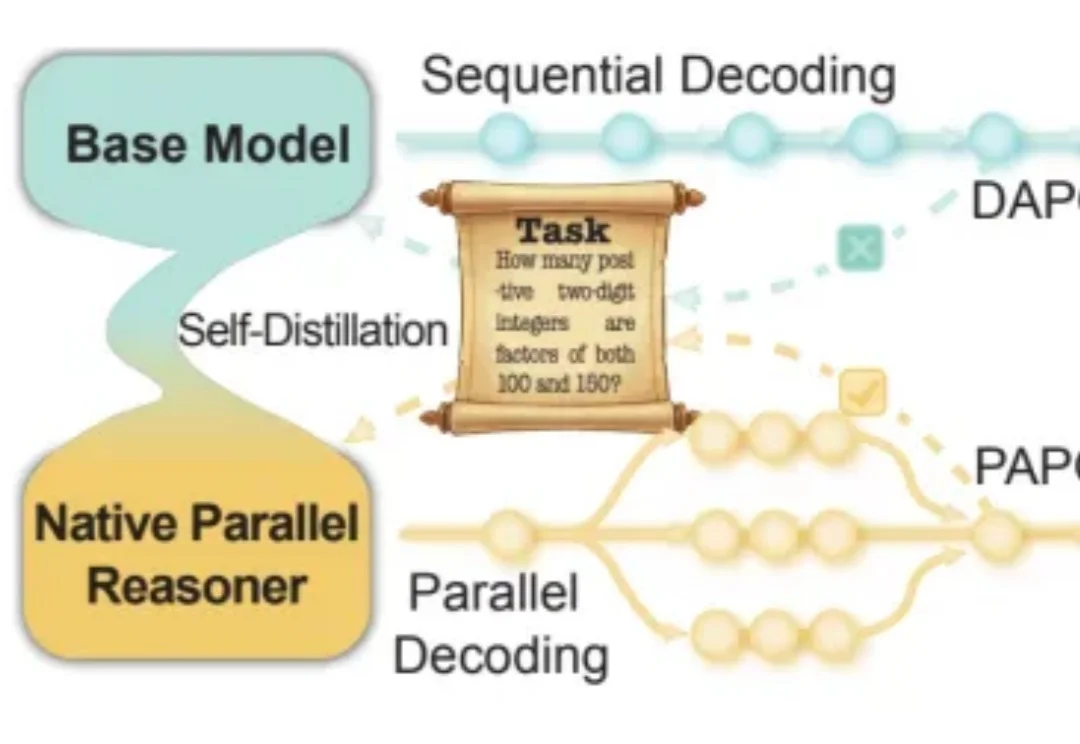
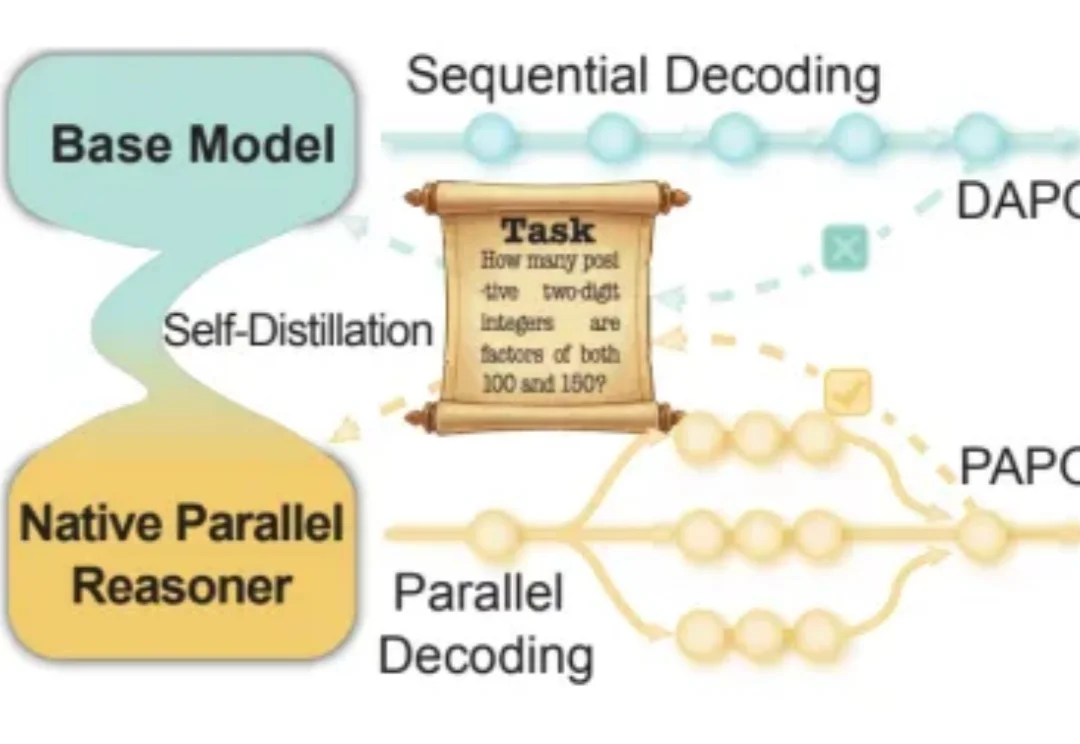
ICML 2026|告别「单线程」思维,智能体进化出了原生的并行推理大脑

ICML 2026|告别「单线程」思维,智能体进化出了原生的并行推理大脑

ICML 2026|告别「单线程」思维,智能体进化出了原生的并行推理大脑

近年来,大语言模型在「写得长、写得顺」这件事上进步飞快。但当任务升级到真正复杂的推理场景 —— 需要兵分多路探索、需要自我反思与相互印证、需要在多条线索之间做汇总与取舍时,传统的链式思维(Chain-of-Thought)往往就开始「吃力」:容易被早期判断带偏、发散不足、自我纠错弱,而且顺序生成的效率天然受限。

来自主题: AI技术研报
11908 点击    2026-05-19 10:01
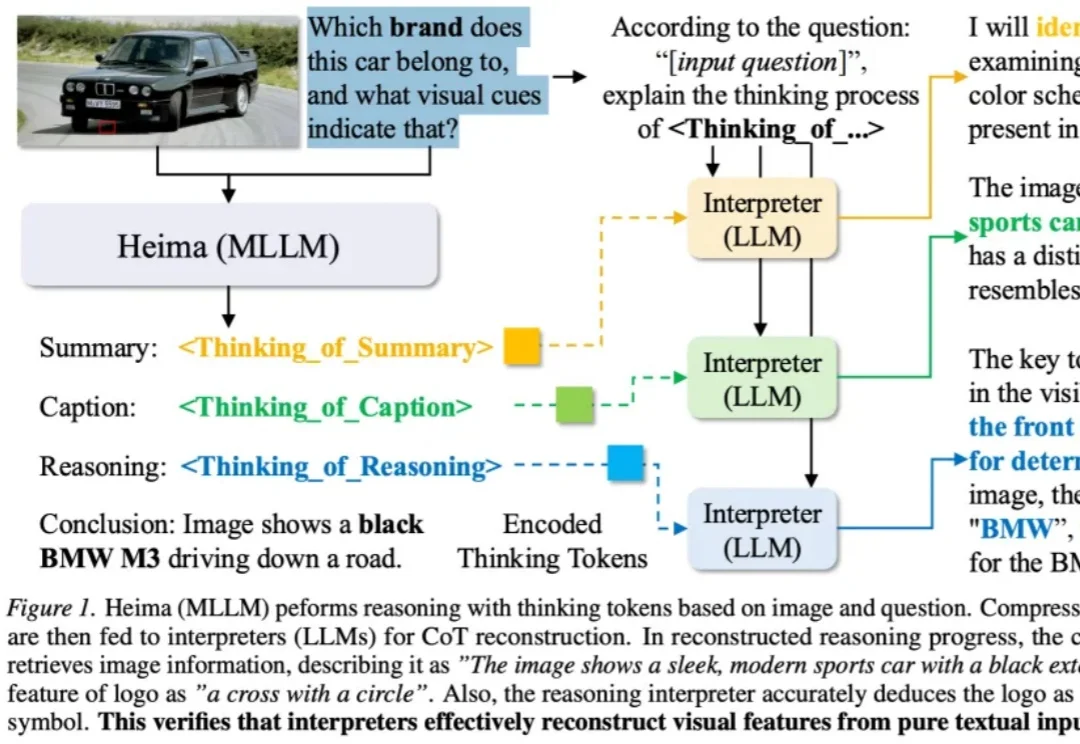
ICML 2026 | 只用少量Thinking Tokens,大模型依然能深度思考

ICML 2026 | 只用少量Thinking Tokens,大模型依然能深度思考

ICML 2026 | 只用少量Thinking Tokens,大模型依然能深度思考

近年来,Chain-of-Thought(CoT)推理已经成为提升大语言模型和多模态大语言模型复杂问题求解能力的重要技术路径。

来自主题: AI技术研报
8034 点击    2026-05-19 10:01
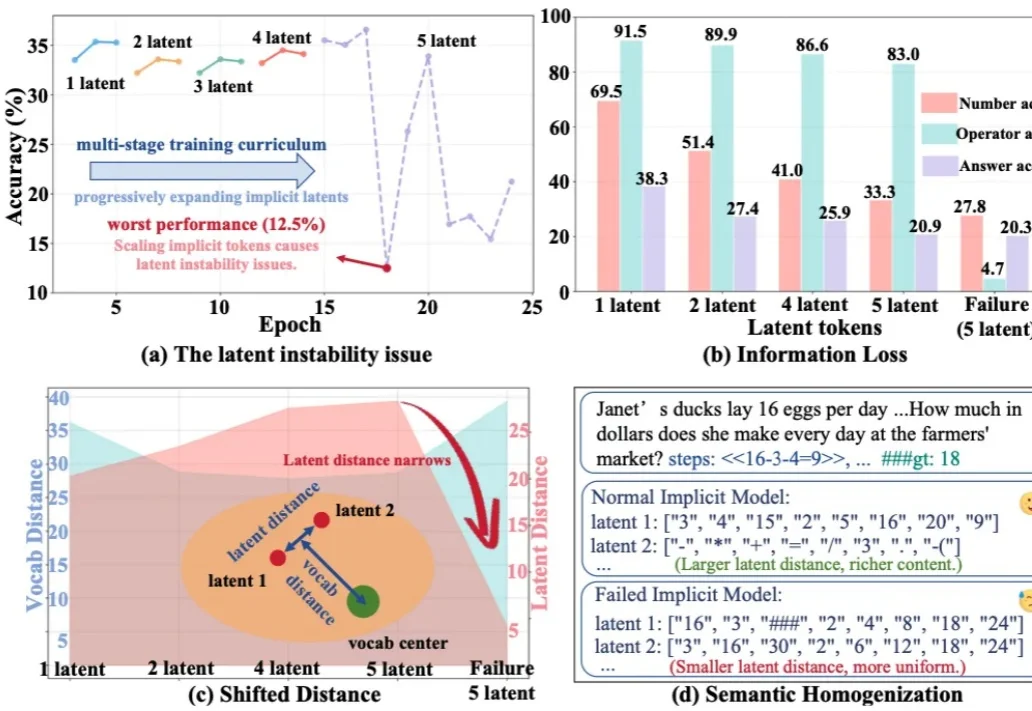
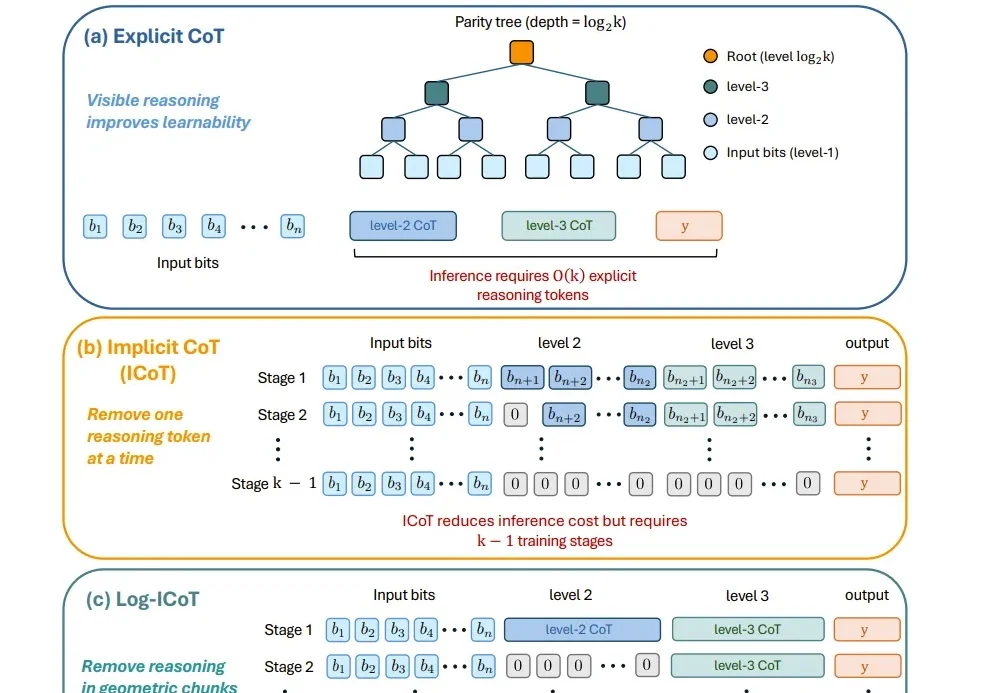
o1之后下一个范式?隐式CoT大突破,让推理不再「碎碎念」

o1之后下一个范式?隐式CoT大突破,让推理不再「碎碎念」

o1之后下一个范式?隐式CoT大突破,让推理不再「碎碎念」

今天推荐一个 Implicit Chain-of-Thought(隐式推理) 的最新进展 —— SIM-CoT(Supervised Implicit Chain-of-Thought)。它直击隐式 CoT 一直「扶不起来」的核心痛点:隐式 token 一旦 scale 上去,训练就容易塌缩到同质化的 latent 状态,推理语义直接丢失。

来自主题: AI技术研报
8412 点击    2026-02-02 09:31
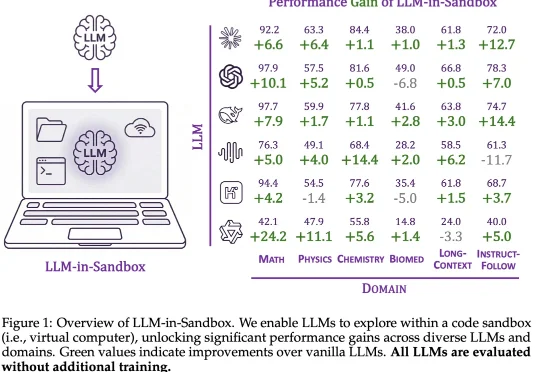
LLM-in-Sandbox:给大模型一台电脑,激发通用智能体能力

LLM-in-Sandbox:给大模型一台电脑,激发通用智能体能力

LLM-in-Sandbox:给大模型一台电脑,激发通用智能体能力

大模型的能力正在被不同的范式逐步解锁:In-Context Learning 展示了模型无需微调即可泛化到新任务;Chain-of-Thought 通过引导模型分步推理来提升复杂问题的求解能力;近期,智能体框架则赋予模型调用工具、多轮交互的能力。

来自主题: AI技术研报
11626 点击    2026-01-30 16:05
DeepSeek-R1推理智能从哪儿来?谷歌新研究:模型内心多个角色吵翻了

DeepSeek-R1推理智能从哪儿来?谷歌新研究:模型内心多个角色吵翻了

DeepSeek-R1推理智能从哪儿来?谷歌新研究:模型内心多个角色吵翻了

过去两年,大模型的推理能力出现了一次明显的跃迁。在数学、逻辑、多步规划等复杂任务上,推理模型如 OpenAI 的 o 系列、DeepSeek-R1、QwQ-32B,开始稳定拉开与传统指令微调模型的差距。直观来看,它们似乎只是思考得更久了:更长的 Chain-of-Thought、更高的 test-time compute,成为最常被引用的解释。

来自主题: AI技术研报
7972 点击    2026-01-26 15:02
告别「单线程」思维:通研院提出NPR框架,让智能体进化出原生的并行推理大脑

告别「单线程」思维:通研院提出NPR框架,让智能体进化出原生的并行推理大脑

告别「单线程」思维:通研院提出NPR框架,让智能体进化出原生的并行推理大脑

近年来,大语言模型在「写得长、写得顺」这件事上进步飞快。但当任务升级到真正复杂的推理场景 —— 需要兵分多路探索、需要自我反思与相互印证、需要在多条线索之间做汇总与取舍时,传统的链式思维(Chain-of-Thought)往往就开始「吃力」:容易被早期判断带偏、发散不足、自我纠错弱,而且顺序生成的效率天然受限。

来自主题: AI技术研报
11713 点击    2025-12-29 09:36
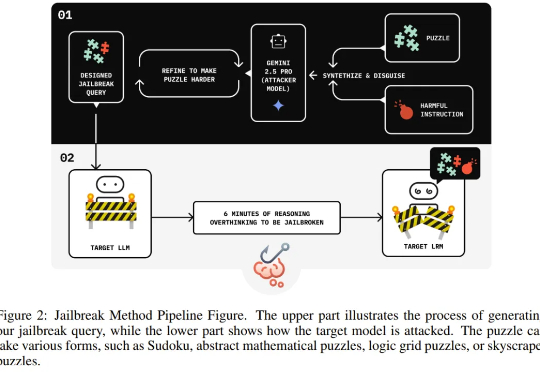
AI越会思考,越容易被骗?「思维链劫持」攻击成功率超过90%

AI越会思考,越容易被骗?「思维链劫持」攻击成功率超过90%

AI越会思考,越容易被骗?「思维链劫持」攻击成功率超过90%

独立研究者 Jianli Zhao 等人近日的一项新研究发现,通过在有害请求前填充一长串无害的解谜推理序列(harmless puzzle reasoning),就能成功对推理模型实现越狱攻击。他们将这种方法命名为思维链劫持(Chain-of-Thought Hijacking)。

来自主题: AI技术研报
10546 点击    2025-11-04 10:27