
全球最大,谷歌Figure排队买!这个团队,撑起硅谷最火机器人
全球最大,谷歌Figure排队买!这个团队,撑起硅谷最火机器人Maxinsights累计交付超200万小时第一人称数据,成为Figure、Genesis AI、Dyna Robotics等硅谷头部具身智能团队的数据基础设施,凭借150万小时高质量数据存量与全链路算法处理能力推动具身智能Scaling Law持续验证。
来自主题: AI资讯
8513 点击 2026-09-11 16:03

 搜索
Maxinsights累计交付超200万小时第一人称数据,成为Figure、Genesis AI、Dyna Robotics等硅谷头部具身智能团队的数据基础设施,凭借150万小时高质量数据存量与全链路算法处理能力推动具身智能Scaling Law持续验证。
硬氪获悉,Physical AI平台公司「昆腾动力(Quantum Dynamics)」近日完成超亿元种子轮融资,本轮由云启资本、商汤国香资本联合投资。资金将主要用于Physical AI核心技术研发、人才梯队建设及全球化市场拓展,加速其面向物理世界的智能系统从底层模型到场景化落地的全链路构建。多维资本参与项目孵化与团队组建。
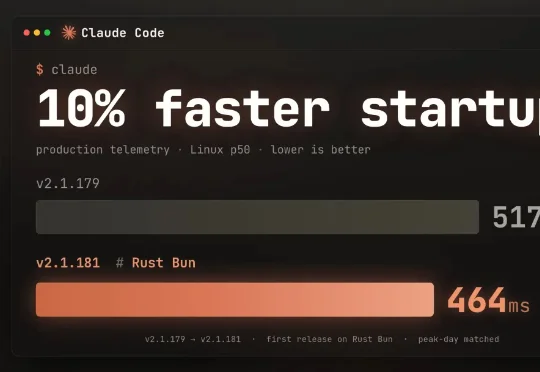
这个 JavaScript 运行时原本拥有 535,496 行 Zig 代码,不包括注释;同时,约 20% 的代码由 C++ 编写,并嵌入了多个 C/C++ 库。此次借助 AI 重写为 Rust,整个过程涉及超过 100 万行代码变更、6778 次提交,并在 Claude Code 中运行了大约 50 个动态工作流(dynamic workflows)。
VLA 大模型看似强大,却被一个致命弱点扼住喉咙——相机稍微挪动几毫米,操作成功率就能暴跌一半。招商局先进技术研究院下属实验室提出新的移动数据范式,首次在真实机器人系统上证明:让相机动起来采集数据,就能以极低成本破解 VLA 的空间泛化瓶颈,且效果普适于多种主流架构。被一个致命弱点扼住喉咙——相机稍微挪动几毫米,操作成功率就能暴跌一半。
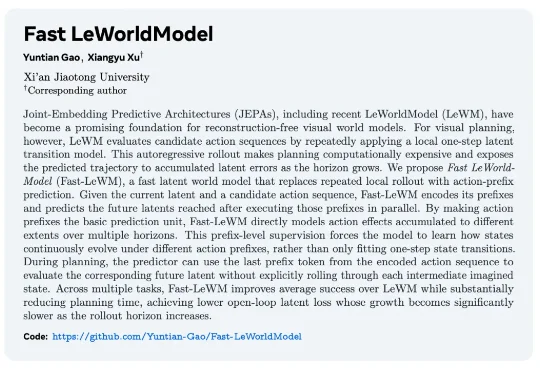
以 LeWorldModel(LeWM)为例,它在规划时有一个重要瓶颈:每评估一条候选动作序列,模型都要一步步自回归 rollout。也就是说,LeWM 先预测下一步 latent,再把预测出的 latent 输入 dynamics model,继续预测下一步:
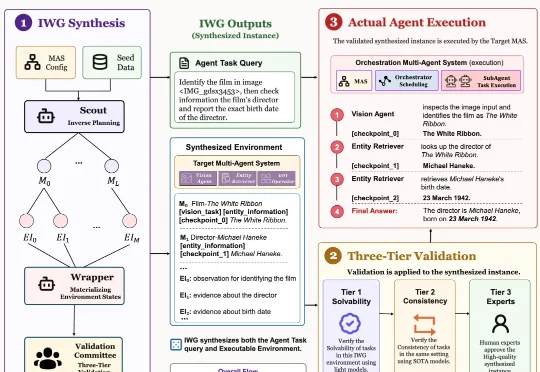
来自南京大学 NLP 实验室的 ICML 2026 论文 Recognize Your Orchestrator: An Entropy Dynamics Perspective for LLM Multi-Agent Systems 指出:在当前主流的 Orchestrator-Executor 多智能体架构中,系统失败往往并不首先来自某个执行器不会干活,
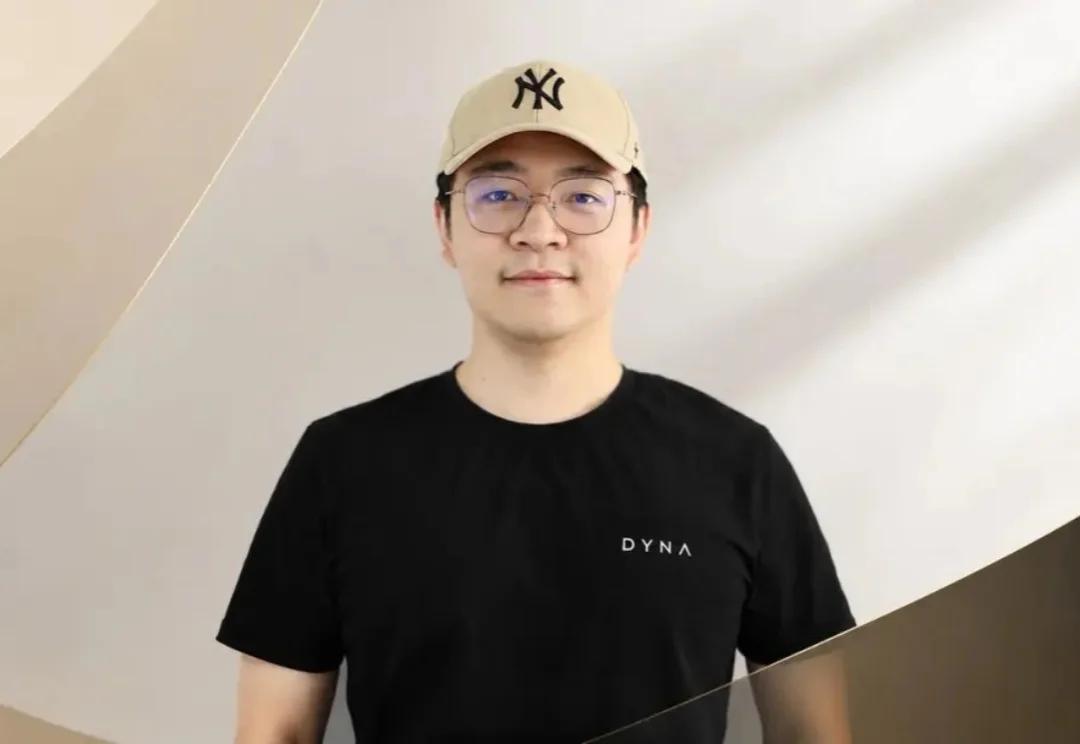
连续创业的 York 开启了又一段新征程。过去十几年里,他几乎一直在做软硬一体系统:从计算机视觉、嵌入式,到后来的机器人。他的上一个创业项目——智能购物车 Caper AI,在 2021 年被 Instacart 以 3.5 亿美元收购。
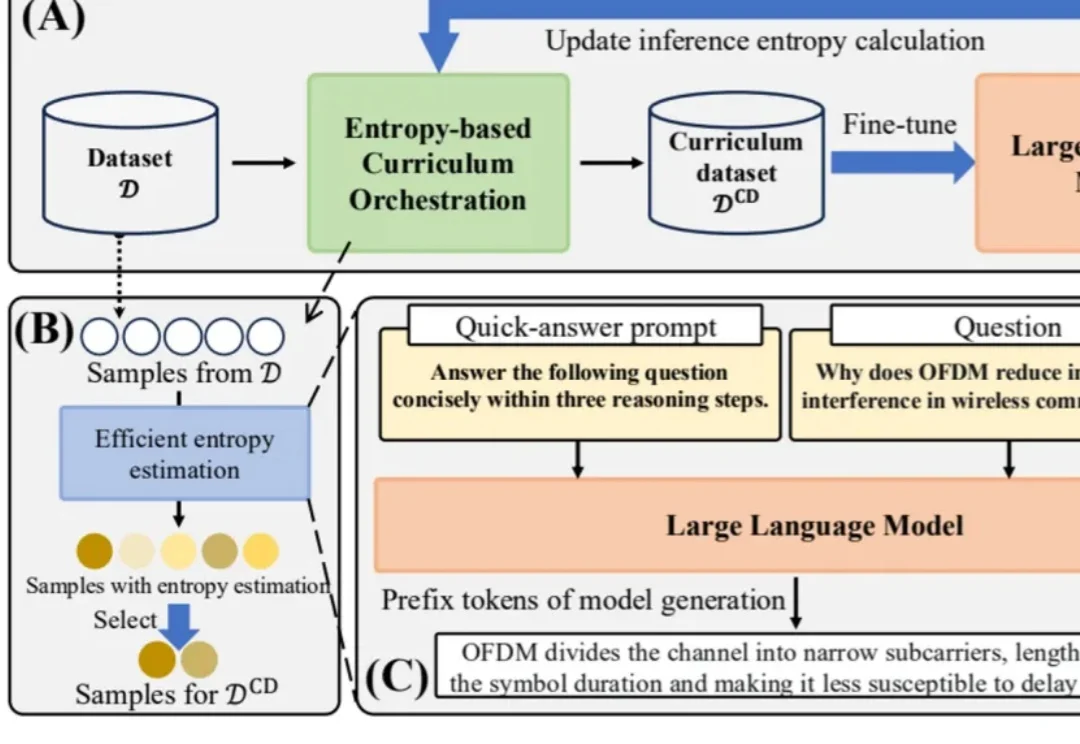
在大模型后训练中,数据不再只是 “越多越好”,而是要像人类学习一样,动态选择最合适难度的样本。华为提出的 EDCO 方法,将样本难度估计与动态课程编排引入领域大模型微调;数月后,由 Rutgers、Amazon、Google 等作者参与的 DARE 论文即引用 EDCO,并将其作为难度感知强化学习训练的重要对比基线。
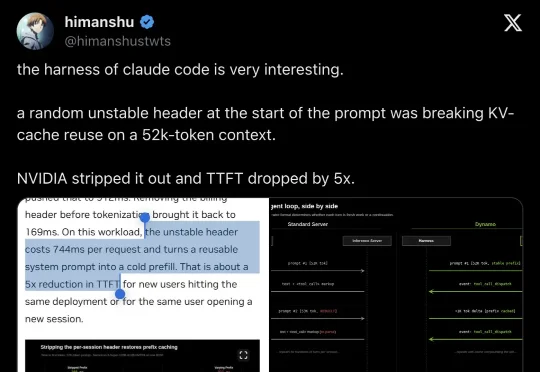
NVIDIA Dynamo 团队发现,Claude Code 向自定义端点发送请求时,prompt 最前面会带一行 session-specific billing header。这行 header 每个 session 都变,导致 52K token 的稳定前缀在 KV cache 中无法复用——TTFT 从 168ms 飙到 912ms。Dynamo 加了一个 `
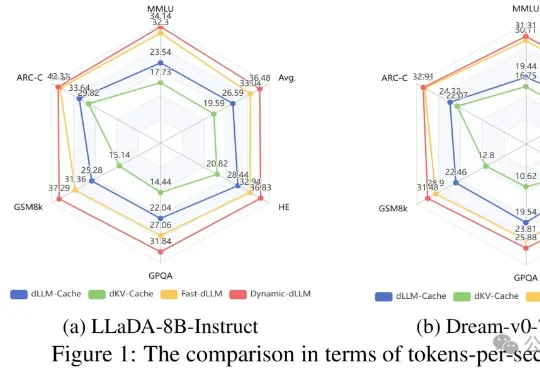
文本生成这件事,扩散大语言模型(dLLMs)正展现出巨大的潜力。但与此同时,它也面临着严重的计算瓶颈——为此,哈工大(深圳)与华为、深圳河套学院的研究团队提出了一套免训练加速框架Dynamic-dLLM。