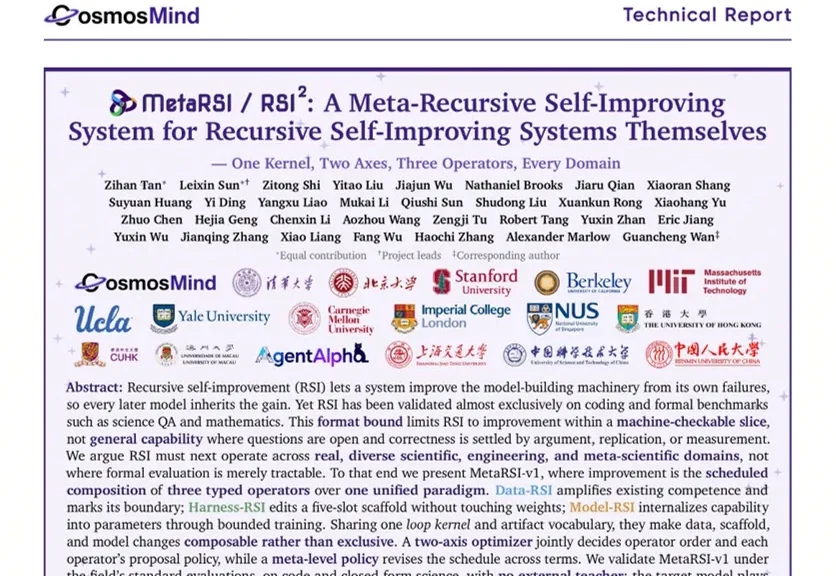
AI开始改进“改进自己的方法”,RSI进入平方时代丨MetaRSI
AI开始改进“改进自己的方法”,RSI进入平方时代丨MetaRSI让模型自己生成训练数据、自己改写提示词、自己修复代码,这条路线被称为: 递归自我改进(Recursive Self-Improvement,RSI)。
来自主题: AI技术研报
9975 点击 2026-09-14 15:30

 搜索
让模型自己生成训练数据、自己改写提示词、自己修复代码,这条路线被称为: 递归自我改进(Recursive Self-Improvement,RSI)。

第一篇AI4AI综述论文将long horizon智能体、AI4AI与recursive self-improvement纳入同一研究地图,指出AI能在明确目标与评价规则下承担部分研发工作,但单项能力提升无法证明完整流程可靠,持续自我改进仍面临组合鸿沟等验证挑战。
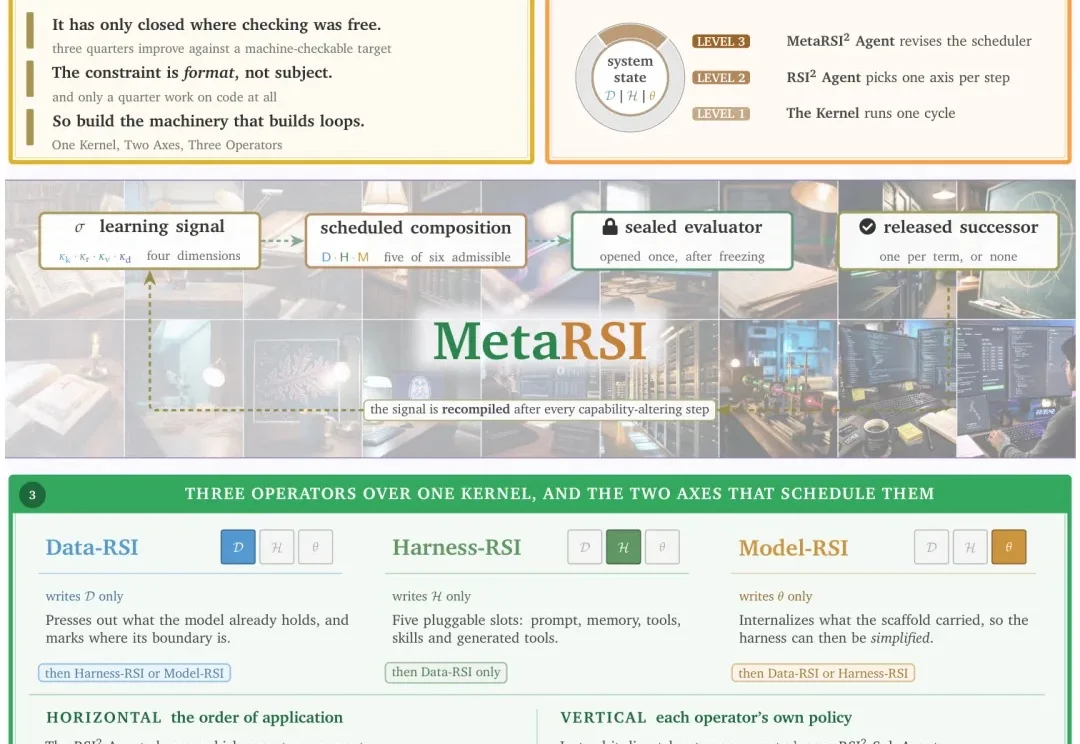
过去两年,AI 领域最激动人心的叙事之一,是让模型自己改进自己:自己生成训练数据、自己改写提示词、自己修复自己的代码。这条路线叫递归自我改进(Recursive Self-Improvement,RSI)。
2026年,Recursive Self-Improvement(RSI,递归式自我改进)开始从论文中的长期命题,变成了AI产业议程上一个新的赛道。学术界开始把RSI从分散研究方向变成一个独立议题。4月,ICLR首次为Recursive Self-Improvement(RSI,递归式自我改进)单独办了一场Workshop。
RSI(Recursive Self-Improvement,递归自我改进)正在成为人工智能领域最受瞩目的前沿方向。
RSI(Recursive Self-Improvement,递归自我改进)是今年 AI 创业里最密集的一个方向。如果说RSI 最严格的定义,只有一句话:AI 改进“制造下一代 AI”的方法,下一代继承了这个改进,于是能做出更好的下下代。

AI竞争的焦点,变了。

过去两年,self-reflection、self-correction、self-play、agentic RL、skill learning、test-time adaptation、open-ended evolution、self-evolving agent等概念不断涌现。

由上海交大人工智能学院、深势科技、上海算法创新研究院组成的无尽前沿团队发布BigBang-V1——这是首个基于recursive self-improving原生方式训练出的基座模型。

近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。