vLLM-Omni 上的 MiniMax H3:从系统级优化到基于 FastVideo FastH3 的实时服务
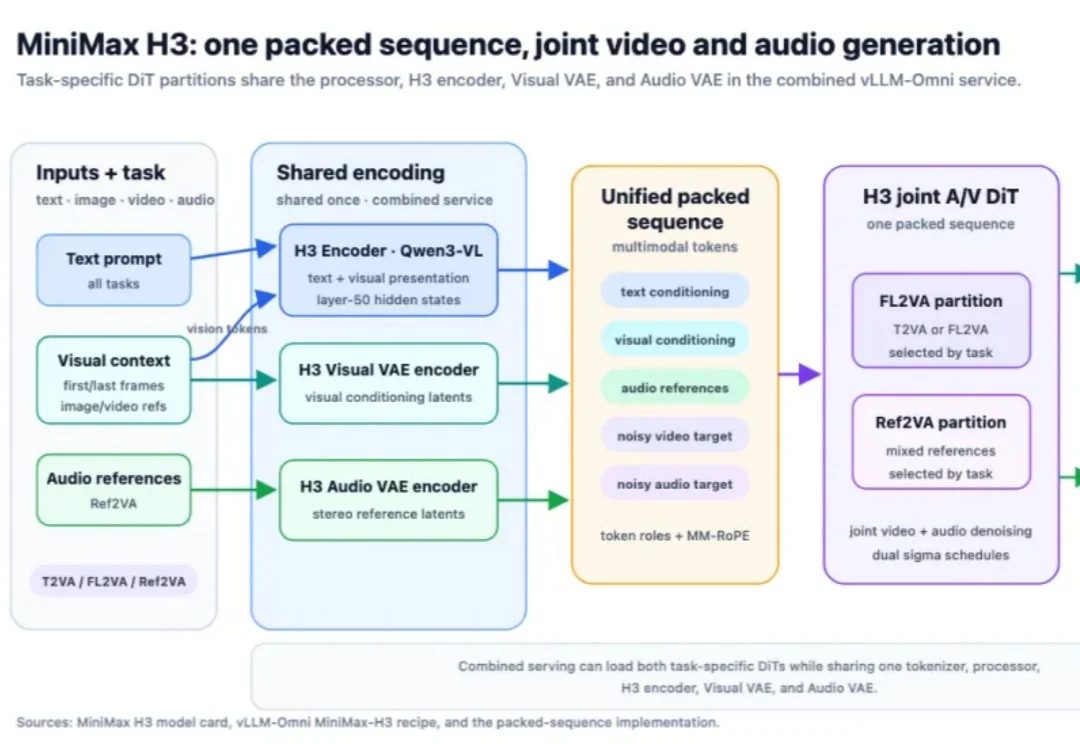
vLLM-Omni 上的 MiniMax H3:从系统级优化到基于 FastVideo FastH3 的实时服务MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
搜索
MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
OpenAI宣布旗下史上最快模型GPT-5.3-Codex-Spark仅存活7个月后将于下周退役,因其"以智能换速度"的设计在Cerebras晶圆上跑通旗舰模型GPT-5.6 Sol的Ultrafast模式后已失去存在意义。
一周之内大语言、图片、视频模型都迎来新赛季:OpenAI的GPT-6 Astra让编码 Agent更好地使用游戏引擎和Blender,自己改场景、自己跑、自己测;GPT-image-2.5上线,更快更强,图片编辑和关键帧动画显著提升;fal和Yoroll分别发布 H3 MaxTurbo和H3 Superfast后训练加速模型,5秒视频3秒内推理,实时生成和互动玩法纷纷涌现。
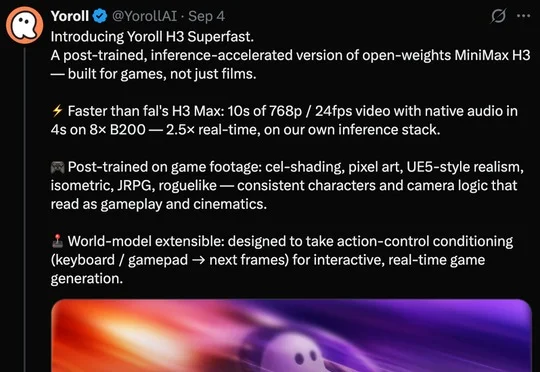
AI视频生成正从质量竞争转向实时速度竞争,AI互动内容公司Yoroll基于开源MiniMax H3模型推出后训练模型Yoroll H3 Superfast,可在4秒内生成10秒768p带音频视频,并上线由其驱动的实时互动叙事产品YoLive。
8 月 14 日凌晨,OpenAI 联合 AI 芯片厂商 Cerebras 正式预览了其旗舰模型 GPT-5.6 Sol 的全新服务层级「超高速模式」(Ultrafast Mode)。在该模式下,GPT-5.6 Sol 的输出速度最高可达 750 tokens/s,相比目前 Standard(标准)模式约 53 tokens/s 的推理基线,速度提升最高达 14 倍,同时不降低任何质量。
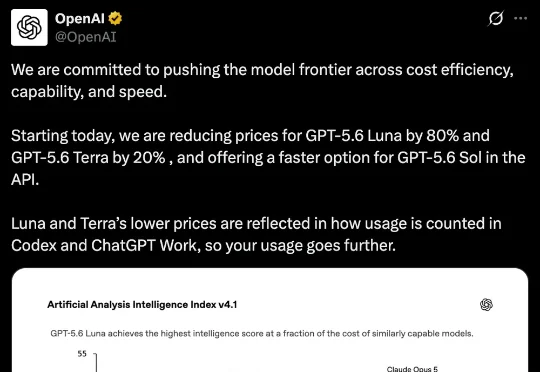
今日,OpenAI宣布下调GPT-5.6系列模型API价格。其中,GPT-5.6 Luna价格下调80%,GPT-5.6 Terra价格下调20%,GPT-5.6 Sol则新增Fast模式,在保持模型能力不变的情况下,最高可实现2.5倍推理速度。
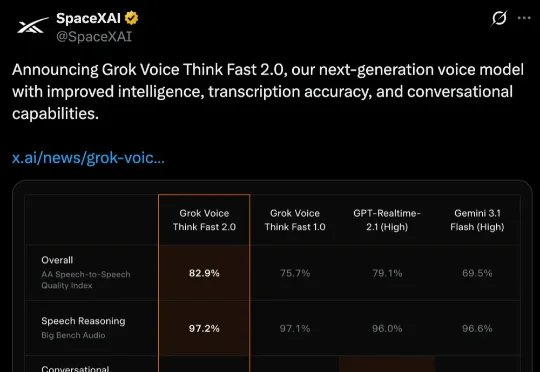
今日,马斯克旗下SpaceXAI宣布推出新一代语音模型Grok Voice Think Fast 2.0,这是该公司迄今能力最强的语音到语音(speech-to-speech)模型。马斯克连发两条推文,第一条宣布“Grok Voice现在在智能体性能方面排名第一”,第二条则直接喊话网友“试试新的Grok Voice”。
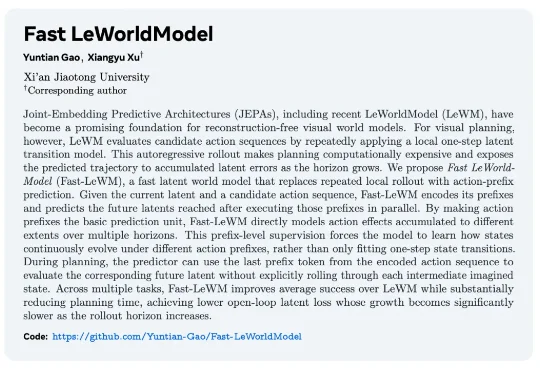
以 LeWorldModel(LeWM)为例,它在规划时有一个重要瓶颈:每评估一条候选动作序列,模型都要一步步自回归 rollout。也就是说,LeWM 先预测下一步 latent,再把预测出的 latent 输入 dynamics model,继续预测下一步:
做了一年 Agent 基础设施,踩了无数坑,我终于想明白了一件事:好的 Agent 架构不是把所有功能塞进一个进程,而是让每一层都能独立演化。
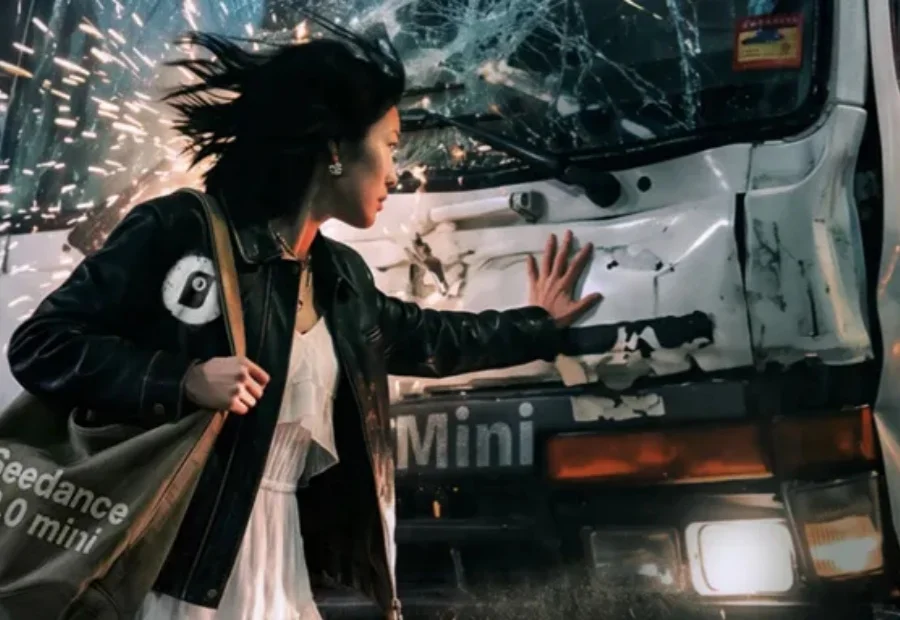
昨晚,字节新模型Seedance 2.0 Mini深夜来袭,该模型主打性价比,侧重于提供更低的价格以及更快的生成速度。Seedance 2.0 Mini虽然定价更低,但保留了核心能力参考生成,用户可以通过融合提示词与最多12个多种模态的参考素材(包括6张图片、3段音频、3段视频)来锁定人物一致性、精细化控制运动轨迹、卡准剧情节奏。