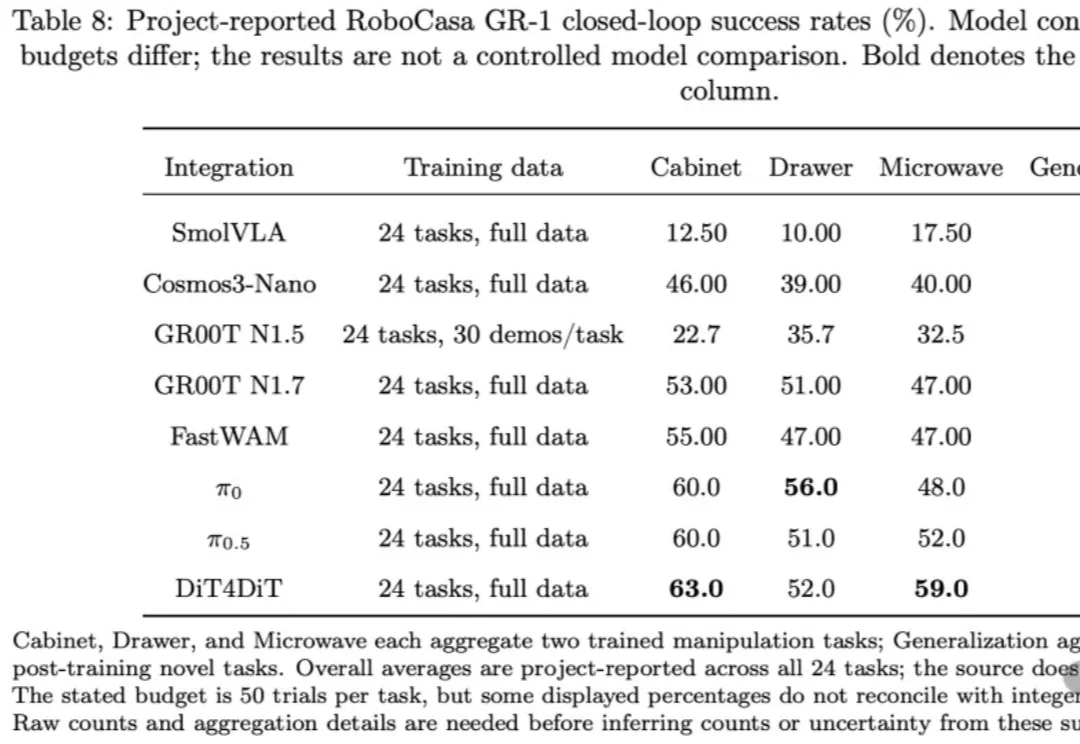
工程能力一键复用,专心卷新能力!轮子造一次就够了|详解FluxVLA Engine技术报告
工程能力一键复用,专心卷新能力!轮子造一次就够了|详解FluxVLA Engine技术报告什么时候是具身智能的ChatGPT时刻?
来自主题: AI技术研报
7124 点击 2026-10-29 11:48

 搜索
什么时候是具身智能的ChatGPT时刻?
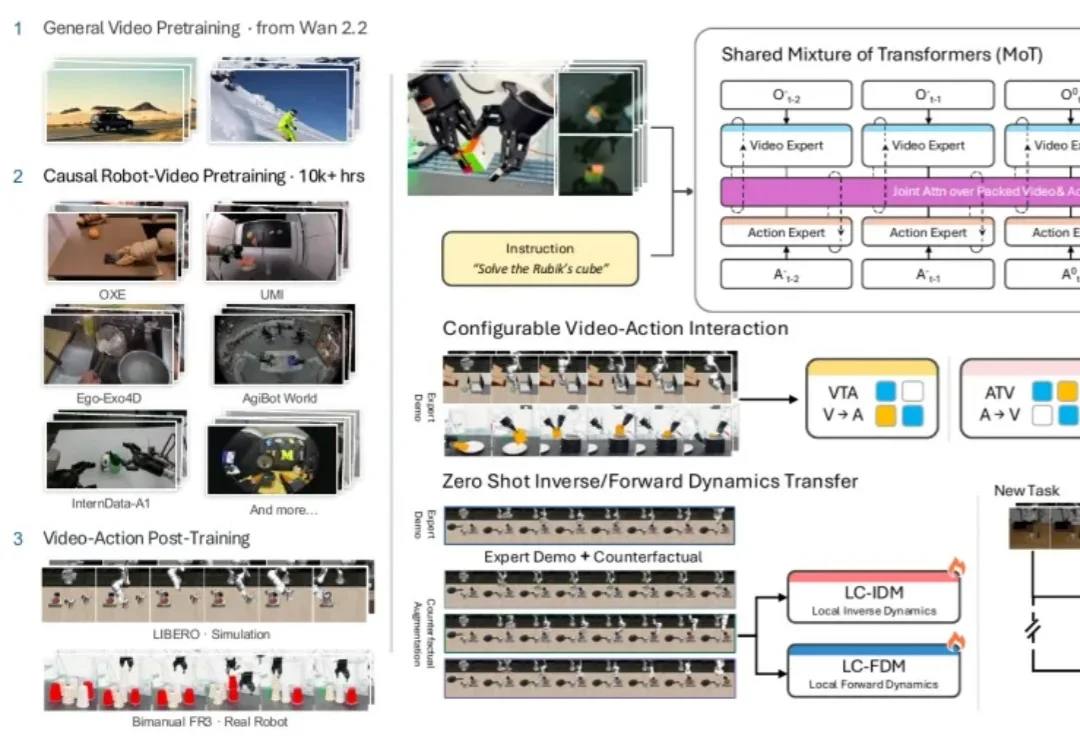
9 月 22 日,以 FLUX 图像模型闻名的 Black Forest Labs 跨界发布了开源 7B 世界动作模型 FLUX 3 Action。据其官方博客,该模型在英伟达 RoboLab-120 榜单上超过了此前最强的开源模型 Cosmos 3 Nano,参数量却不到后者一半。一家做图像生成的公司跑来卷机器人控制,说明视频模型里积累的「物理直觉」正被越来越多的团队当作机器人大脑的底座。
Bun 1.4正式发布,核心开发者Jarred Sumner利用AI Agent在11天内将底层代码从Zig重写为Rust,生成超100万行代码并烧掉约16.5万美元Token,InfluxDB创始人Paul Dix发文《The end of programming》指出传统编程方式正走向消亡。
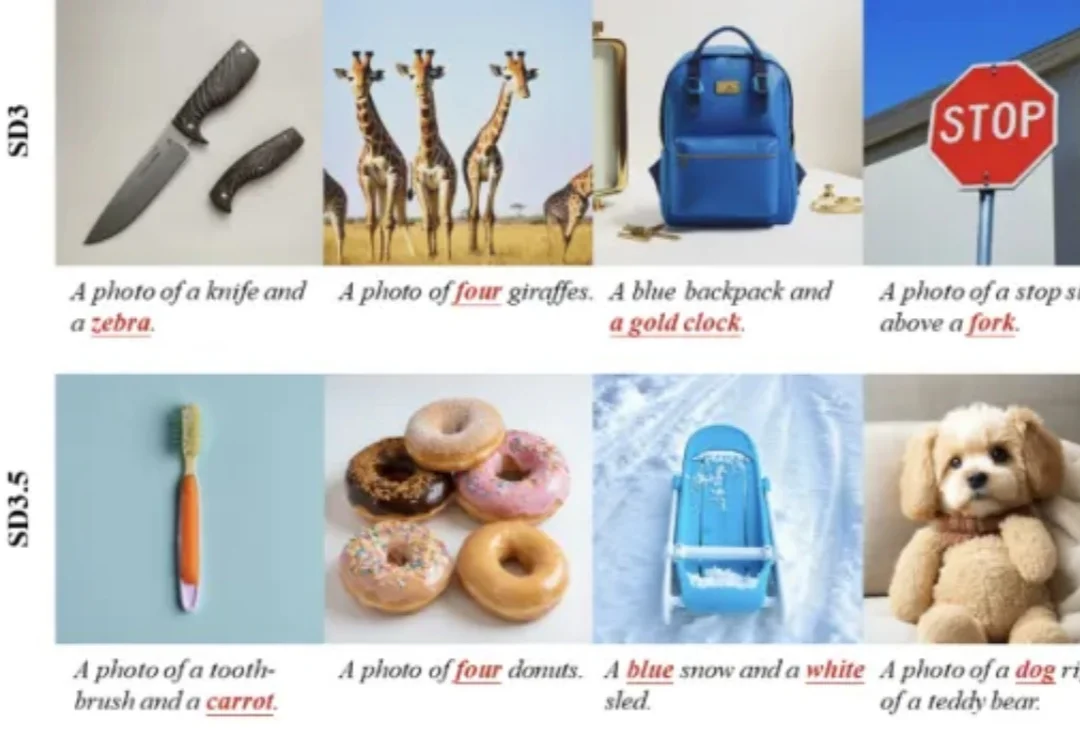
近年来,文生图模型的能力快速提升。从 Stable Diffusion 到 FLUX、Qwen-Image,扩散模型已经能够生成高质量图像,也能处理越来越复杂的文本提示。
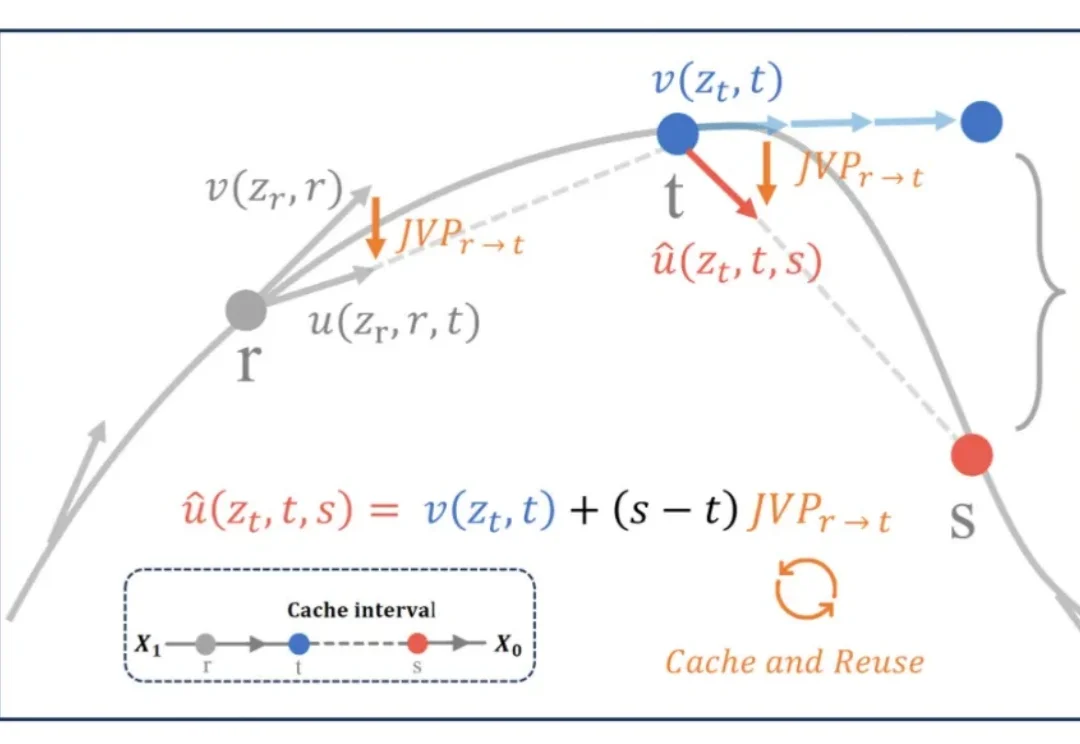
FLUX 、Qwen-Image 等多模态生成模型的推理速度一直是工业级多模态模型落地的痛点。传统的特征缓存(Feature Caching)方案在追求高倍率加速时,常因瞬时速度的剧烈波动导致轨迹漂移。
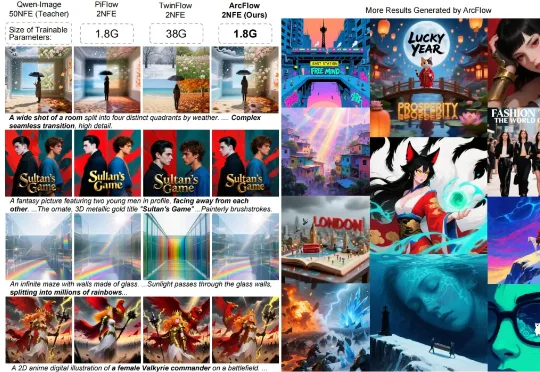
复旦大学与微软亚洲研究院带来的 ArcFlow 给出了答案:如果路是弯的,那就学会 “漂移”,而不是把路修直。在扩散模型中,教师模型(Pre-trained Teacher)的生成过程本质上是在高维空间中求解微分方程并进行多步积分。由于图像流形的复杂性,教师模型原本的采样轨迹通常是一条蜿蜒的曲线,其切线方向(即速度场)随时间步不断变化。
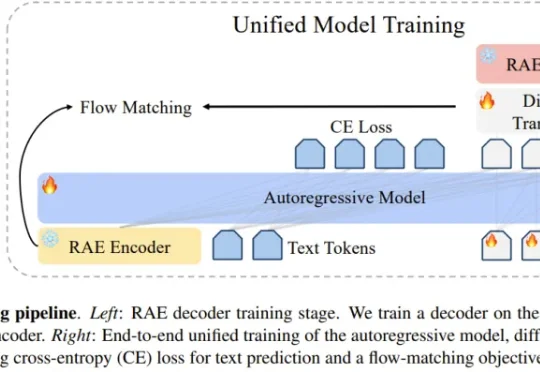
编辑|Panda 在文生图模型的技术版图中,VAE 几乎已经成为共识。从 Stable Diffusion 到 FLUX,再到一系列扩散 Transformer,主流路线高度一致:先用 VAE 压缩视
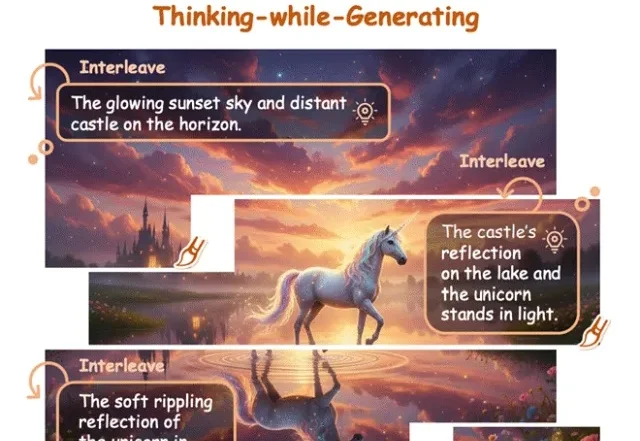
在文生图(Text-to-Image)和视频生成领域,以FLUX.1、Emu3为代表的扩散模型与自回归模型已经能生成极其逼真的画面。
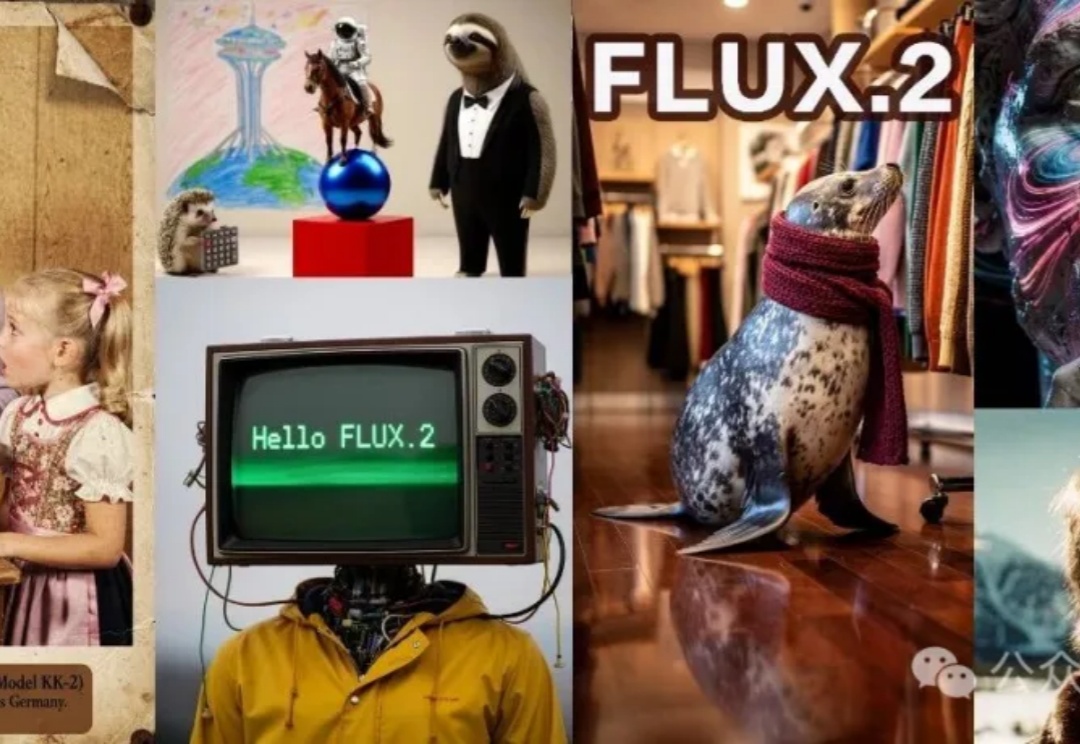
Black Forest Labs的开源视觉模型FLUX.2上新,这是一款专为现实创意工作流程打造,绝非演示噱头的生产力工具,与前代FLUX.1相比,实现了从「会画」到「懂你要画什么」的跃升。
AI绘图圈的朋友们肯定都知道这个产品。FLUX。这次,发布了4款基础模型和1个VAE模型,其中2款是不开源的。分别是Pro和Flex,这两个最强大的模型,是闭源的。而其中2款模型是开源的,一个dev,目前已经开源了。