5.5B激活参数!又一国产多模态模型开源,能自己看网页改代码,免费可用
5.5B激活参数!又一国产多模态模型开源,能自己看网页改代码,免费可用视觉编程成绩超GPT-5.4。
来自主题: AI资讯
7329 点击 2026-09-10 11:12

 搜索
视觉编程成绩超GPT-5.4。
Salesforce AI与UIUC研究人员提出Strong-to-Weak Scaffolding方法,让强模型(Builder AI)为弱模型GPT-5.4-mini自动设计外部Harness工作框架,无需修改参数即可将其在心智理论任务上的平均准确率从0.488提升至最佳0.912,揭示AI4AI的核心机制是将认知结构而非知识从强模型迁移至弱模型。

Claude这次,真把AI编程榜单打出断层了!就在刚刚刷新的MirrorCode排行榜上,Claude Fable 5以64%的绝对成功率再次登顶。 排在第四的GPT-5.5更惨。不仅成绩只有10%,甚至还被自家前辈GPT-5.4按在地上摩擦。
过去一年,Mobile/Phone-use Agent在各类评测榜单上进展很快。
来自 ETH Zurich 的 Florian Tramèr 团队在最新论文中抛出了一个出乎意料的问题:如果 AI"看到" 的图,根本不是你肉眼看到的那张,会发生什么样的后果呢?他们把这种现象称作 AI 权威清洗(AI Authority Laundering)。
今天,蚂蚁百灵开源旗舰级思考模型Ring-2.6-1T,该模型于5月9日发布,引入了可调节的Reasoning Effort机制,支持high与xhigh两种推理强度,开发者可以根据任务特性动态分配推理资源。
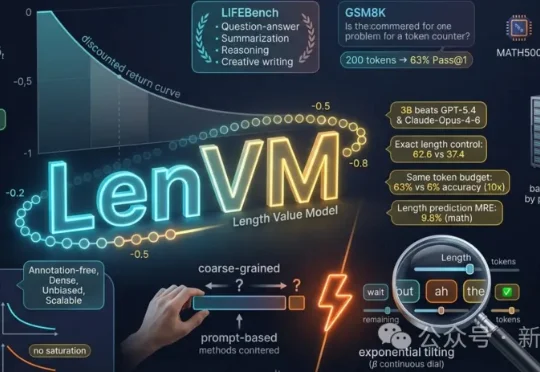
LenVM将长度建模提升到token级别,开辟可扩展价值预训练的新维度——3B开源模型精确长度控制全面击败GPT-5.4、Claude-Opus-4-6等顶级闭源模型;相同token预算下推理准确率提升10倍(63% vs 6%);沿模型规模、数据量、采样数三轴无饱和scaling的value pretraining
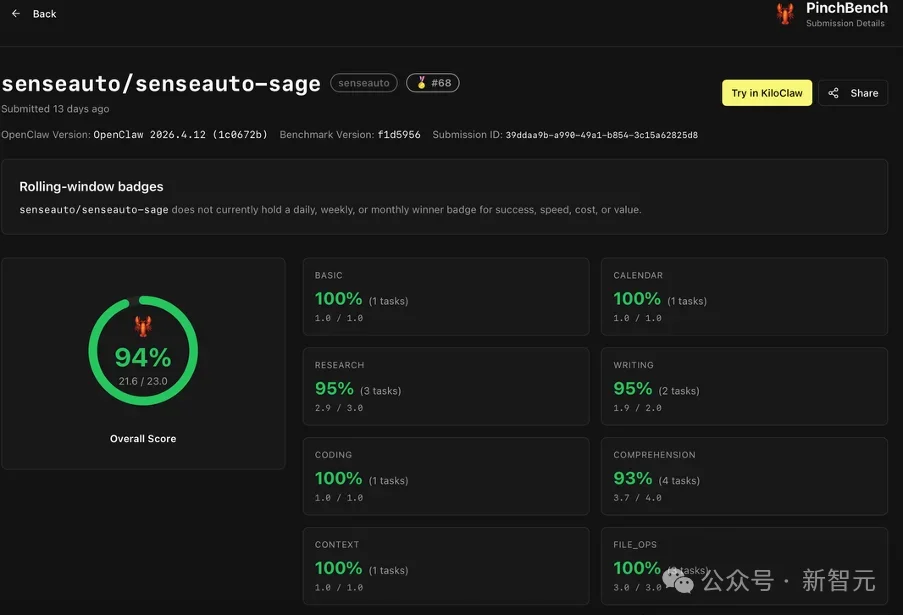
一个3B激活参数的端侧模型,在全球Agent权威评测中,以94%任务完成率,超越了Claude、GPT-5.4、Gemini等国际主流云侧和端侧大模型。商汤绝影Sage来了,它不是「更聪明的语音助手「,而是第一个真正能在车里「办成复杂事「的智能体基座。
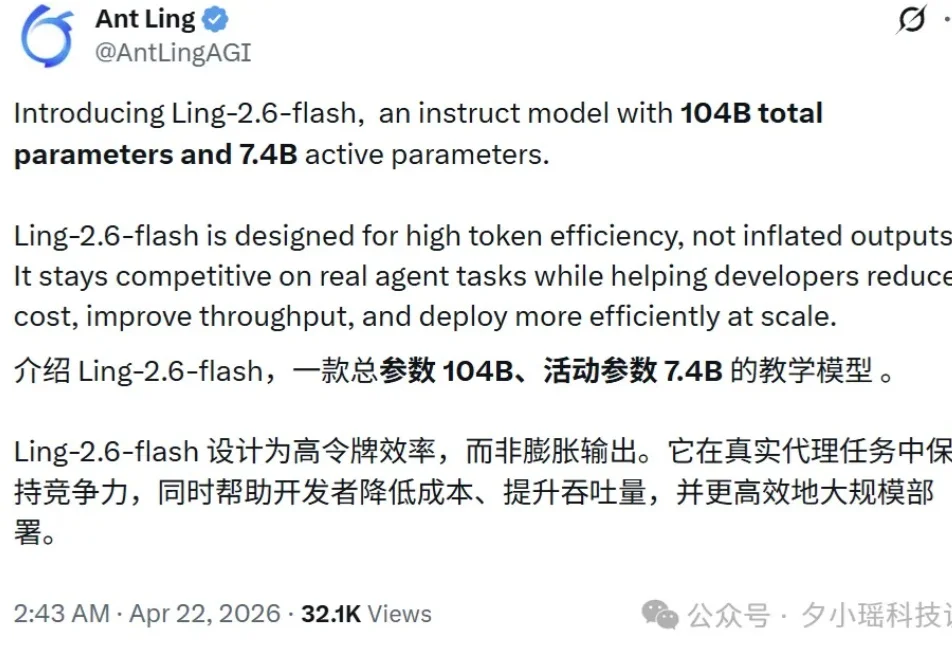
用AI跑批量任务的人,手里基本都有一个干活的模型,不是最聪明,但要快、要便宜,稳定不出岔子。
就在刚刚,Agents SDK迎来一次彻底的架构重写。原生harness、原生沙盒、Codex级的文件系统工具,外加七家头部沙盒厂商一键接入。3月初,GPT-5.4带着原生computer use(计算机使用)高调登场时,开发者就已经吐槽过一件事。